Python Spark SQL 入門
Mark Plutowski
Data Scientist
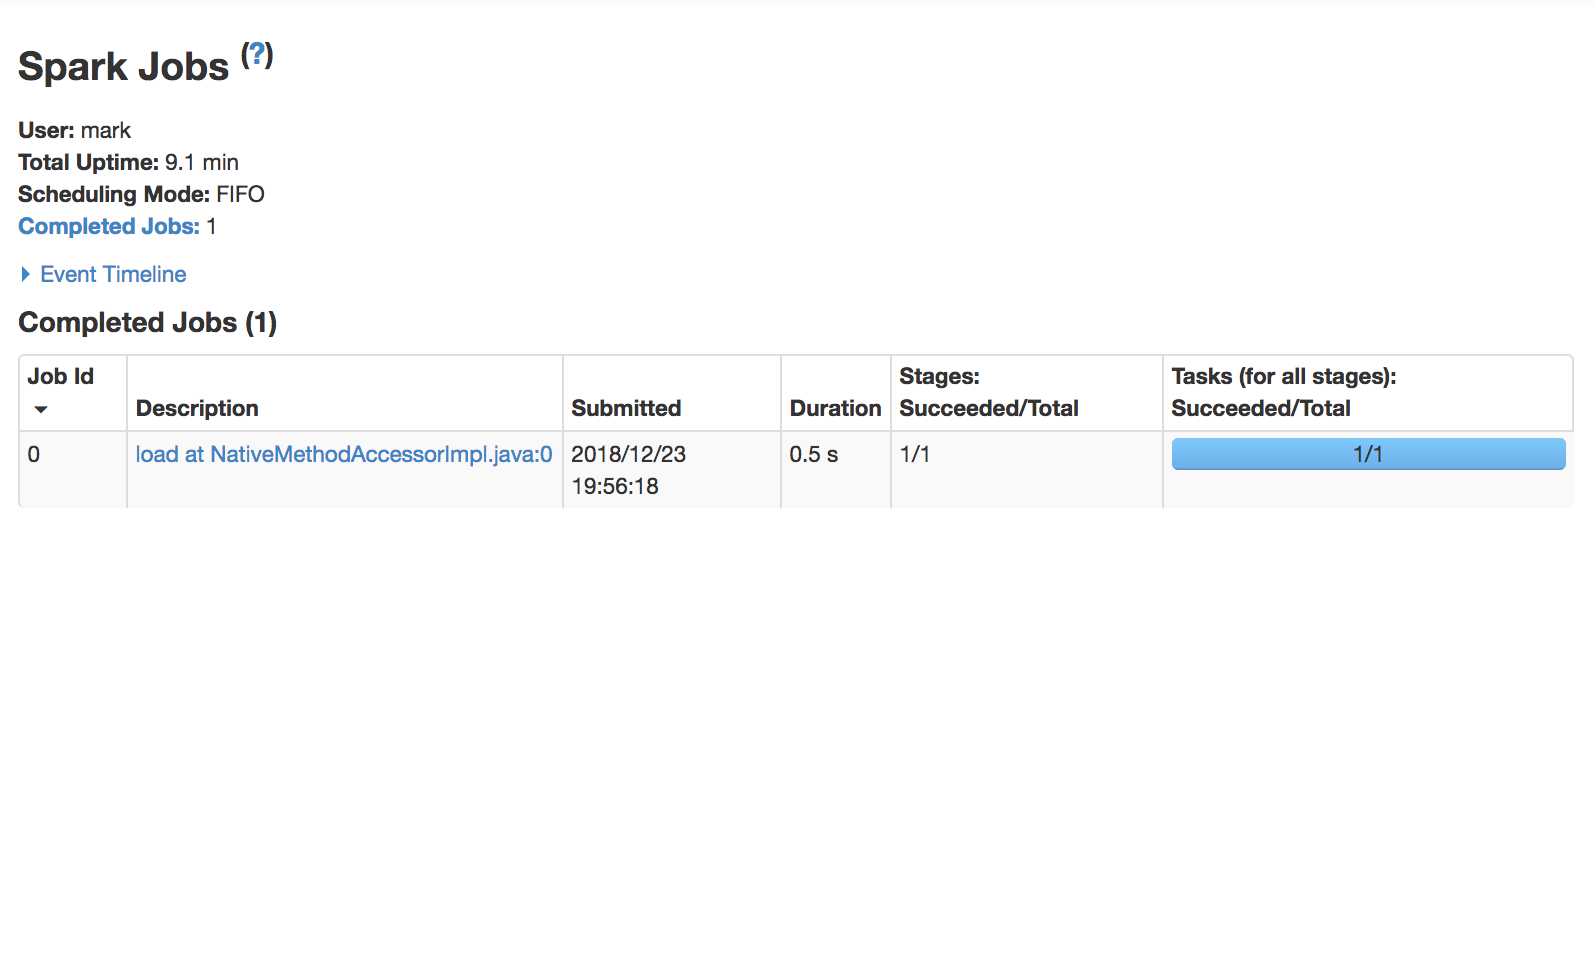
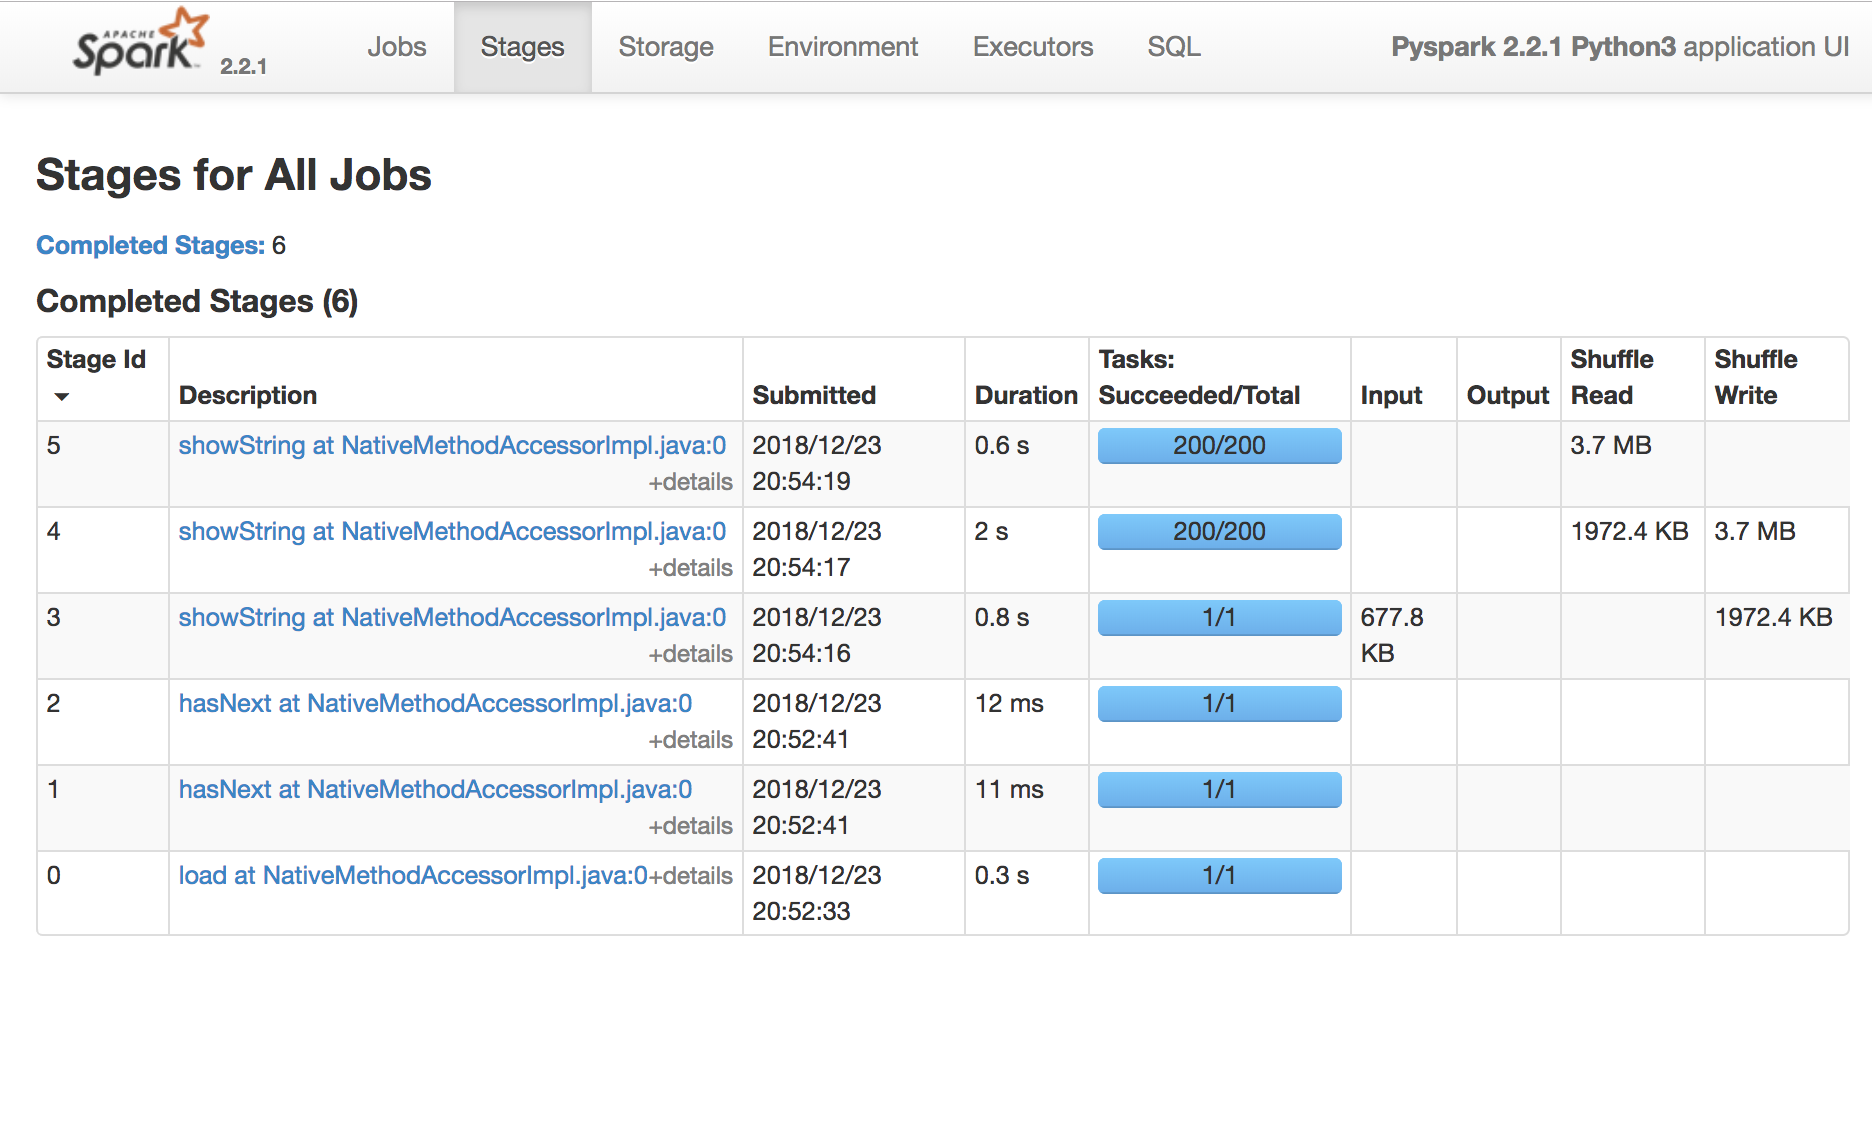
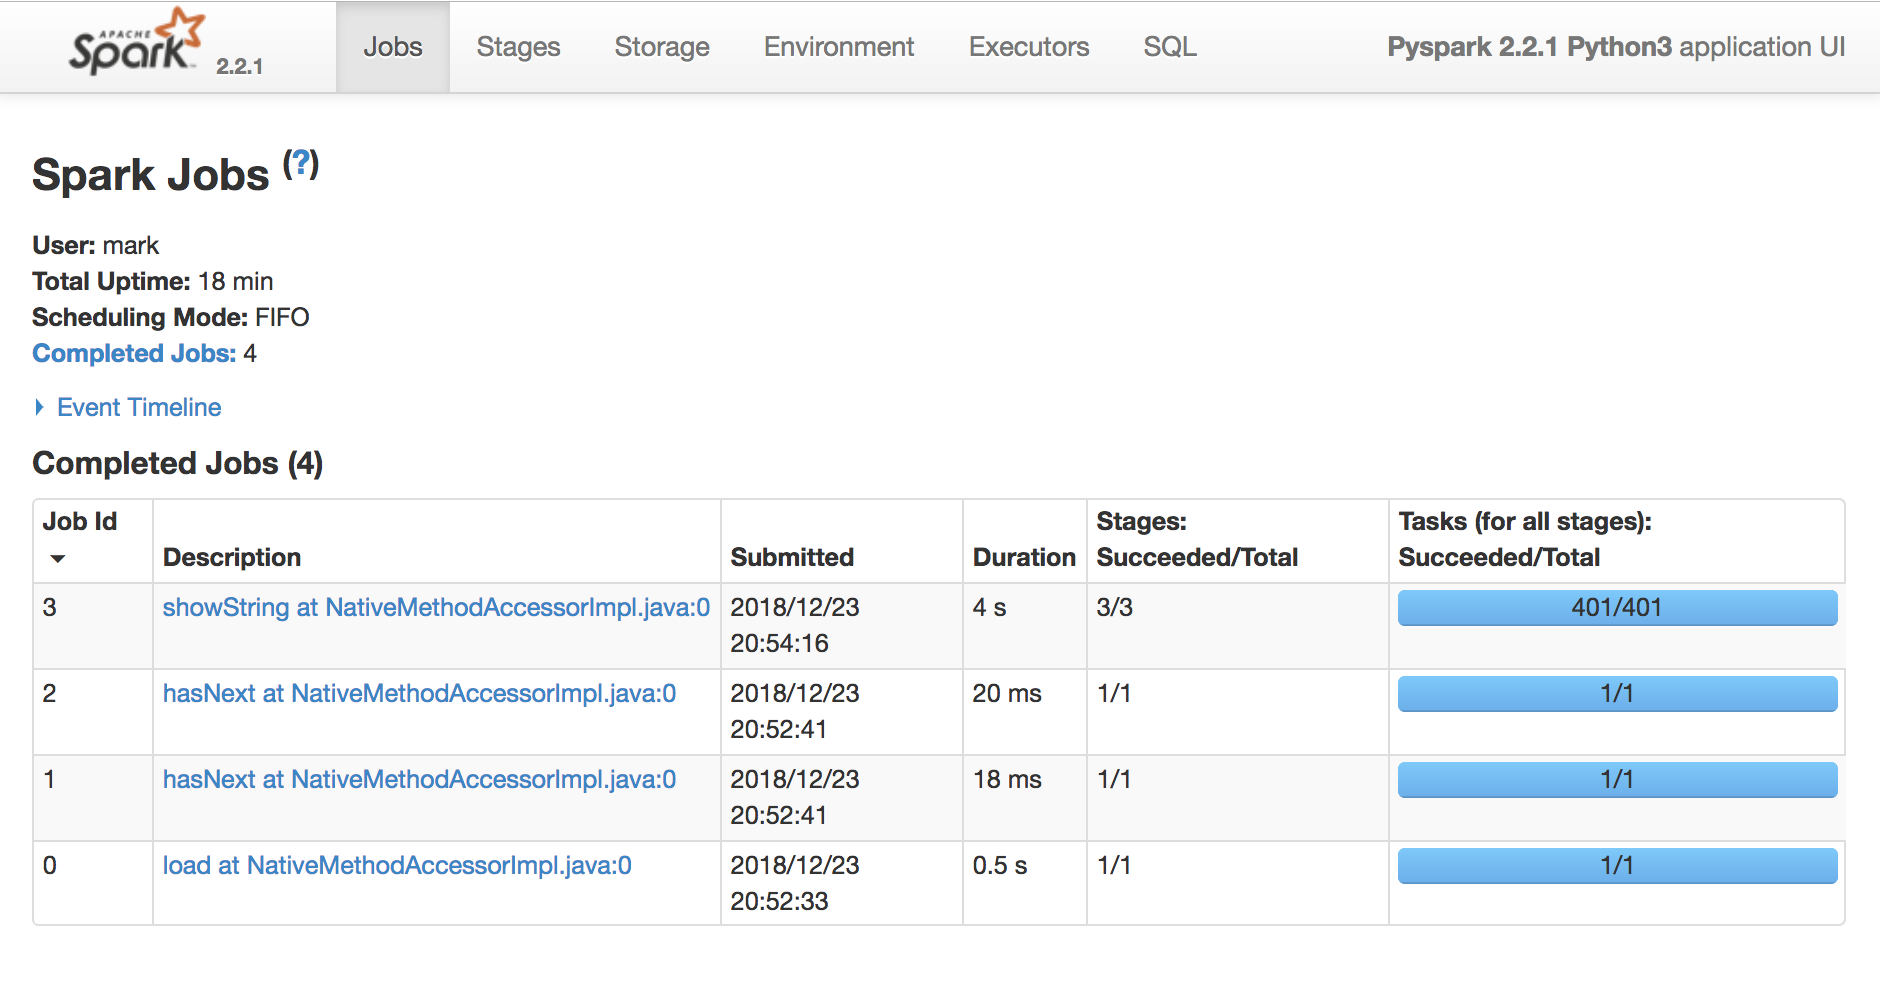
Spark Task:在單一 CPU 上執行的最小執行單位。
Spark Stage:一組並行執行相同計算的任務,通常各自處理資料的不同子集。
Spark Job:由 action 觸發的計算,會切分為一個或多個 stage。


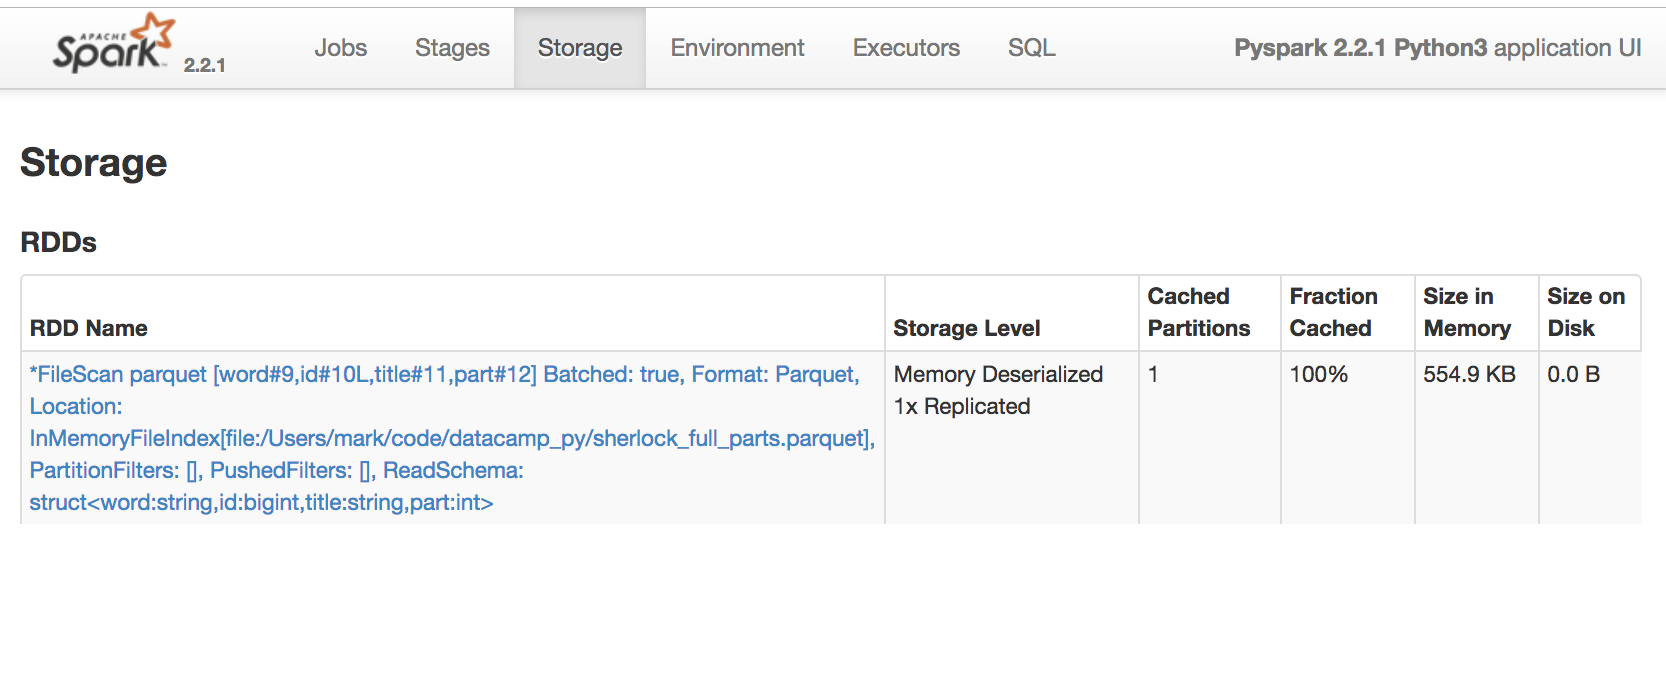
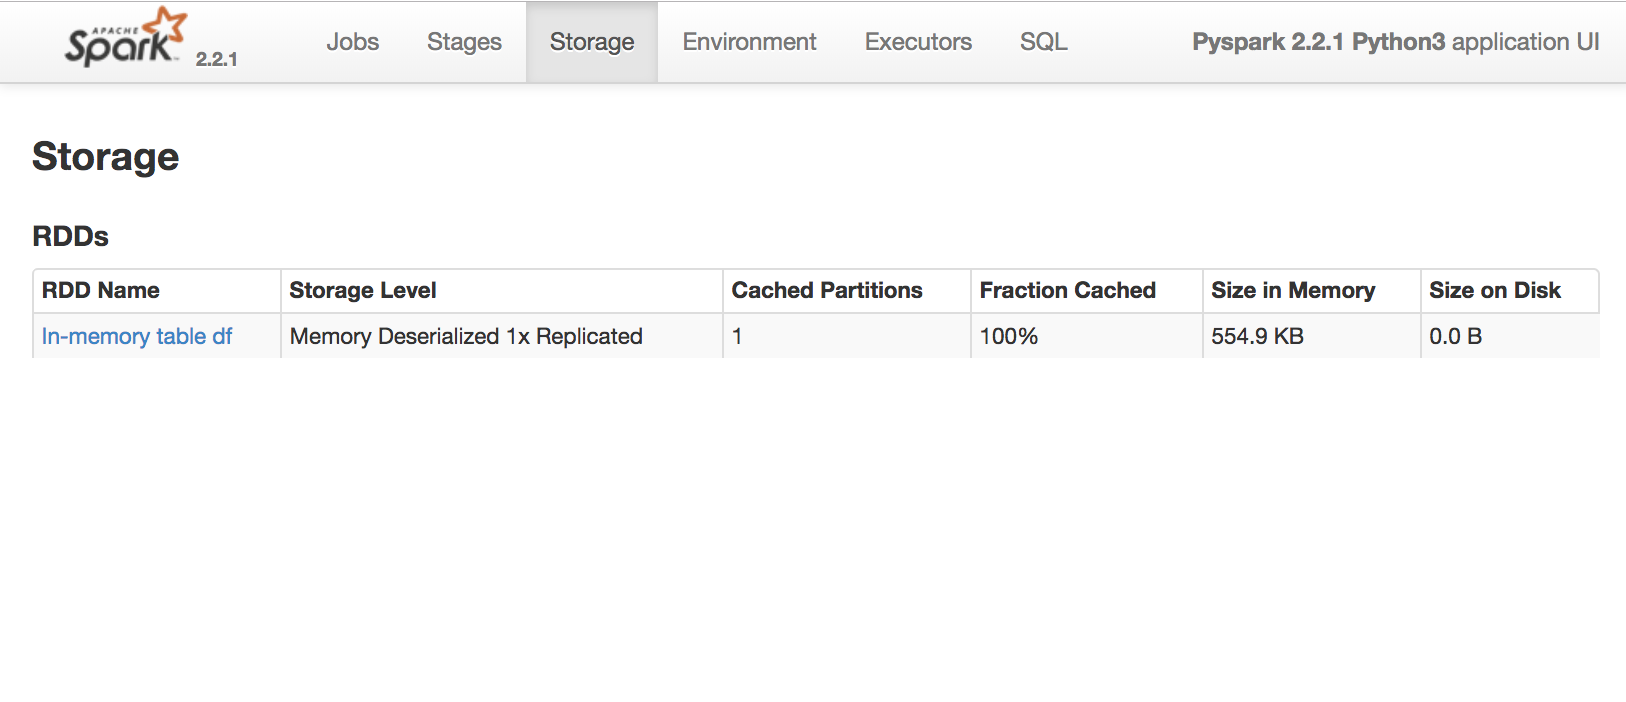
spark.catalog.cacheTable('table1')spark.catalog.uncacheTable('table1')spark.catalog.isCached('table1')spark.catalog.dropTempView('table1')spark.catalog.listTables()
[Table(name='text', database=None, description=None, tableType='TEMPORARY', isTemporary=True)]


顯示資料分割區的位置:
query3agg = """ SELECT w1, w2, w3, COUNT(*) as count FROM ( SELECT word AS w1, LEAD(word,1) OVER(PARTITION BY part ORDER BY id ) AS w2, LEAD(word,2) OVER(PARTITION BY part ORDER BY id ) AS w3 FROM df ) GROUP BY w1, w2, w3 ORDER BY count DESC """spark.sql(query3agg).show()


Python Spark SQL 入門