探索性資料分析

端到端機器學習

Joshua Stapleton

Machine Learning Engineer

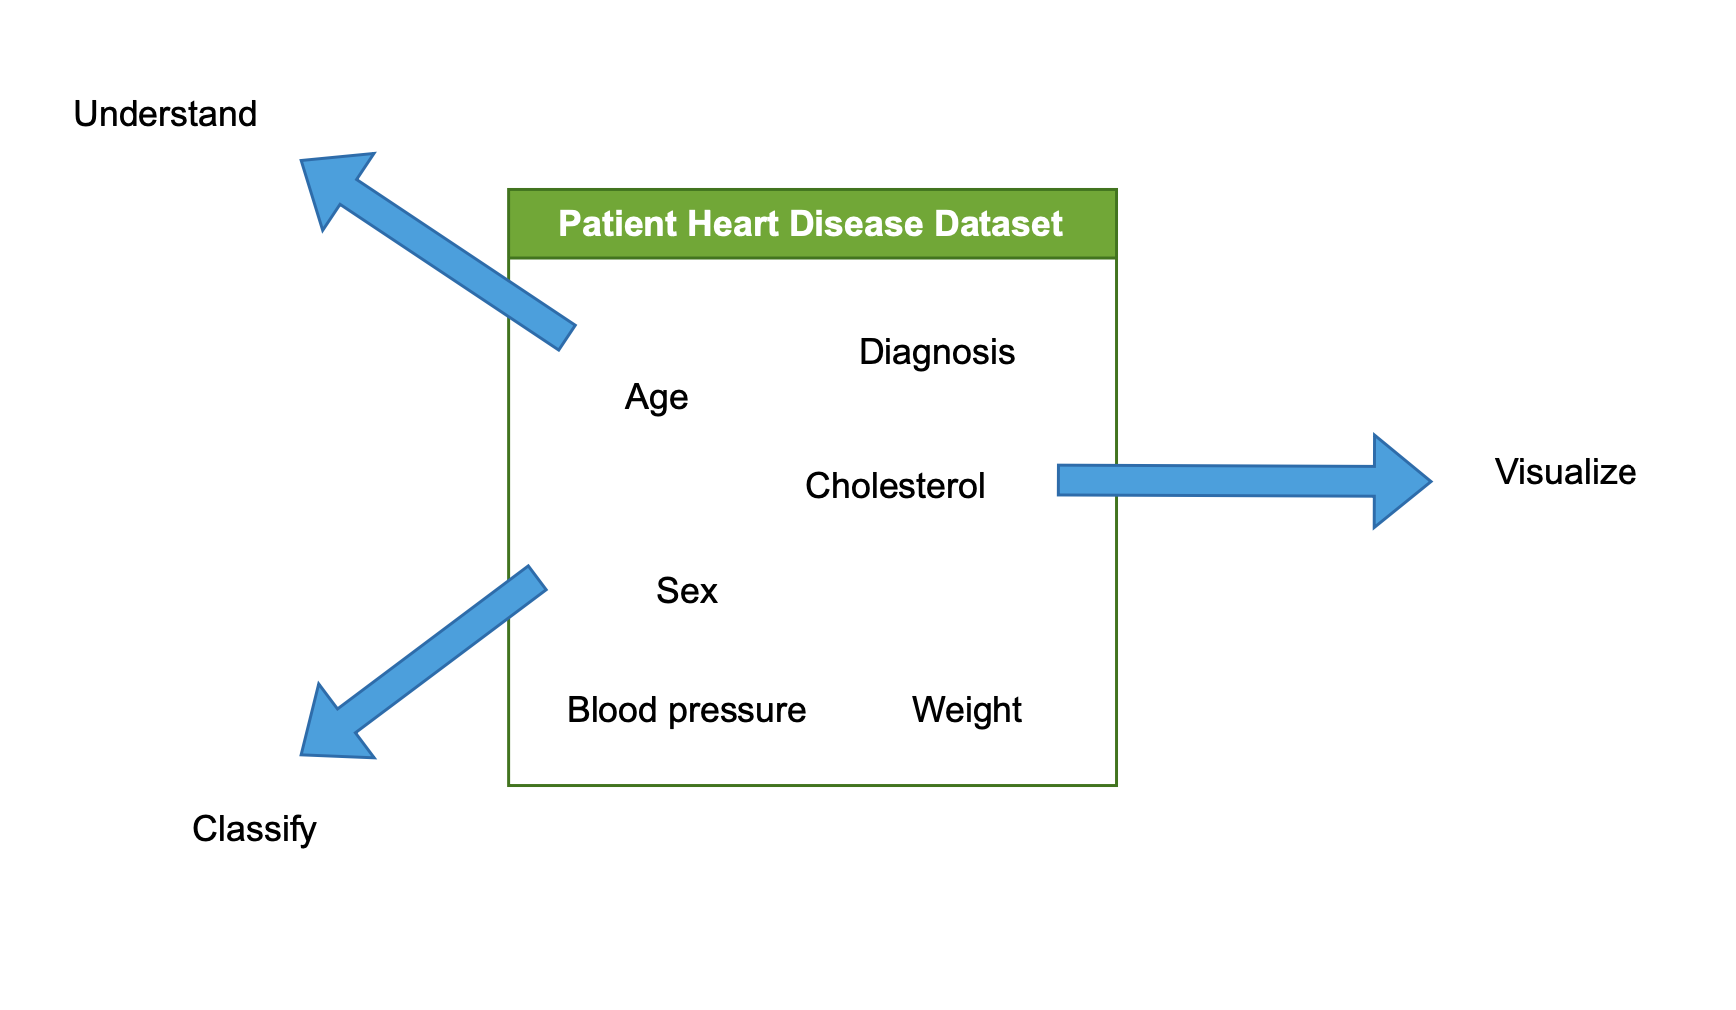
EDA 流程

  • 檢視並分析資料集
  • 理解資料集
  • 視覺化資料集
  • 描述/分類資料集

一張圖示,顯示對病人心臟病資料集進行 EDA 的各元件

端到端機器學習

理解資料

df.head()

  • 顯示資料集的前幾列
  • 提供資料結構快照
# Print the first 5 rows
print(heart_disease_df.head())
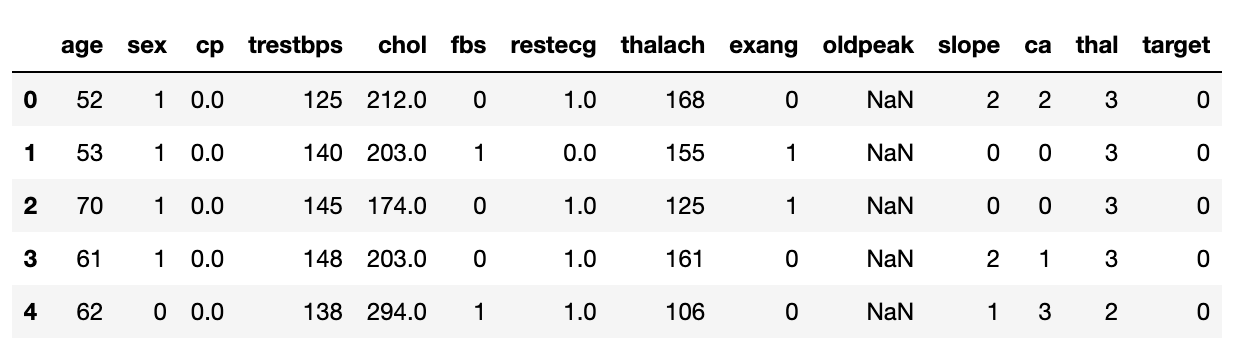
我們的心臟病 DataFrame 前 5 列。也就是呼叫 df.head() 的結果。

df.info()

  • 摘要各特徵
  • 顯示非空筆數與特徵型別
# Print out details
print(heart_disease_df.info())
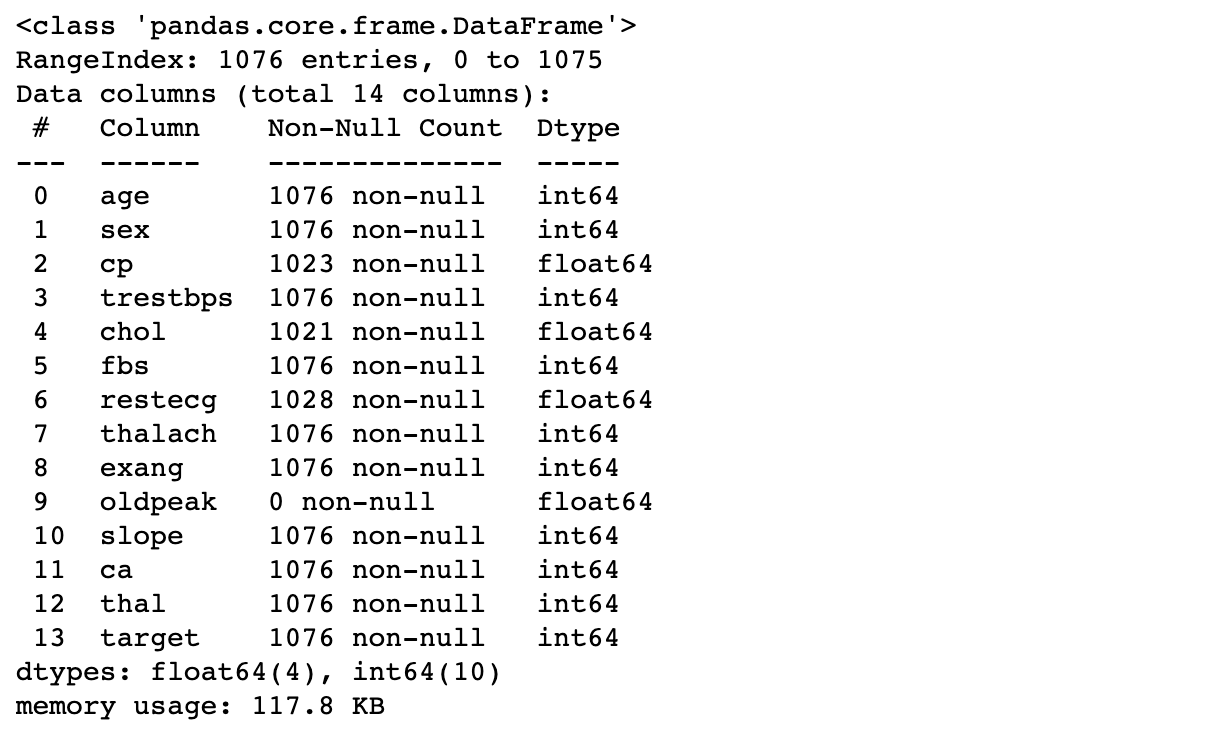
我們的心臟病 DataFrame 的摘要資訊。也就是呼叫 df.info() 的結果。

端到端機器學習

類別(不)平衡

df.value_counts()

  • 計數各類別的唯一出現次數
  • 類別:心臟病是否存在(二元 1/0)
  • 建模很重要
# print the class balance
print(heart_disease_df['target'].value_counts(normalize=True))
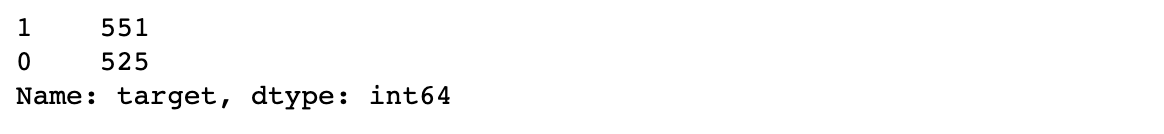
我們的心臟病 DataFrame 目標欄位的類別比例。也就是對目標欄位呼叫 .value_counts() 的結果。

端到端機器學習

遺漏值

  • 可能導致錯誤
  • 結果失真、有偏

使用 df.isnull()

  • 檢查空值/空白/遺漏值
  • 可用於單一或多個欄位

用法

# check whether all values in a column are null
print(heart_disease_df['oldpeak'].isnull().all())
True
端到端機器學習

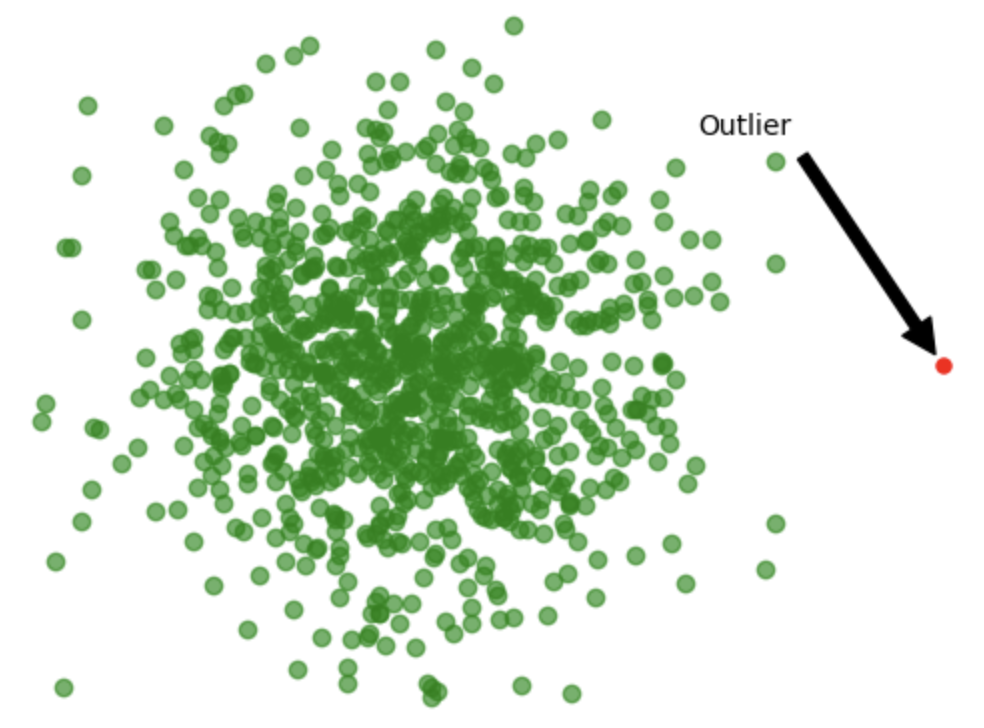
離群值

  • 異常值

    • 量測錯誤
    • 資料輸入錯誤
    • 罕見事件
  • 可能扭曲模型表現

    • 模型學到極端值
    • 無法反映整體趨勢
  • 有時也有用:

    • 罕見值
    • 偵測方式:盒鬚圖或 IQR

顯示離群值的視覺化。

端到端機器學習

視覺化資料

視覺化可顯示:

  • 整體趨勢
  • 遺漏值與離群值

其他視覺化類型:

  • 核密度估計
  • 經驗累積分佈
  • 雙變量分佈
df['age'].plot(kind='hist')
plt.xlabel('Age')
plt.ylabel('Frequency')
plt.show()
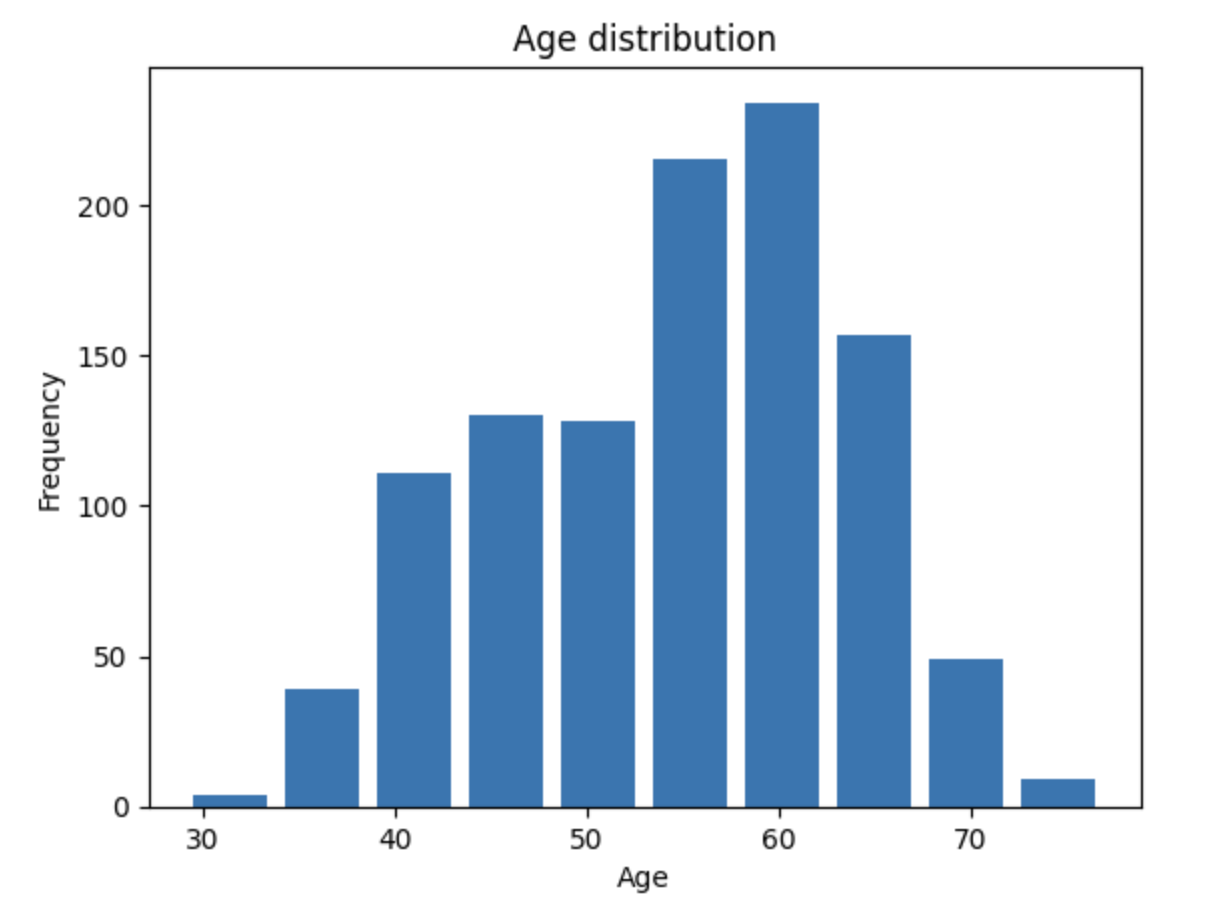
顯示資料集中年齡分佈的視覺化。

1 https://seaborn.pydata.org/tutorial/distributions.html, https://app.datacamp.com/learn/courses/intermediate-data-visualization-with-seaborn
端到端機器學習

EDA 目標

理解資料

  • 有沒有可見的模式?
  • 例如:男性心臟病率是否較高?

偵測離群值

  • 是否有資料超出可接受範圍?
  • 是否有錯誤或遺漏值?

提出假設

  • 你應該從資料中預期看到什麼?

檢驗假設

  • 預期是否符合實際?
端到端機器學習

一起來練習吧!

端到端機器學習

Preparing Video For Download...