特徵工程與選擇

端到端機器學習

Joshua Stapleton

Machine Learning Engineer

特徵工程

建立特徵

  • 簡化問題
  • 提升模型效率

技巧

  • 修改現有特徵
  • 設計新特徵

好處

  • 更易部署、維護、訓練
  • 提升可解釋性

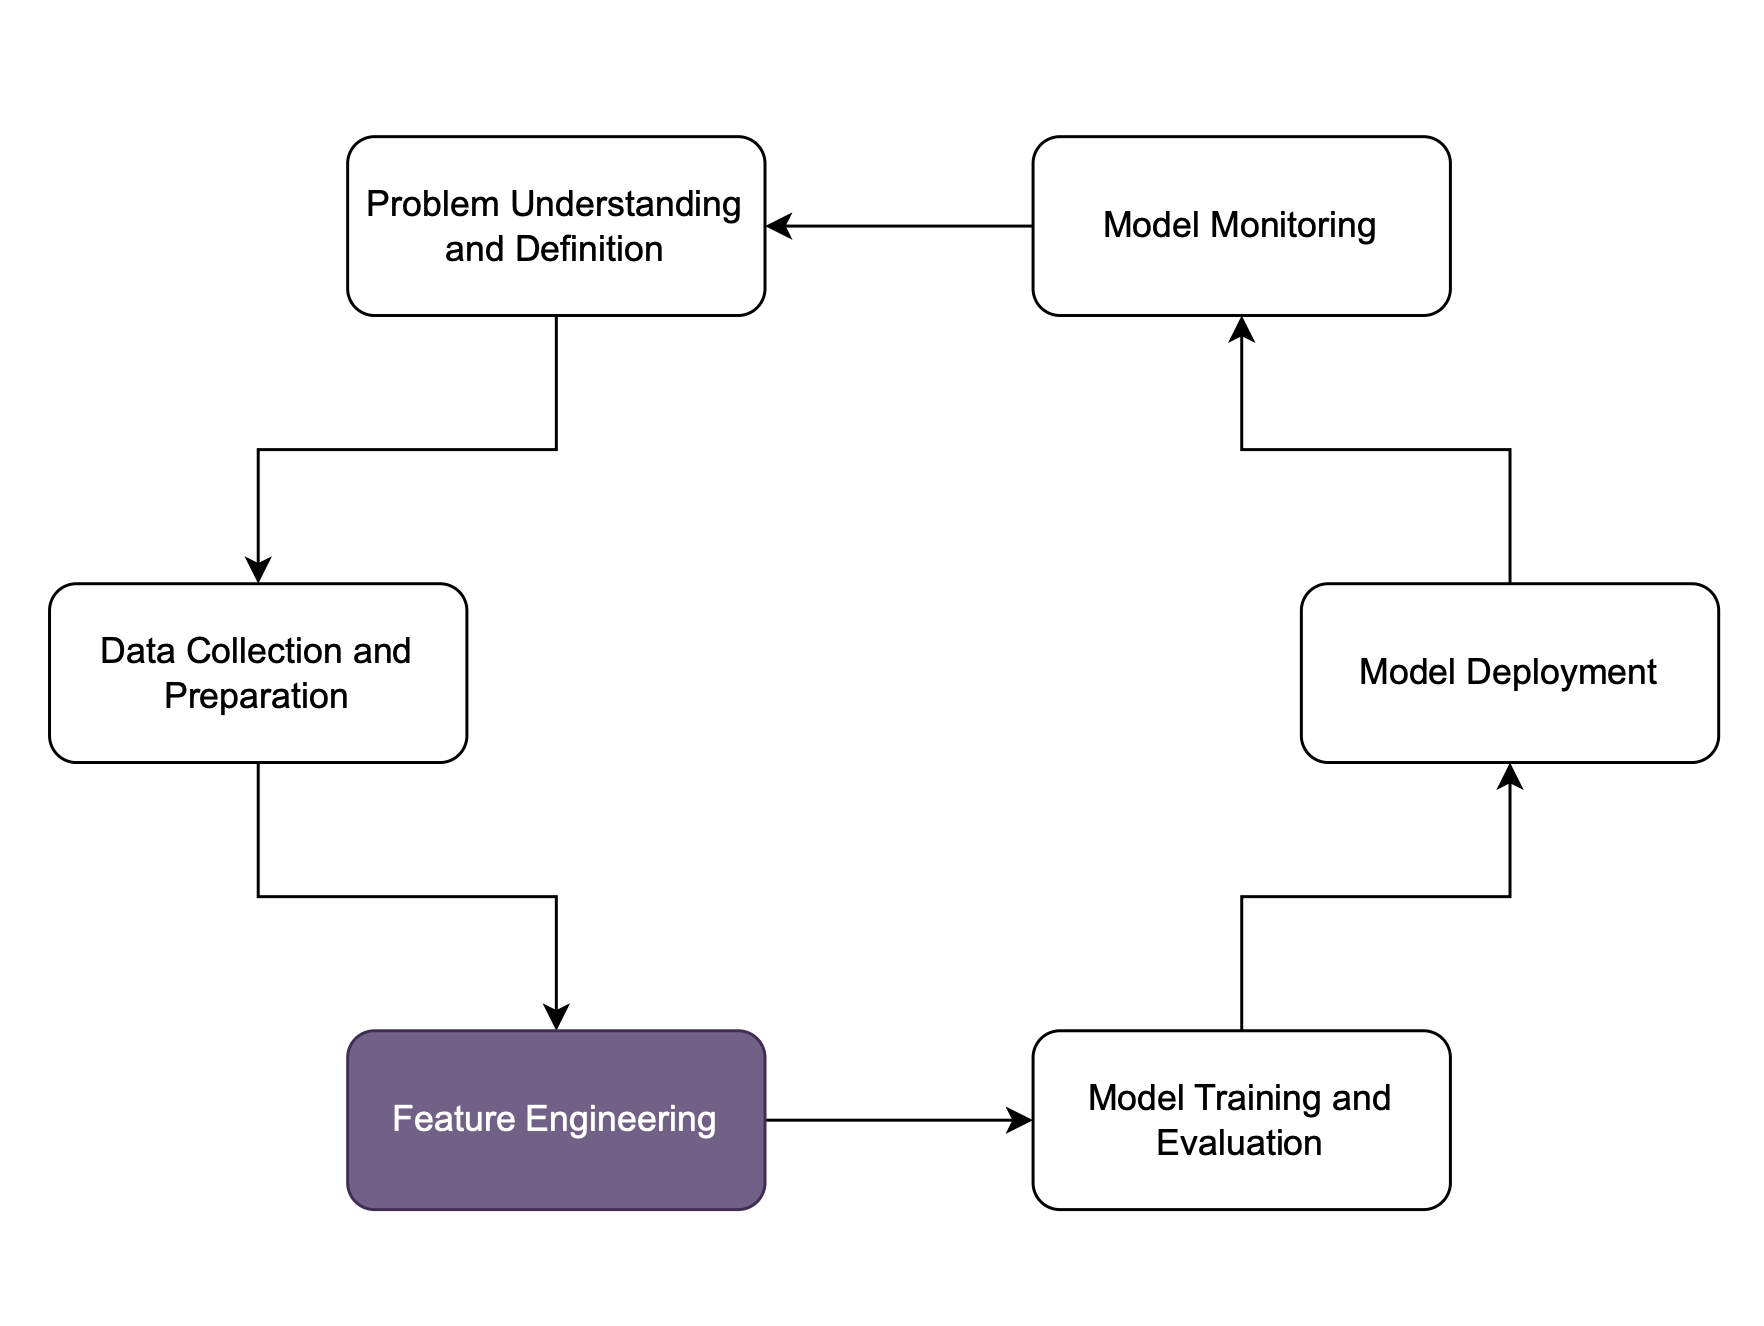
機器學習生命週期目前階段:特徵工程

端到端機器學習

正規化(Normalization)

  • 將數值特徵縮放到 [0, 1]
  • 當特徵尺度/範圍不一致時很有幫助。
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import Normalizer

# Split the data
X_train, X_test = train_test_split(df, test_size=0.2, random_state=42)
# Createnormalizer object, fit on training data, normalize, and transform test set
norm = Normalizer()
X_train_norm = norm.fit_transform(X_train)
X_test_norm = norm.transform(X_test)
端到端機器學習

標準化(Standardization)

  • 將資料縮放為 mean = 0、variance = 1
  • 對假設平均與變異相近的演算法有利
from sklearn.preprocessing import StandardScaler

# Split the data
X_train, X_test = train_test_split(df, test_size=0.2, random_state=42)
# Create a scaler object and fit training data to standardize it
sc = StandardScaler()
X_train_stzd = sc.fit_transform(X_train)
# Only standardize the test data
X_test_stzd = sc.transform(X_test)
端到端機器學習

好的特徵要素是什麼?

  • 使用相關特徵
  • 看診當天的天氣不應影響診斷


暴風雨天氣的圖片,說明特徵選擇中的相關性原則

  • 使用不相似(正交)的特徵
  • 「以月為單位的年齡」與「以年為單位的年齡」同時存在並無助益


示意圖:特徵選擇中的正交性原則

端到端機器學習

sklearn.feature_selection


from sklearn.ensemble import RandomForestClassifier
from sklearn.feature_selection import SelectFromModel
from sklearn.model_selection import train_test_split

# Splitting data into train and test subsets first to avoid data leakage X_train, X_test, y_train, y_test = train_test_split( heart_disease_df_X, heart_disease_df_y, test_size=0.2, random_state=42)
端到端機器學習

sklearn.feature_selection(續)


# Define and fit the random forest model
rf = RandomForestClassifier(n_jobs=-1, class_weight='balanced', max_depth=5)
rf.fit(X_train, y_train)

# Define and run feature selection model = SelectFromModel(rf, prefit=True) features_bool = model.get_support() features = heart_disease_df.columns[features_bool]
端到端機器學習

一起來練習吧!

端到端機器學習

Preparing Video For Download...