協調服務與狀態管理
在 AWS 上開發應用程式

Ricardo Sueiras
Principal Technologist
服務協調
- 多個服務需協同完成一個工作流程。
- 需要一套協調策略。
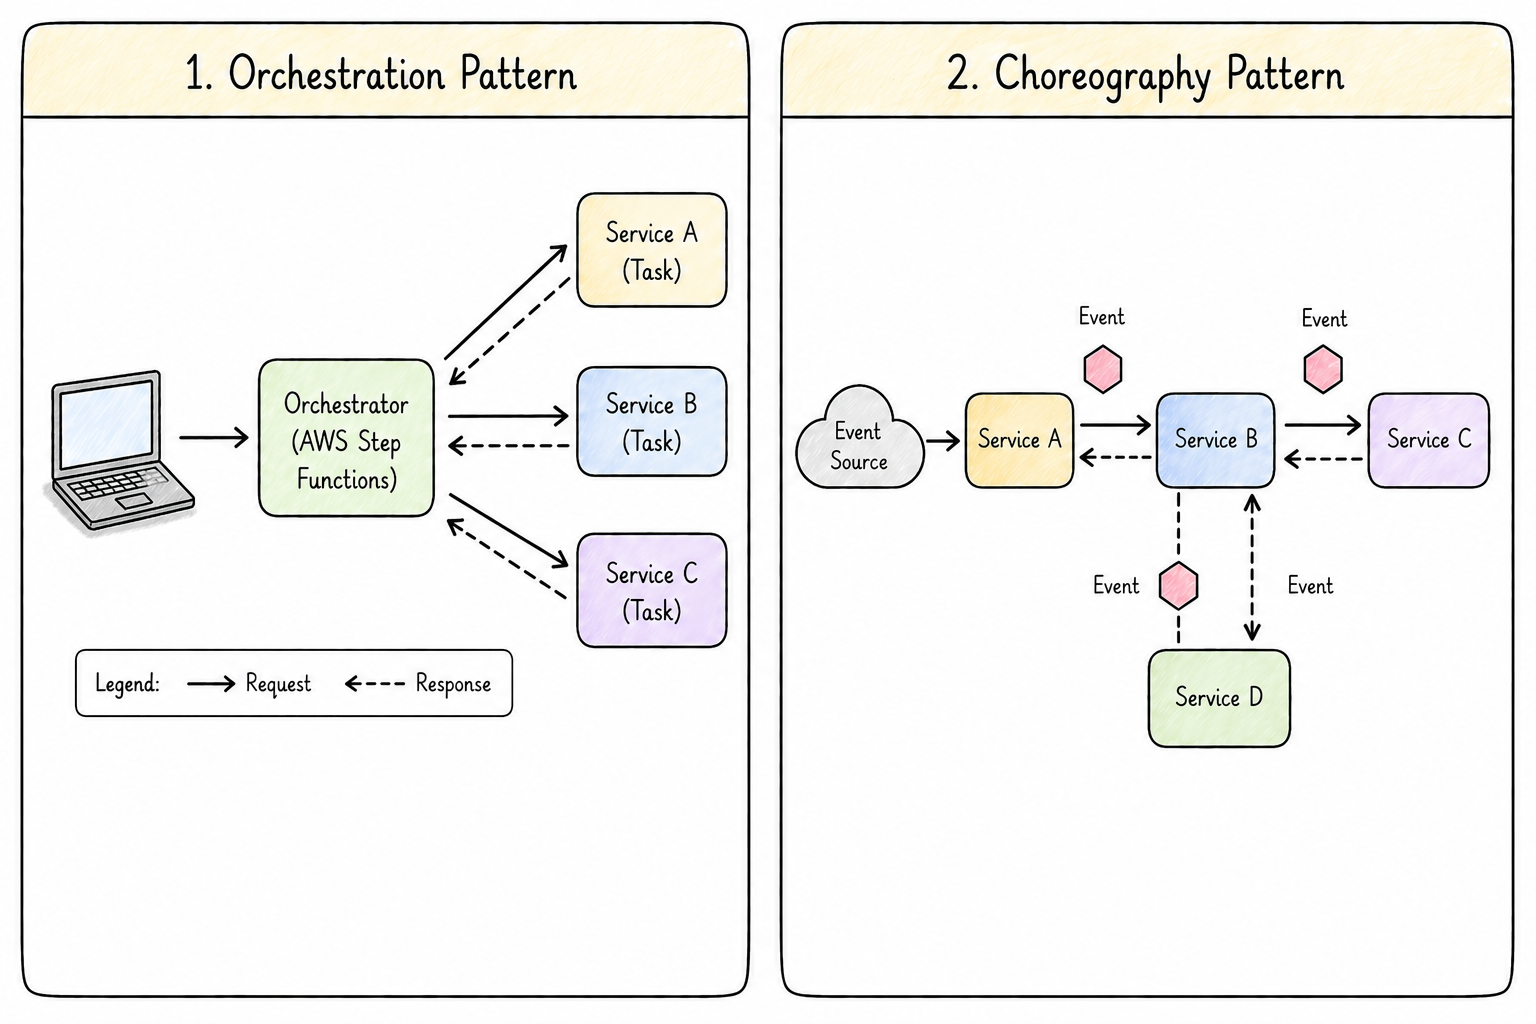
- 兩種做法:orchestration 與 choreography。
Orchestration
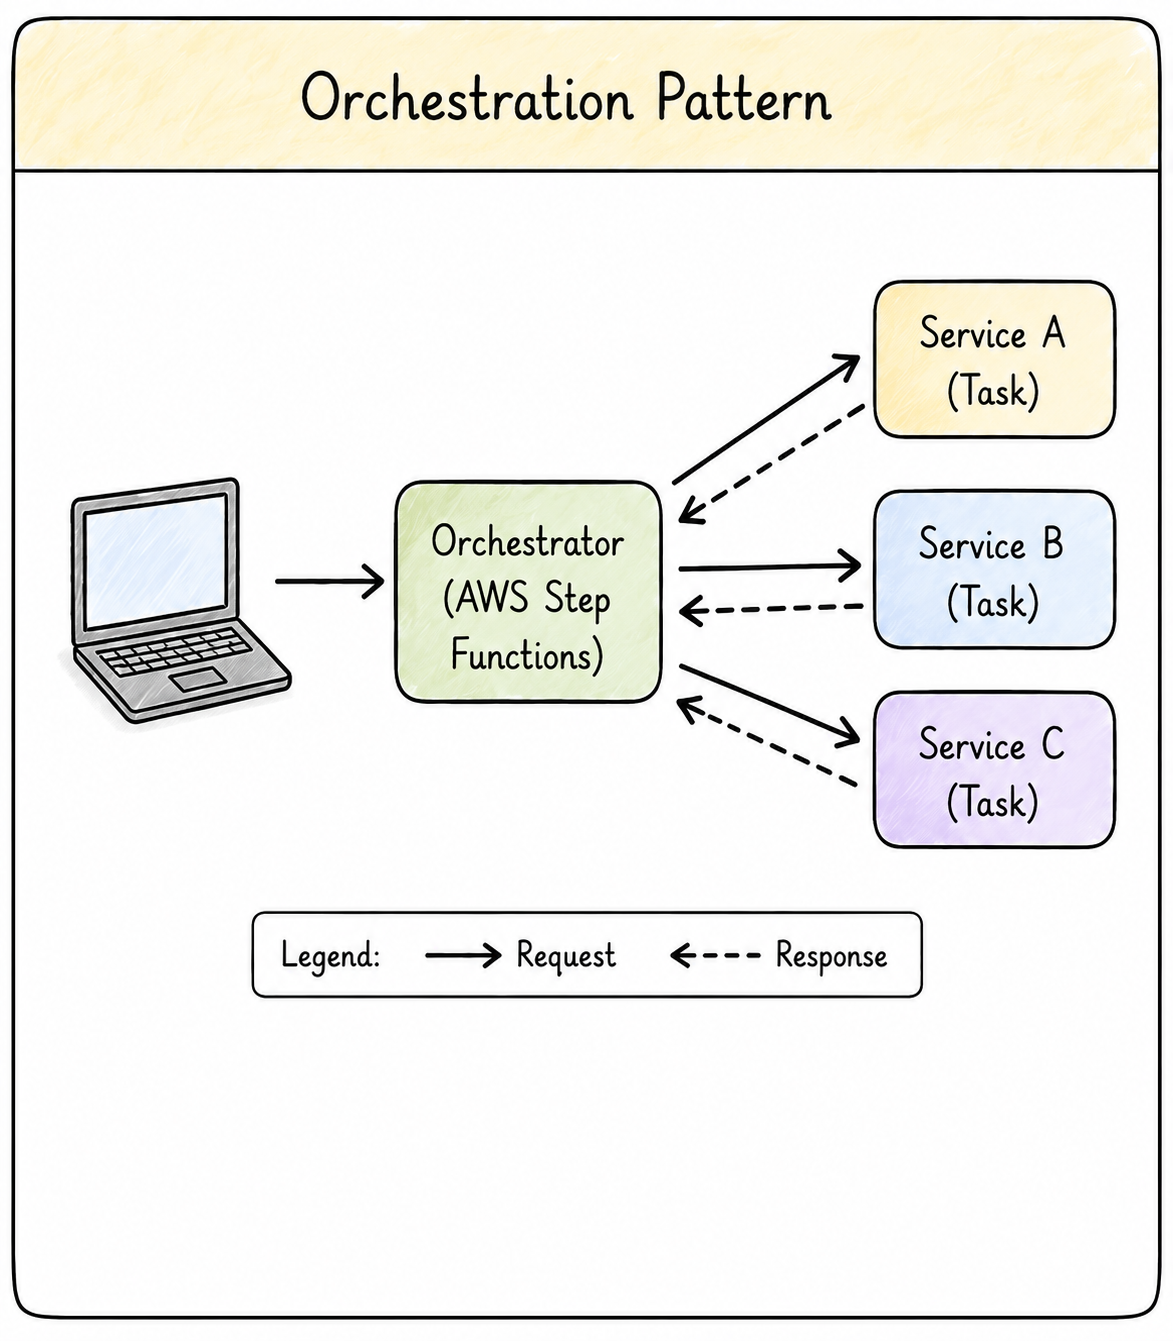
- 中央 orchestrator 協調工作流程。
- Orchestrator 控制執行順序並決定下一個服務。
- 適合重試、條件邏輯與錯誤處理。
- 在 AWS:用 Step Functions 貫穿 Lambda、ECS、DynamoDB。
Orchestration
- 將流程邏輯集中於一處,便於偵錯與監控。
- 取捨:引入中央相依。
Choreography
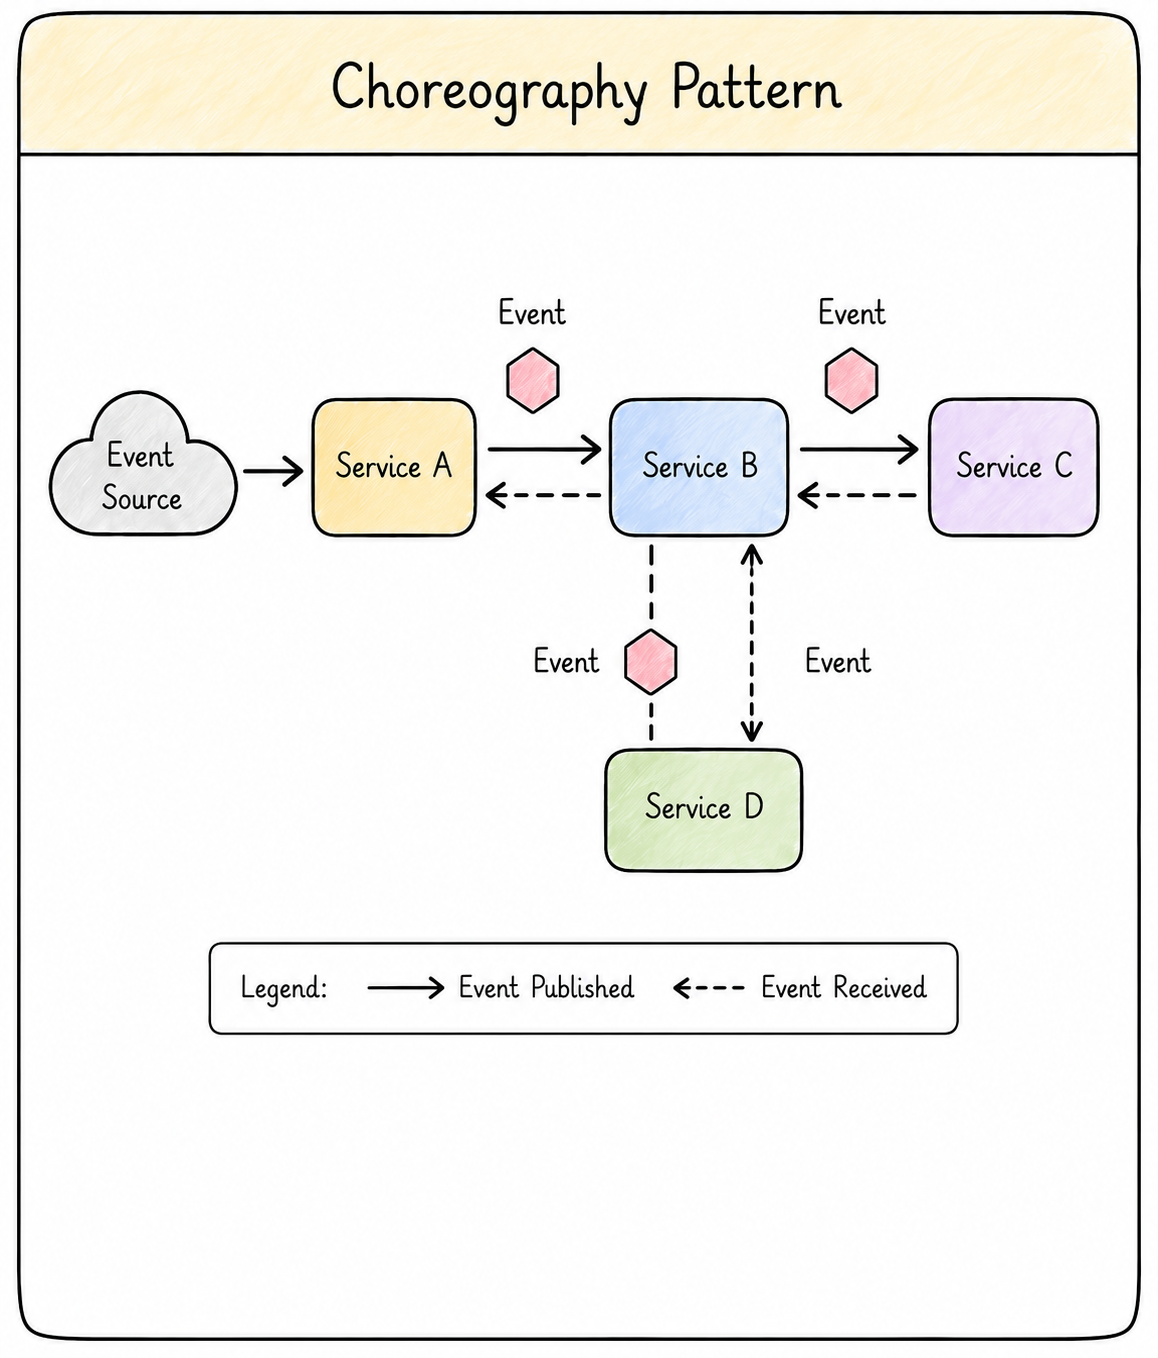
- 沒有中央控制器。
- 服務各自對事件做出反應。
- 各服務監聽相關事件並執行其工作。
- 不需任何服務了解完整流程。
- 更鬆耦合、可擴展性更佳。
Choreography
- 在 AWS:EventBridge、SNS、SQS。
- 高度可擴展。
- 取捨:流程成長後較難理解與偵錯。
事件驅動架構
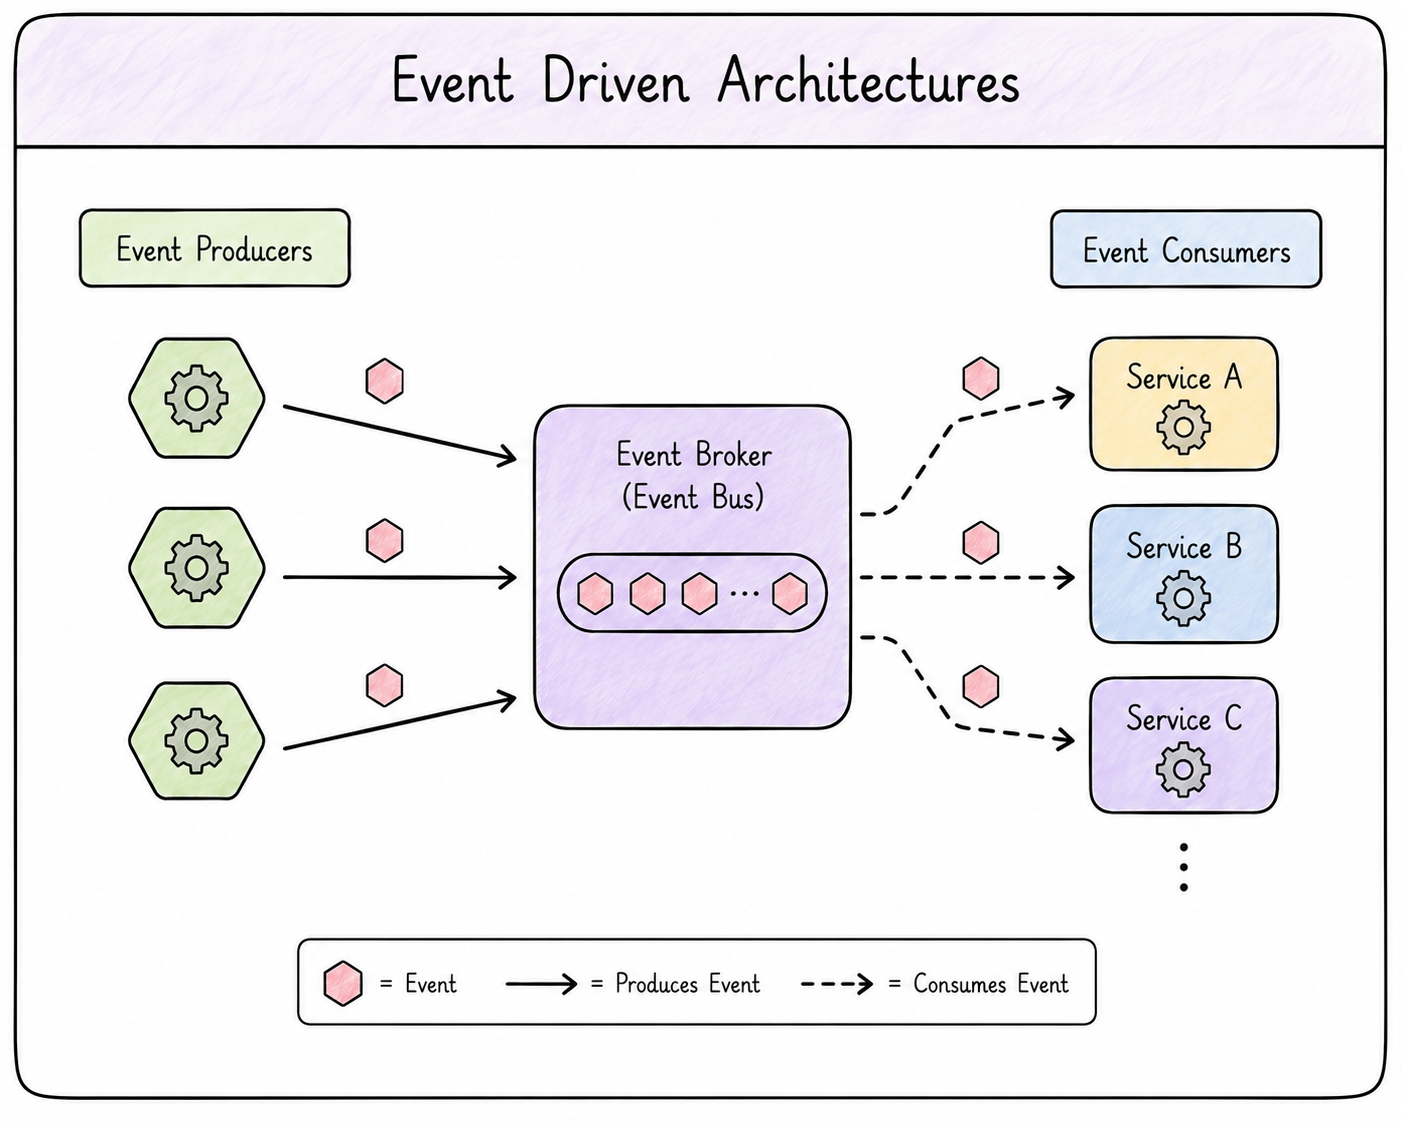
- 服務以產生與消費事件的方式通信。
- 促進服務之間的鬆耦合。
- 促進高可擴展性。
- 支援事件的平行處理。
- 新服務可訂閱而不需修改現有服務。
事件驅動架構
- 實作 EDA 的取捨:
- 以最終一致性為設計目標。
- 實作冪等性。
- 失敗處理更複雜。
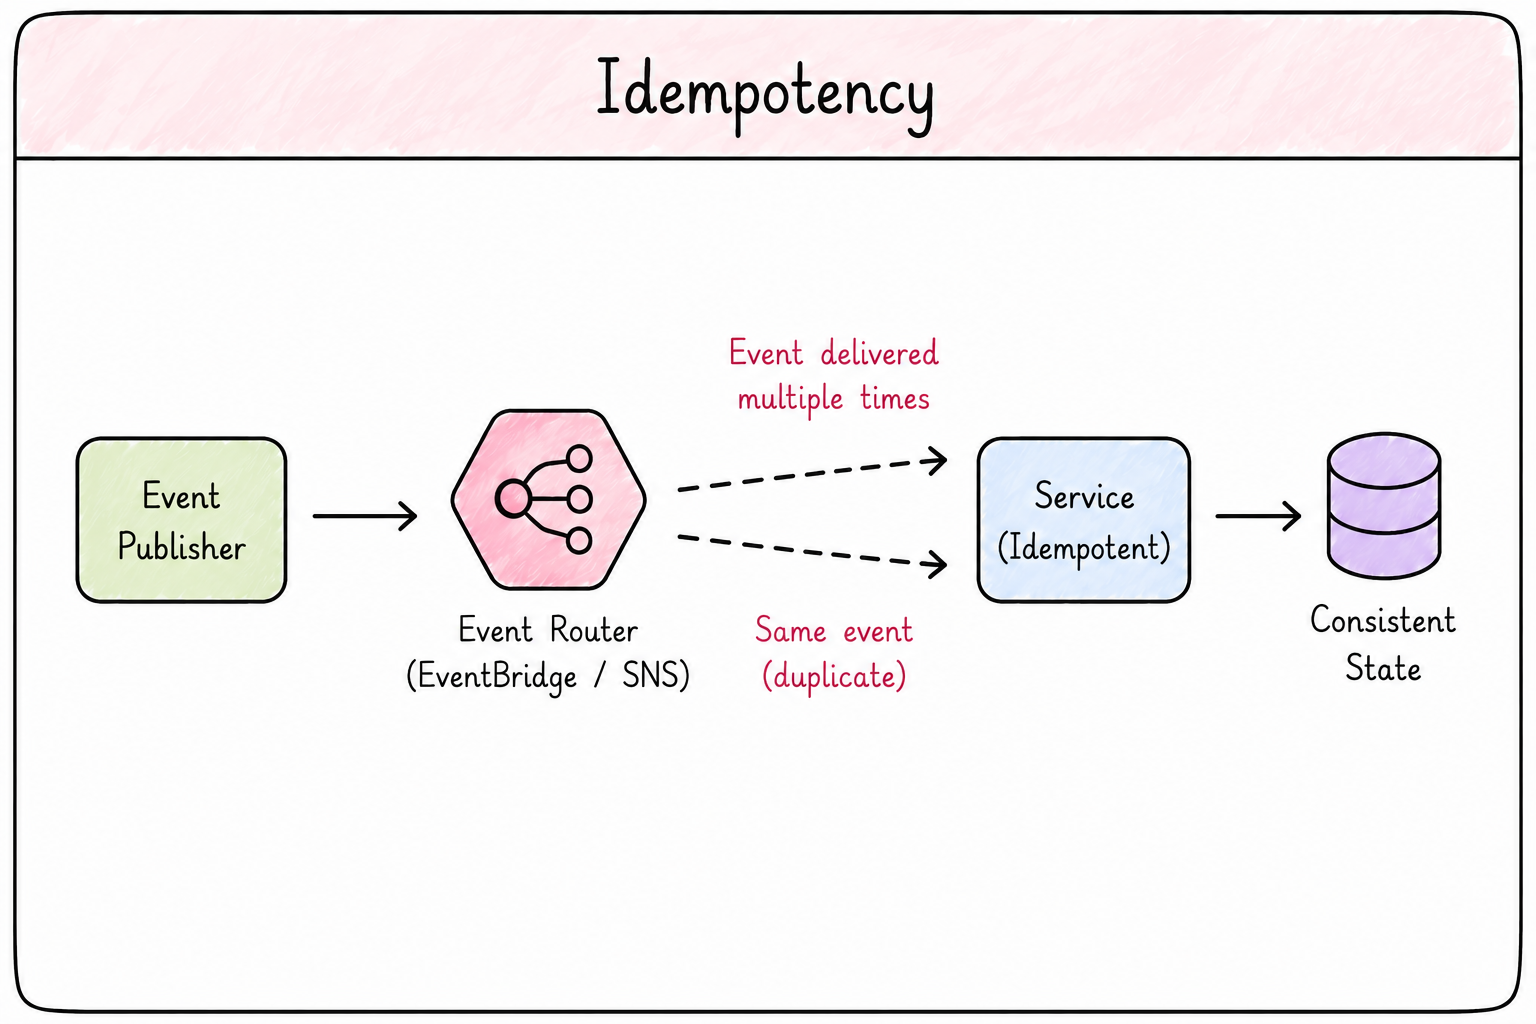
冪等性(Idempotency)
- 相同操作執行多次,結果不變。
- 非同步與事件驅動系統中的關鍵設計原則。
- 分散式系統可能送達重複事件(重試、網路故障、重處理)。
- 維持系統正確性與可靠性。
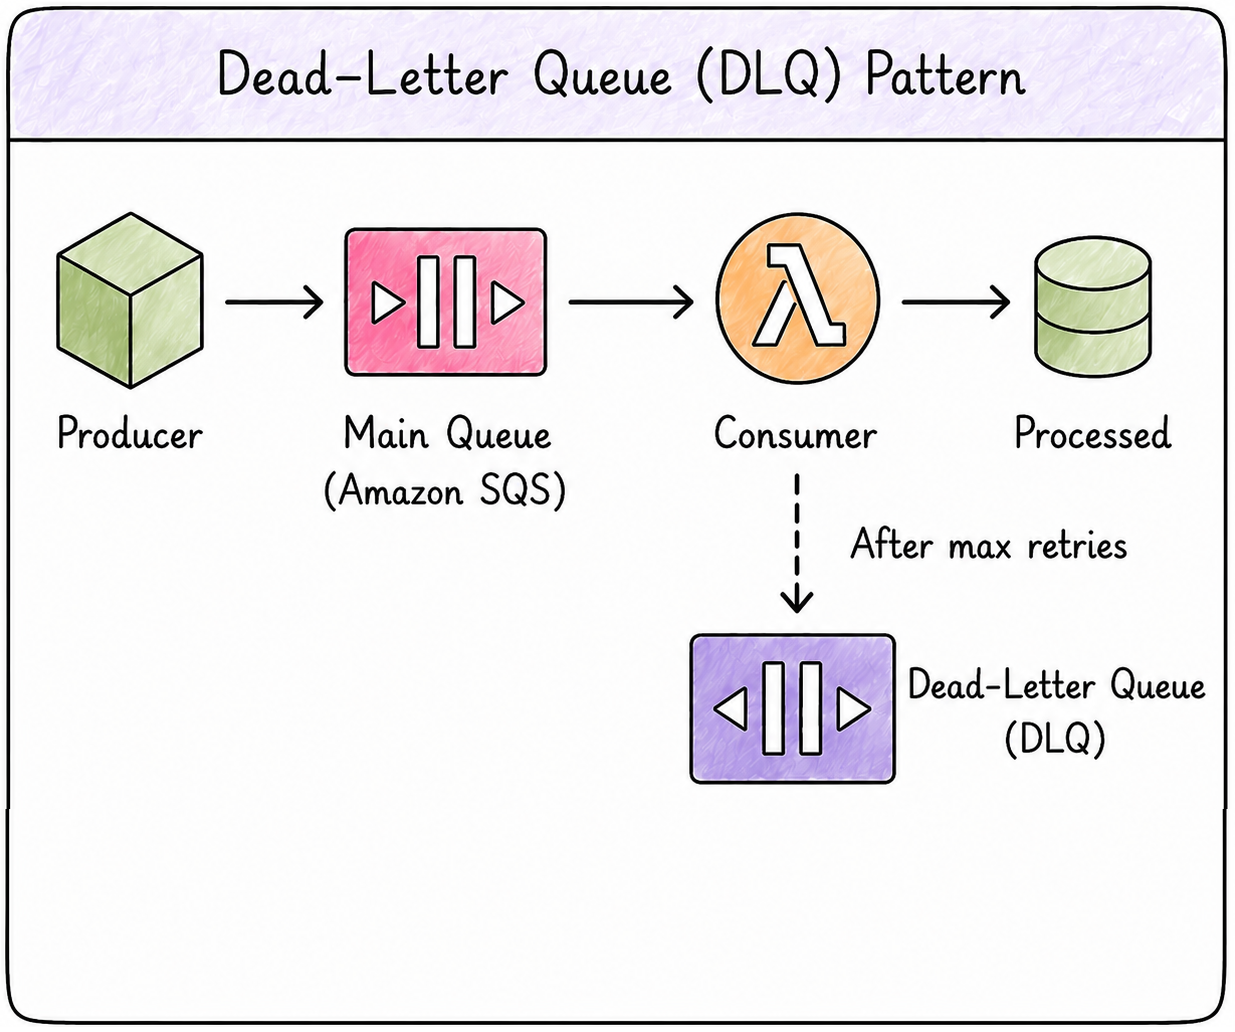
死信佇列(Dead letter queues)
- 管理非同步通訊中的失敗。
- 隔離有問題的「毒性」訊息。
- 多次重試失敗後,訊息會移至 DLQ。
- 主要處理流程可持續運作。
死信佇列(Dead letter queues)
- 當訊息順序不關鍵時使用。
- 非關鍵系統可略過,容許偶發資料遺失。
- 當須保留訊息順序時避免使用。
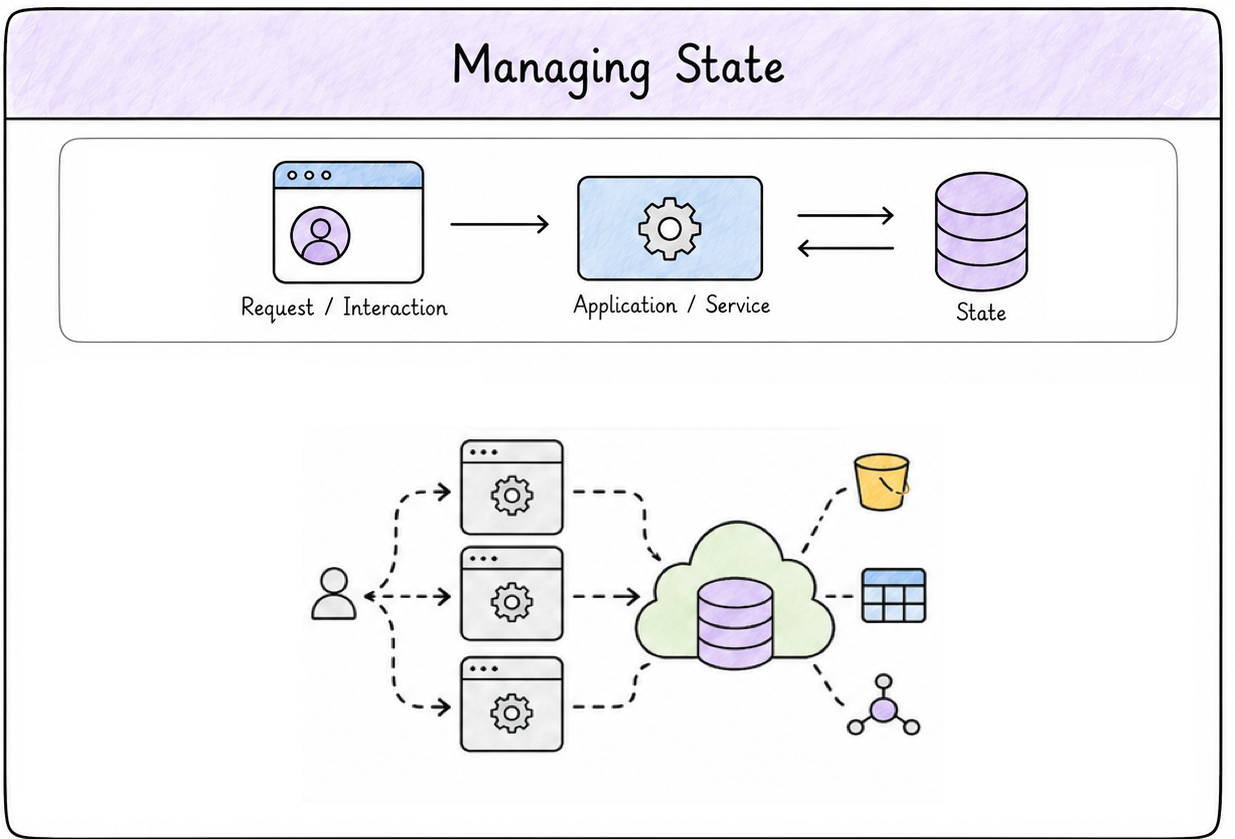
狀態管理
- 雲端原生應用的基礎是狀態管理。
- 狀態是互動之間被保留的任何資料。
- 將狀態存於伺服器本機會限制擴展性與韌性。
狀態管理
- 狀態管理的取捨取決於你要打造的系統。
- 外部化狀態可提升擴展性與韌性。
- 成本:延遲與複雜度增加。
- 需考量:一致性、快取、資料存取模式。
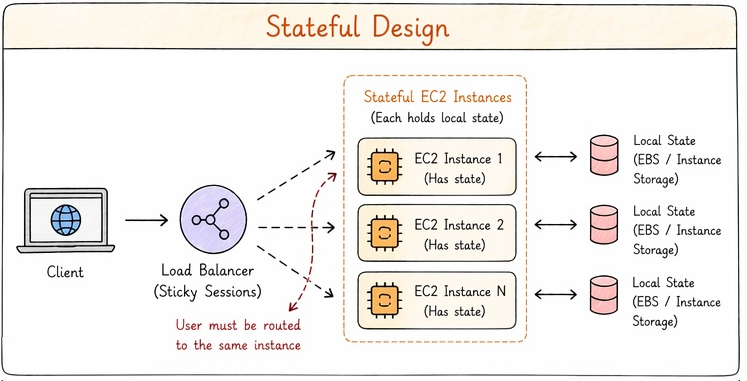
Stateful(有狀態)
- 伺服器保留工作階段資料。
- 請求必須導向「同一個」實例(黏性工作階段)。
- 侷限擴展彈性。
- 若實例故障,工作階段即消失。
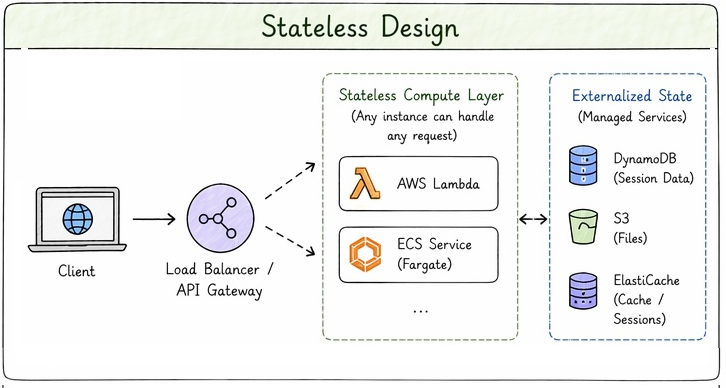
Stateless(無狀態)
- 每個請求獨立處理。
- 伺服器不存任何狀態。
- 狀態放在外部系統。
- 雲端原生應用的首選做法。
- 任何實例都能處理任何請求,水平擴展更容易。
 Preparing Video For Download...