在 Snowflake 進行資料管線自動化
Emily Melhuish
Technical Curriculum Developer, Snowflake
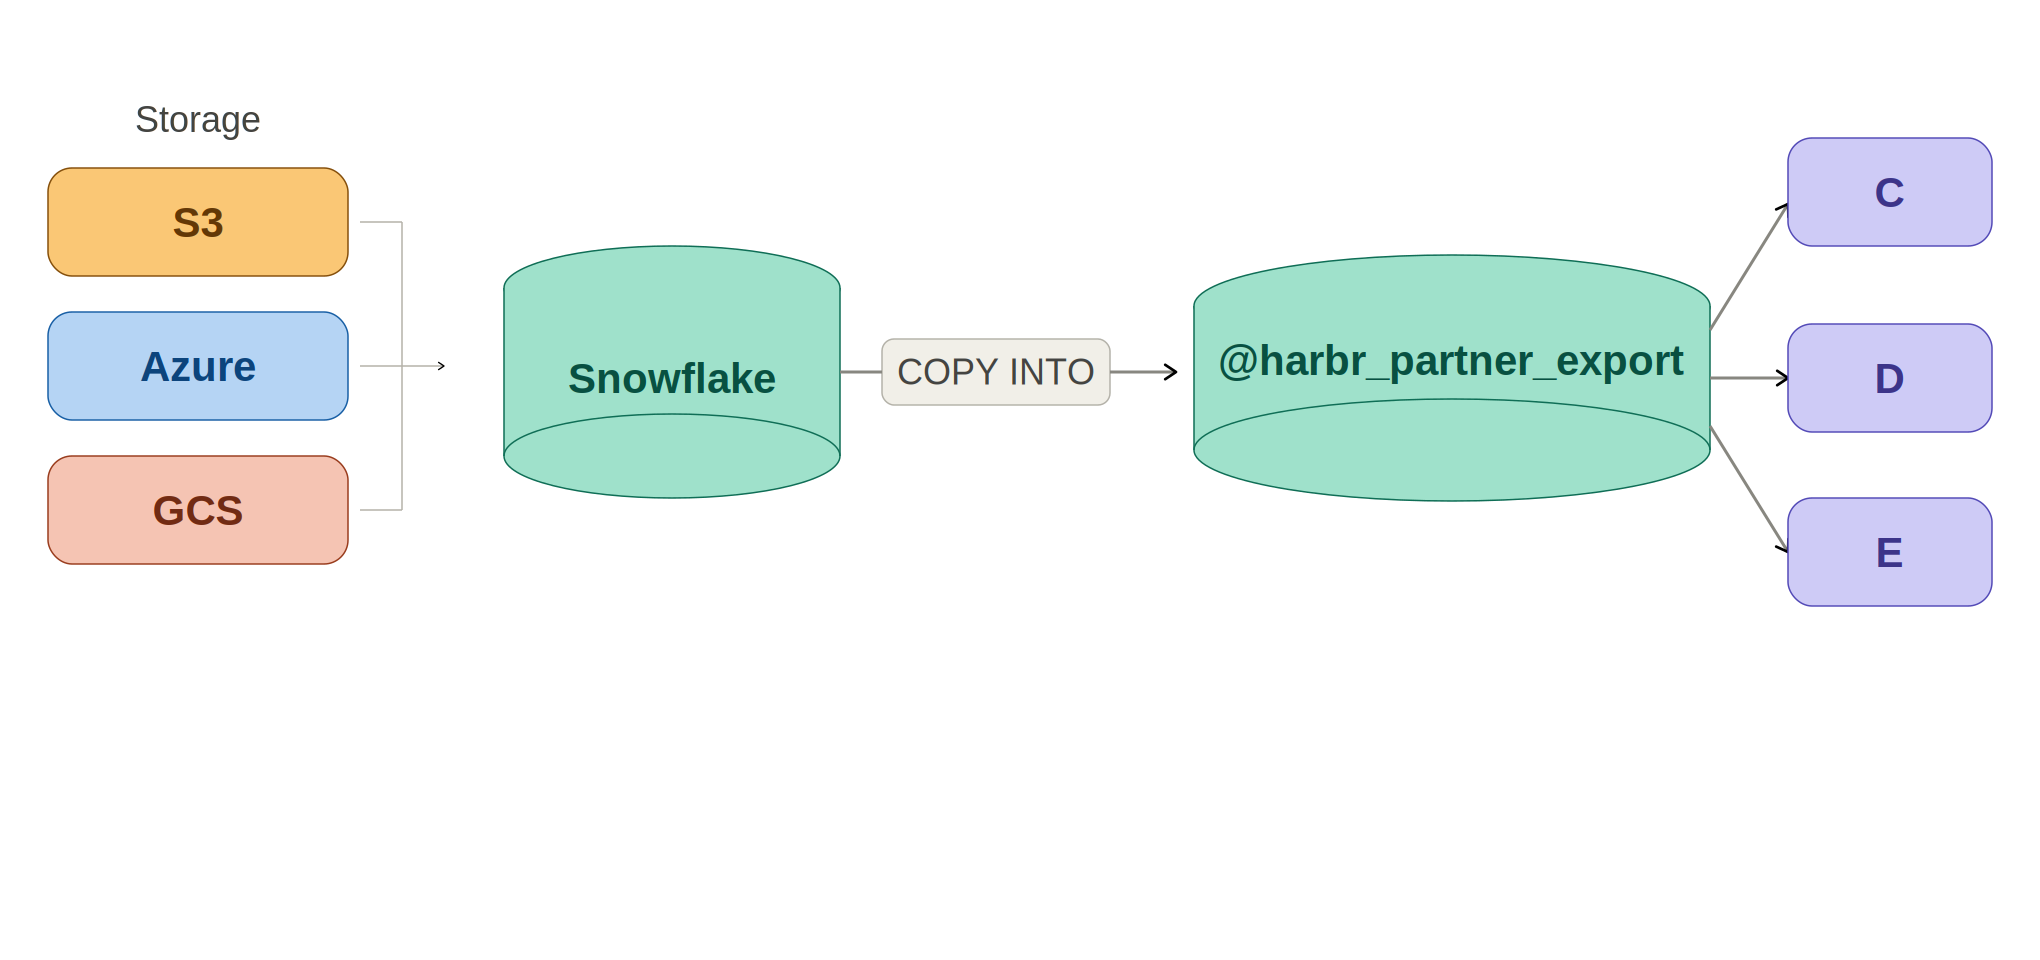
匯出到雲端儲存
COPY INTO
COPY INTO @harbr_partner_export/
daily_summary/
FROM (SELECT * FROM
logistics.shipment_summary
WHERE export_date =
CURRENT_DATE() - 1);
COPY INTO @harbr_partner_export/shipment_summary/
FROM (
  SELECT shipment_id,
         origin,
         destination,
         delivery_status,
         delivery_time_hours
  FROM logistics.shipments
  WHERE delivery_date = CURRENT_DATE()
)
FILE_FORMAT = (TYPE = 'CSV' HEADER = TRUE)
OVERWRITE = TRUE;
關鍵卸載選項
-- 將大型匯出拆成多個檔案(位元組)
HEADER = TRUE              -- 首列包含欄位名稱
OVERWRITE = TRUE           -- 取代該路徑下既有檔案
MAX_FILE_SIZE = 104857600  -- 每個輸出檔 100 MB
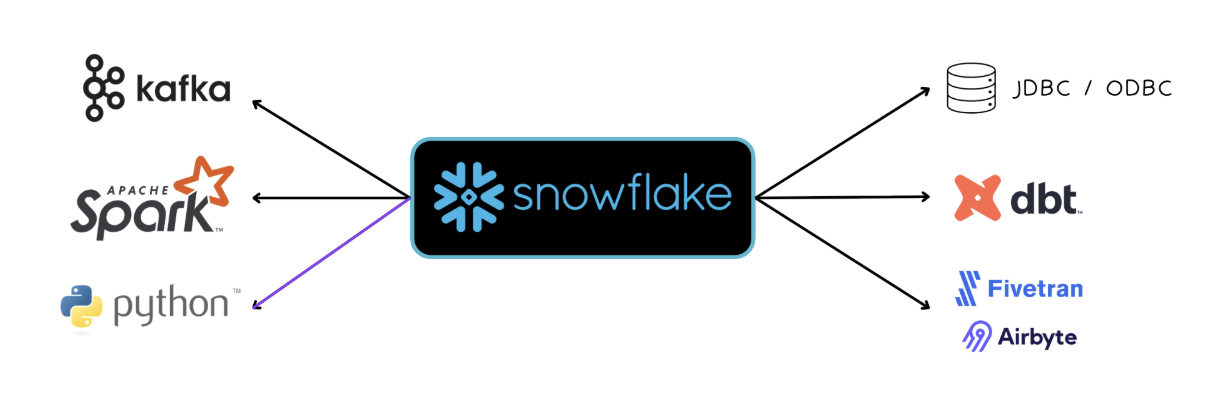
Kafka 連接器
# connector.properties(Kafka 設定)
snowflake.topic2table.map=events:
delivery_events
snowflake.ingestion.method=
SNOWPIPE_STREAMING
Spark 連接器
// 從 Snowflake 讀取為 Spark DataFrame
val df = spark.read.format("snowflake")
  .options(sfOptions).option("dbtable",
    "shipments").load()
通用連線