在 Snowflake 進行資料管線自動化
Emily Melhuish
Technical Curriculum Developer, Snowflake


關於 Harbr

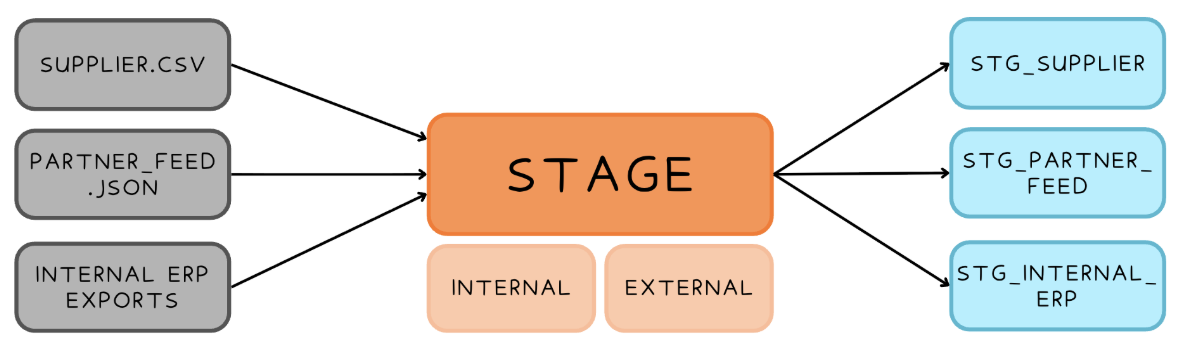
Stage = 臨時儲存位置

內部 Stage
外部 Stage
目錄資料表
CREATE STAGE harbr_stage
DIRECTORY = (ENABLE = TRUE)
內部 Stage 加密
ENCRYPTION = (TYPE = SNOWFLAKE_FULL)
ENCRYPTION = (TYPE = SNOWFLAKE_SSE)
外部 Stage 加密
ENCRYPTION =
([ TYPE = 'AWS_CSE' ] MASTER_KEY = '')
ENCRYPTION =
([ TYPE = 'AWS_SSE_S3' ])
...
半結構化格式:JSON、Parquet、Avro、ORC、XML。
VARIANT 欄僅需更新一次格式物件
SQL
CREATE FILE FORMAT harbr_csv_format
TYPE = 'CSV'
FIELD_DELIMITER = ','
SKIP_HEADER = 1;
使用具名 stage 與具名檔案格式載入
COPY INTO logistics.shipments
FROM @harbr_internal_stage/shipments/
FILE_FORMAT = (FORMAT_NAME = 'harbr_csv_format')
| ON_ERROR 選項 | 行為 |
|---|---|
ABORT_STATEMENT |
遇到第一個錯誤即整體失敗(預設) |
CONTINUE |
略過錯誤列,載入其他資料 |
SKIP_FILE |
檔案任一處有錯誤就整個略過 |
SKIP_FILE_<num> |
只有當錯誤超過指定數量才略過檔案 |
SKIP_FILE_<num>% |
只有當錯誤超過指定百分比門檻才略過檔案 |
僅驗證不載入 = 試跑
COPY INTO logistics.shipments
FROM @harbr_internal_stage/shipments/
FILE_FORMAT = (FORMAT_NAME = 'harbr_csv_format')
VALIDATION_MODE = RETURN_ERRORS;
檢視載入歷程
SELECT * FROM TABLE(INFORMATION_SCHEMA.COPY_HISTORY(
TABLE_NAME => 'shipments',
START_TIME => DATEADD('hour', -24,
CURRENT_TIMESTAMP())));
在 Snowflake 進行資料管線自動化