參數式估計

Python 量化風險管理

Jamsheed Shorish

Computational Economist

分配的類別

  • 損失分配:實際未知
  • 可行分配的「類別」?
    • 假設分配類別為 $f(x; \theta)$
    • $x$ 為損失(隨機變數)
    • $\theta$ 為未知參數向量
  • 範例:常態分配
    • 參數:$\theta = (\mu, \sigma)$,平均 $\mu$、標準差 $\sigma$
  • 參數式估計:給定資料找出「最佳」$\theta^\star$
  • 損失分配:$f(x,\theta^\star)$
Python 量化風險管理

擬合分配

  • 依最小化誤差的準則來擬合分配
    • 範例scipy.stats.norm.fit(),將常態分配擬合到資料
      • 結果:最佳擬合的平均與標準差
  • 優點
    • 可用長條圖視覺化資料與估計間的差異
    • 可提供適配度檢定
Python 量化風險管理

適配度

  • 估計的分配與資料契合得如何?
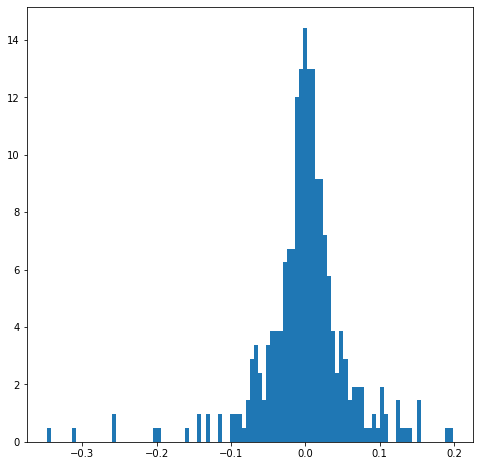
  • 視覺化:繪製投資組合損失的長條圖

損失的長條圖

Python 量化風險管理

適配度

  • 估計的分配與資料契合得如何?
  • 視覺化:繪製投資組合損失的長條圖
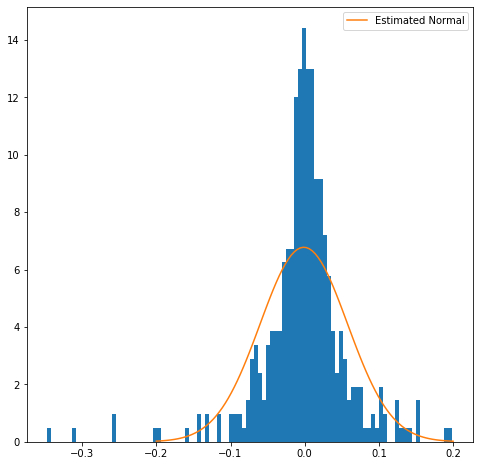
  • 使用 norm.fit() 的常態分配

含常態分配的損失長條圖

Python 量化風險管理

適配度

  • 估計的分配與資料契合得如何?
  • 視覺化:繪製投資組合損失的長條圖
  • 範例
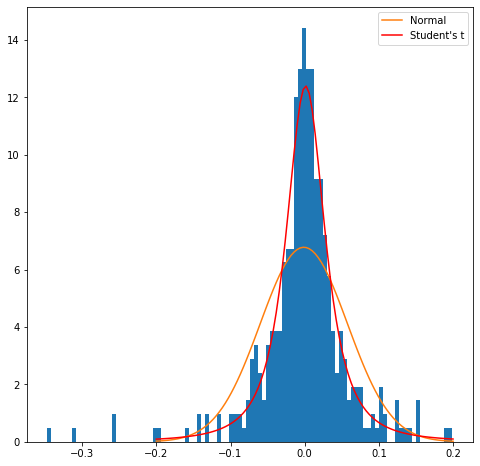
    • 使用 norm.fit() 的常態分配
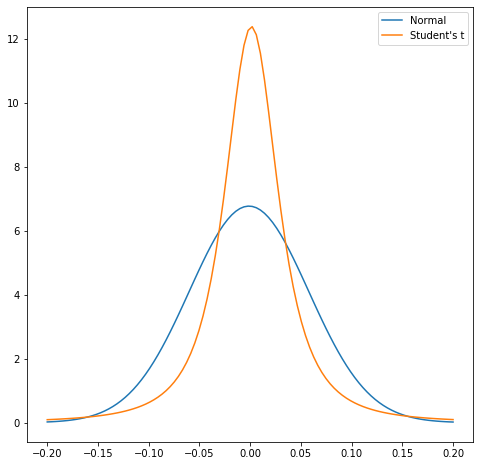
    • 使用 t.fit() 的 Student t 分配
    • 長條圖不對稱?

含常態與 t 分配的損失長條圖

Python 量化風險管理

Anderson-Darling 檢定

  • 適配度的統計檢定
    • 檢定虛無假設:資料為常態分配
    • 檢定統計量若大於 critical_values,則拒絕常態分配
  • 匯入 scipy.stats.anderson
  • loss 資料計算檢定結果
from scipy.stats import anderson

anderson(loss)
AndersonResult(statistic=11.048641503898523,
critical_values=array([0.57 , 0.649, 0.779, 0.909, 1.081]),
significance_level=array([15. , 10. ,  5. ,  2.5,  1. ]))
Python 量化風險管理

偏態

  • 偏態(skewness):資料偏離對稱分配的程度
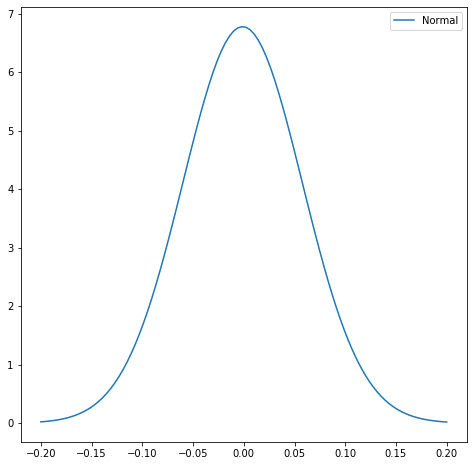
    • 常態分配:對稱

常態分配

Python 量化風險管理

偏態

  • 偏態:資料偏離對稱分配的程度
    • 常態分配:對稱
    • Student t 分配:對稱

常態與 t 分配

Python 量化風險管理

偏態

  • 偏態:資料偏離對稱分配的程度
    • 常態分配:對稱
    • Student t 分配:對稱
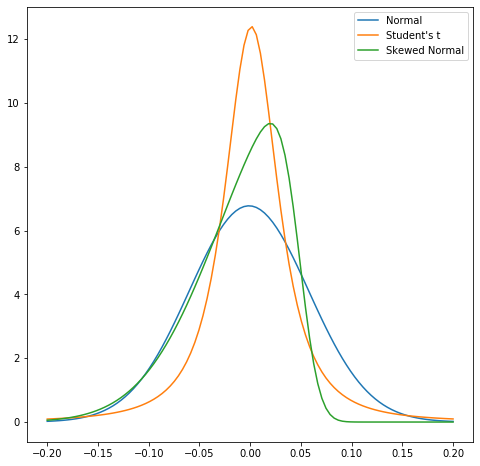
  • 偏態常態分配:不對稱
    • 常態為其特例
    • 適用於投資組合資料,例如損失多於獲利
    • scipy.stats 中為 skewnorm

常態、t 與偏態常態分配

Python 量化風險管理

偏態檢定

  • 檢驗資料偏離對稱分配的程度:scipy.stats.skewtest
  • 虛無假設:無偏態
  • scipy.stats 匯入 skewtest
  • loss 資料計算檢定
    • 統計上顯著 ⇒ 使用具有偏態的分配類別
from scipy.stats import skewtest

skewtest(loss)
SkewtestResult(statistic=-7.786120875514511,
pvalue=6.90978472959861e-15)
Python 量化風險管理

一起來練習吧!

Python 量化風險管理

Preparing Video For Download...