使用 PySpark 的機器學習
Andrew Collier
Data Scientist, Fathom Data
cars.select('mass', 'cyl', 'consumption').show(5)
+------+---+-----------+
|  mass|cyl|consumption|
+------+---+-----------+
|1451.0|  6|       9.05|
|1129.0|  4|       6.53|
|1399.0|  4|       7.84|
|1147.0|  4|       7.84|
|1111.0|  4|       9.05|
+------+---+-----------+
用來建立模型的物件。也可以是 pipeline。
regression = LinearRegression(labelCol='consumption')
用來評估模型效能的物件。
evaluator = RegressionEvaluator(labelCol='consumption')
from pyspark.ml.tuning import CrossValidator, ParamGridBuilder
參數值的格點(目前為空)。
params = ParamGridBuilder().build()
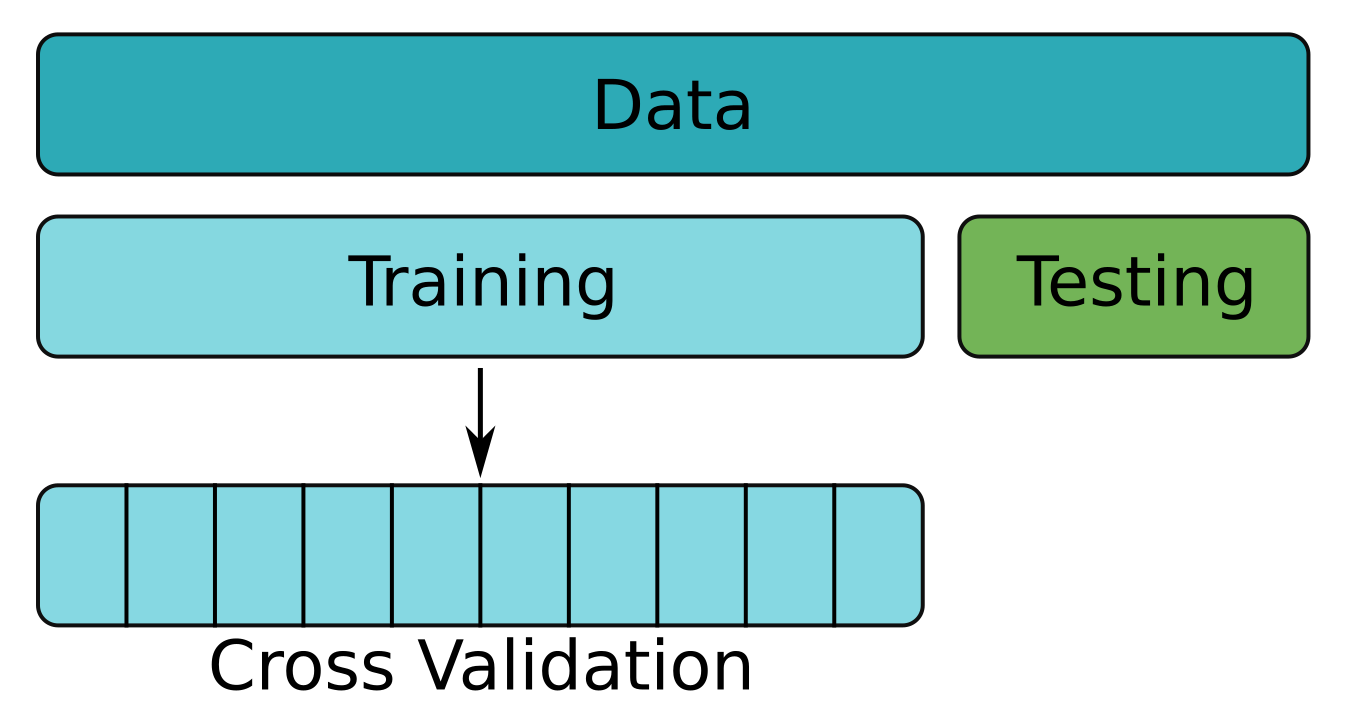
交叉驗證物件。
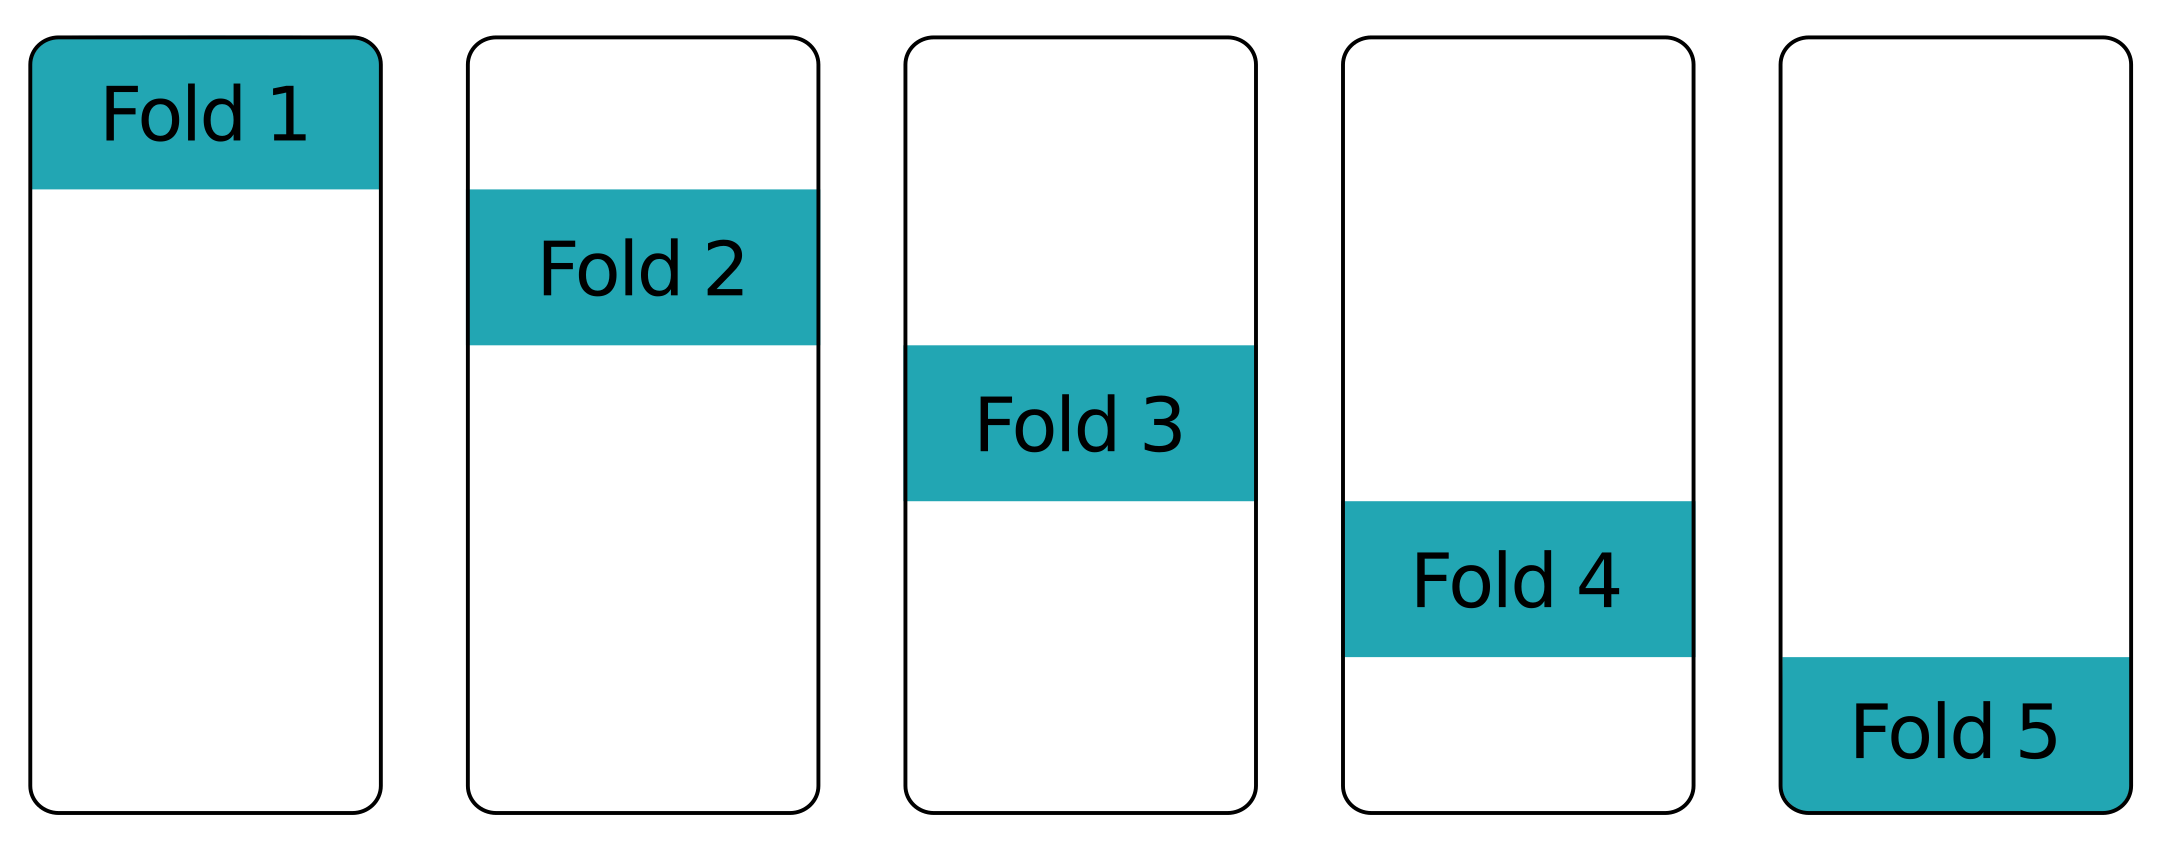
cv = CrossValidator(estimator=regression,
                    estimatorParamMaps=params,
                    evaluator=evaluator,
                    numFolds=10, seed=13)
將交叉驗證套用到訓練資料。
cv = cv.fit(cars_train)
各摺的平均 RMSE 是多少?
cv.avgMetrics
[0.800663722151572]
在原始測試資料上做預測。
evaluator.evaluate(cv.transform(cars_test))
# 測試資料的 RMSE
0.745974203928479
遠小於交叉驗證的 RMSE。
# 交叉驗證的 RMSE
0.800663722151572
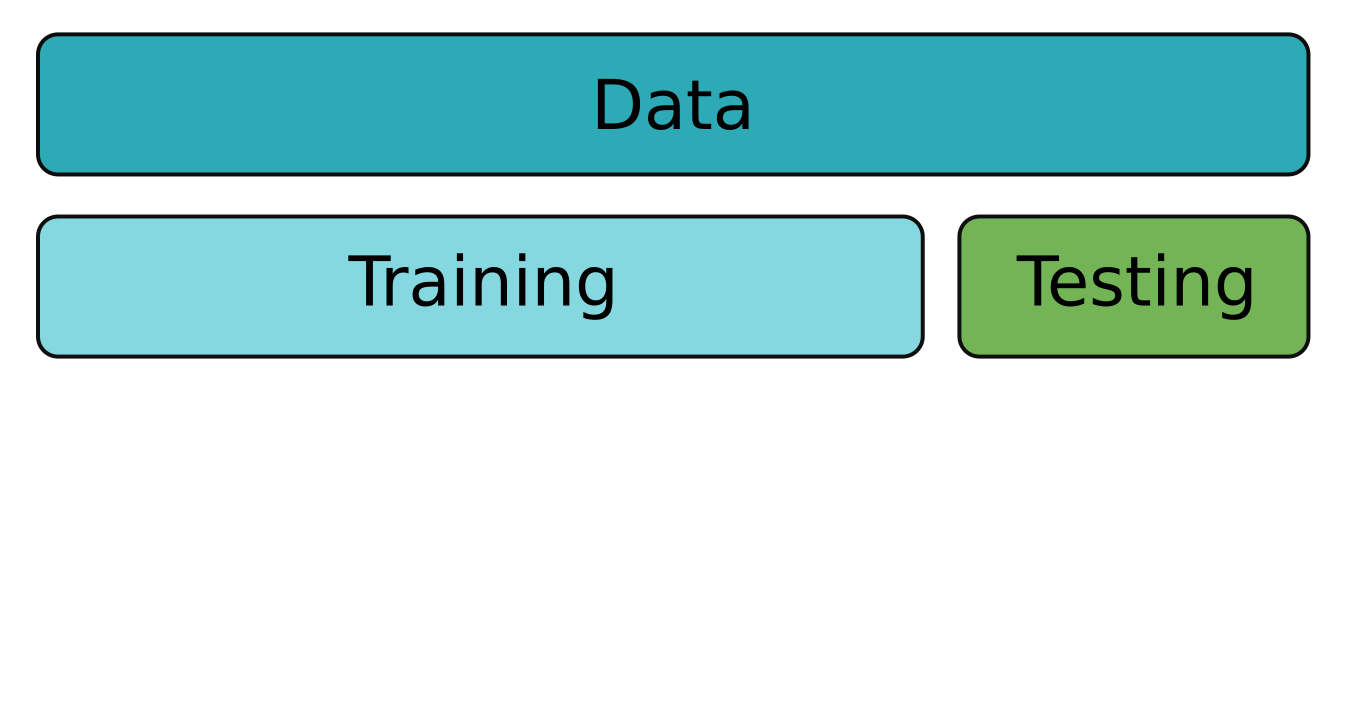
僅用訓練-測試切分會過度樂觀地評估模型效能。