使用 PySpark 的機器學習
Andrew Collier
Data Scientist, Fathom Data
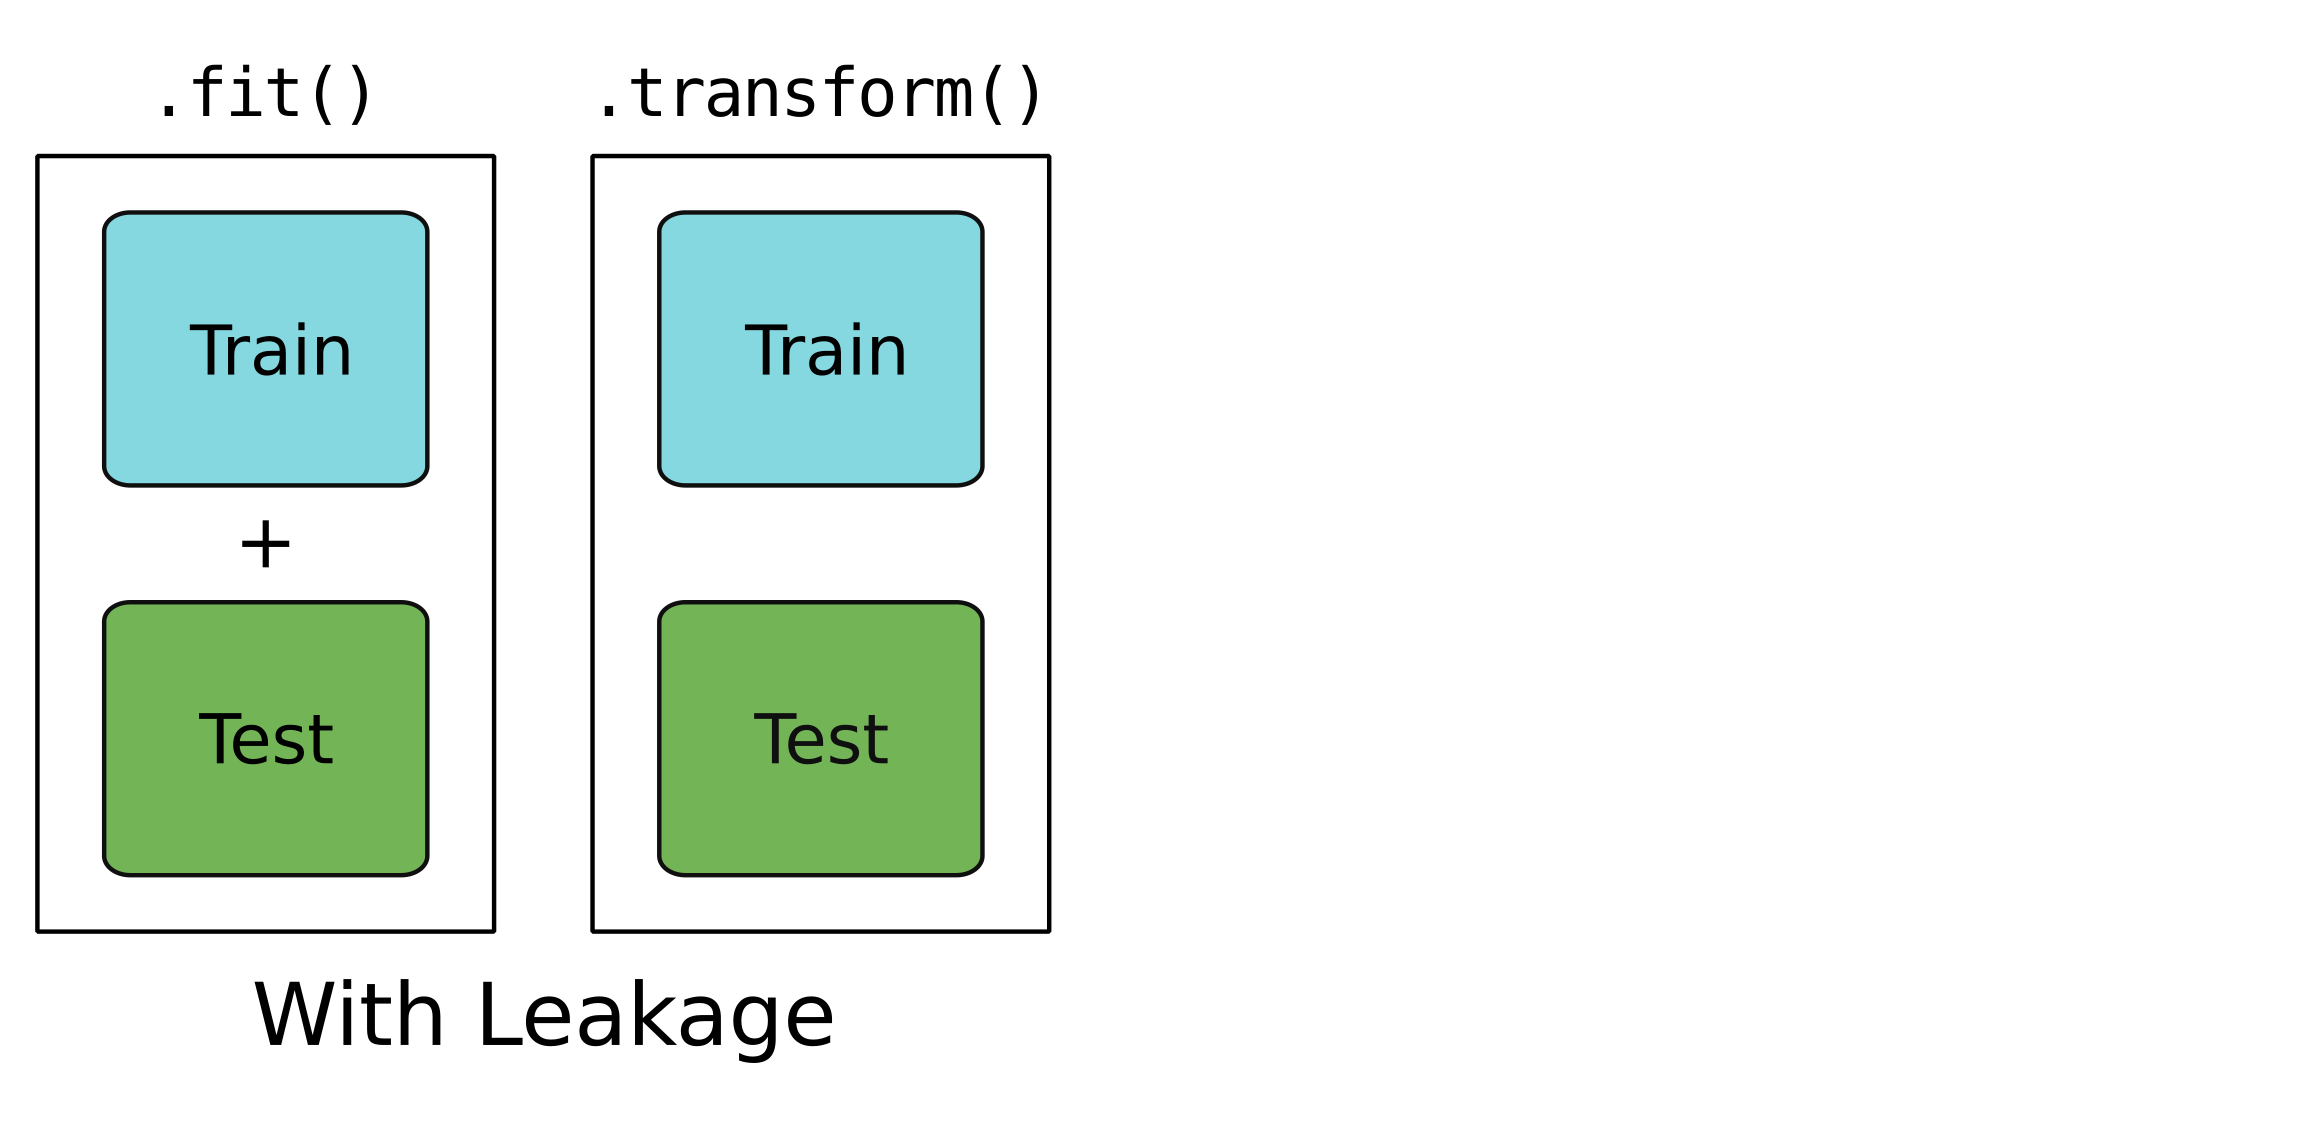
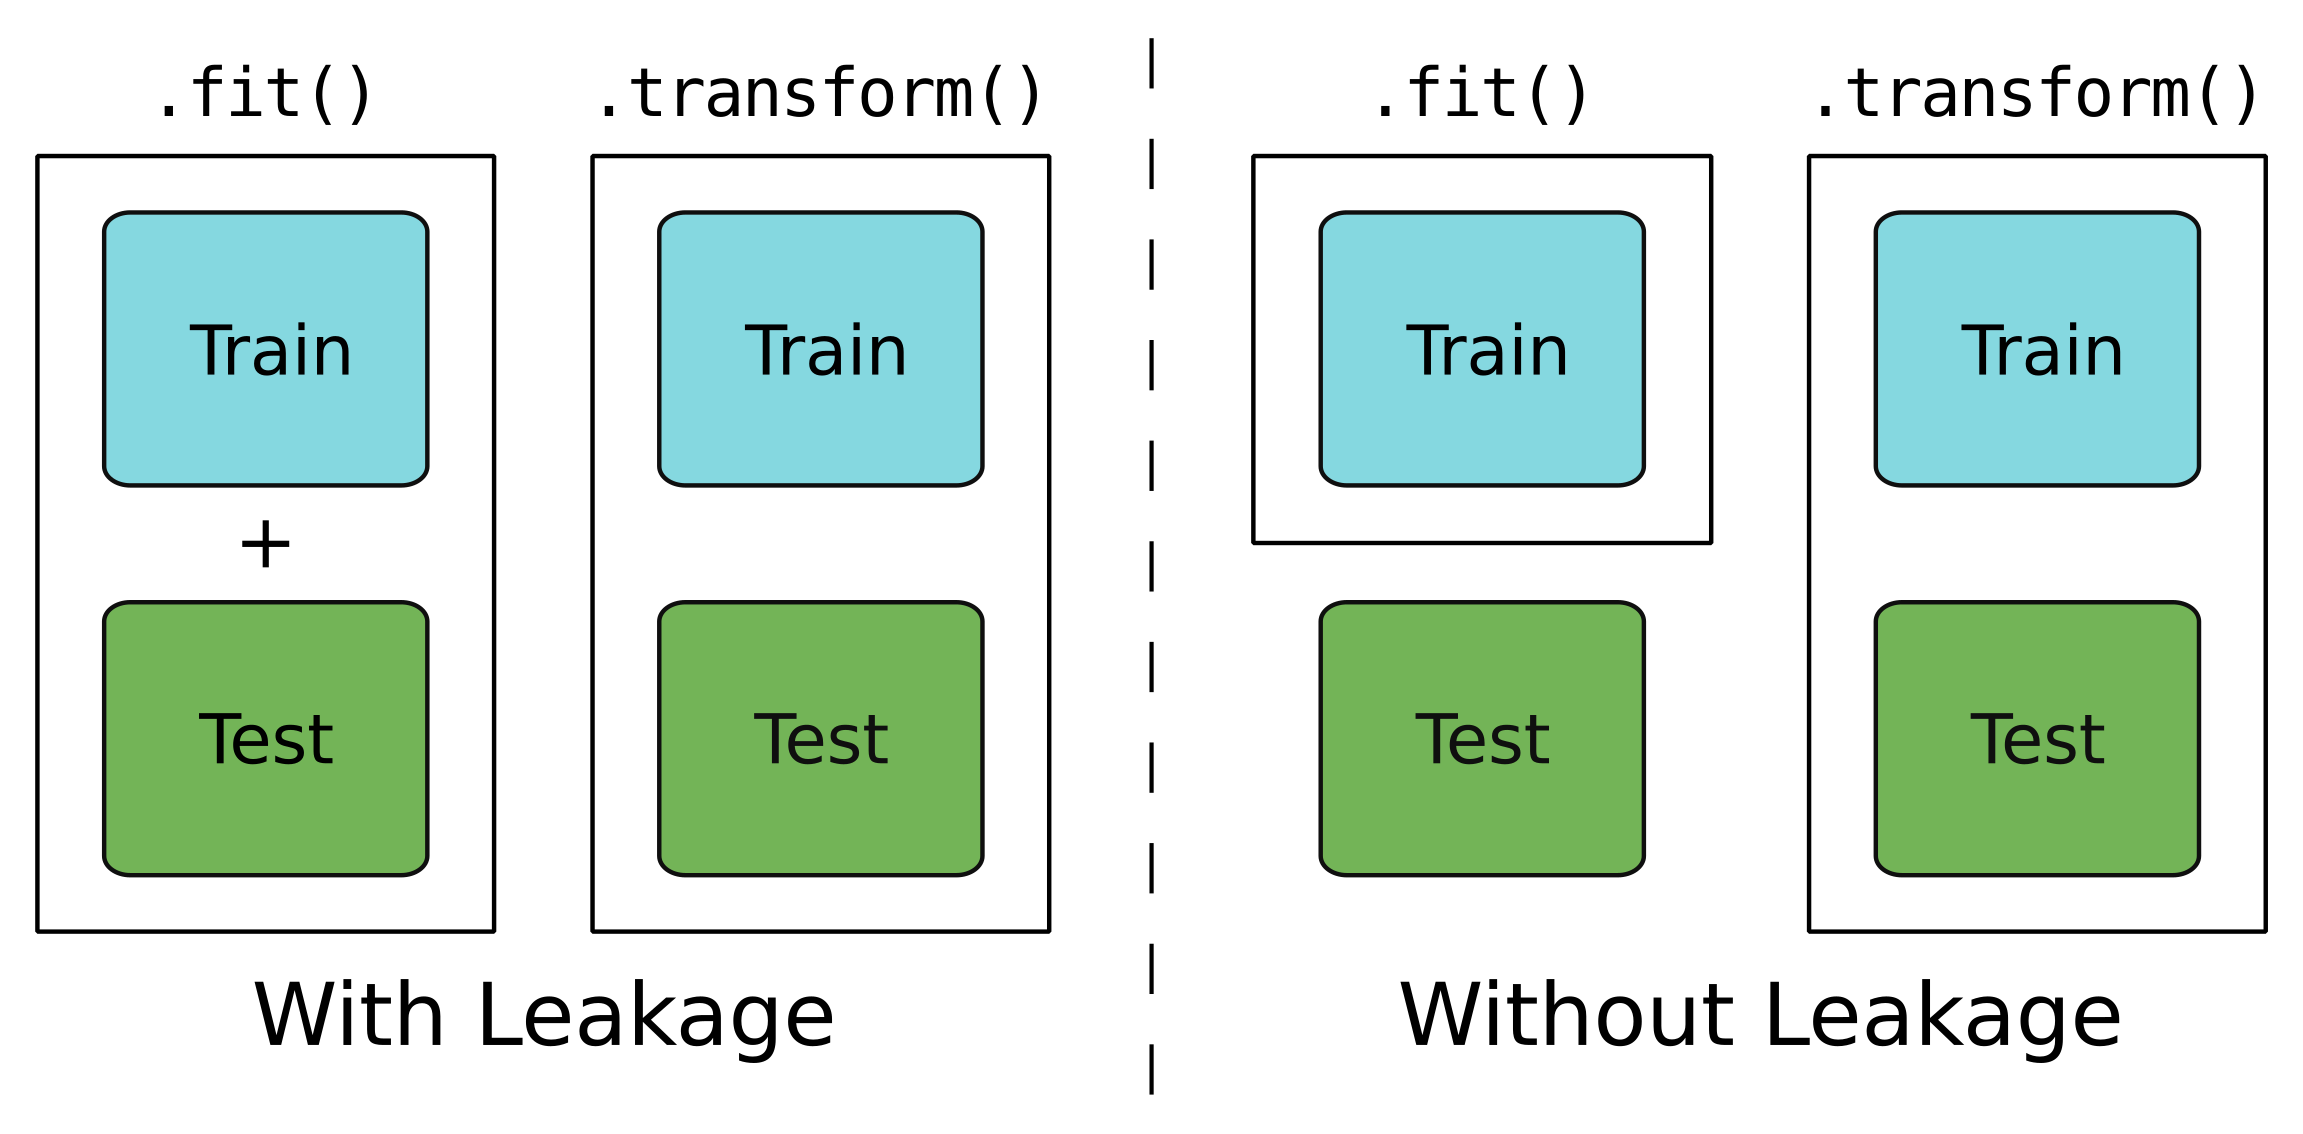
只用於訓練資料。
適用於測試與訓練資料。


Pipeline 由一連串作業組成。
你可以逐一執行每個作業,或直接套用整個 Pipeline!
indexer = StringIndexer(inputCol='type', outputCol='type_idx')onehot = OneHotEncoder(inputCols=['type_idx'], outputCols=['type_dummy'])assemble = VectorAssembler( inputCols=['mass', 'cyl', 'type_dummy'], outputCol='features' )regression = LinearRegression(labelCol='consumption')
indexer = indexer.fit(cars_train)
cars_train = indexer.transform(cars_train)
onehot = onehot.fit(cars_train)
cars_train = onehot.transform(cars_train)
cars_train = assemble.transform(cars_train)
# 將模型配適到訓練資料
regression = regression.fit(cars_train)
cars_test = indexer.transform(cars_test)
cars_test = onehot.transform(cars_test)
cars_test = assemble.transform(cars_test)
# 在測試資料上產生預測
predictions = regression.transform(cars_test)
把步驟組成一個 Pipeline。
from pyspark.ml import Pipeline
pipeline = Pipeline(stages=[indexer, onehot, assemble, regression])
訓練資料
pipeline = pipeline.fit(cars_train)
測試資料
predictions = pipeline.transform(cars_test)
用 .stages 屬性存取各個階段。
# LinearRegression 物件(第 4 個階段 -> 索引 3) pipeline.stages[3]print(pipeline.stages[3].intercept)
4.19433571782916
print(pipeline.stages[3].coefficients)
DenseVector([0.0028, 0.2705, -1.1813, -1.3696, -1.1751, -1.1553, -1.8894])
使用 PySpark 的機器學習