使用 PySpark 的機器學習
Andrew Collier
Data Scientist, Fathom Data
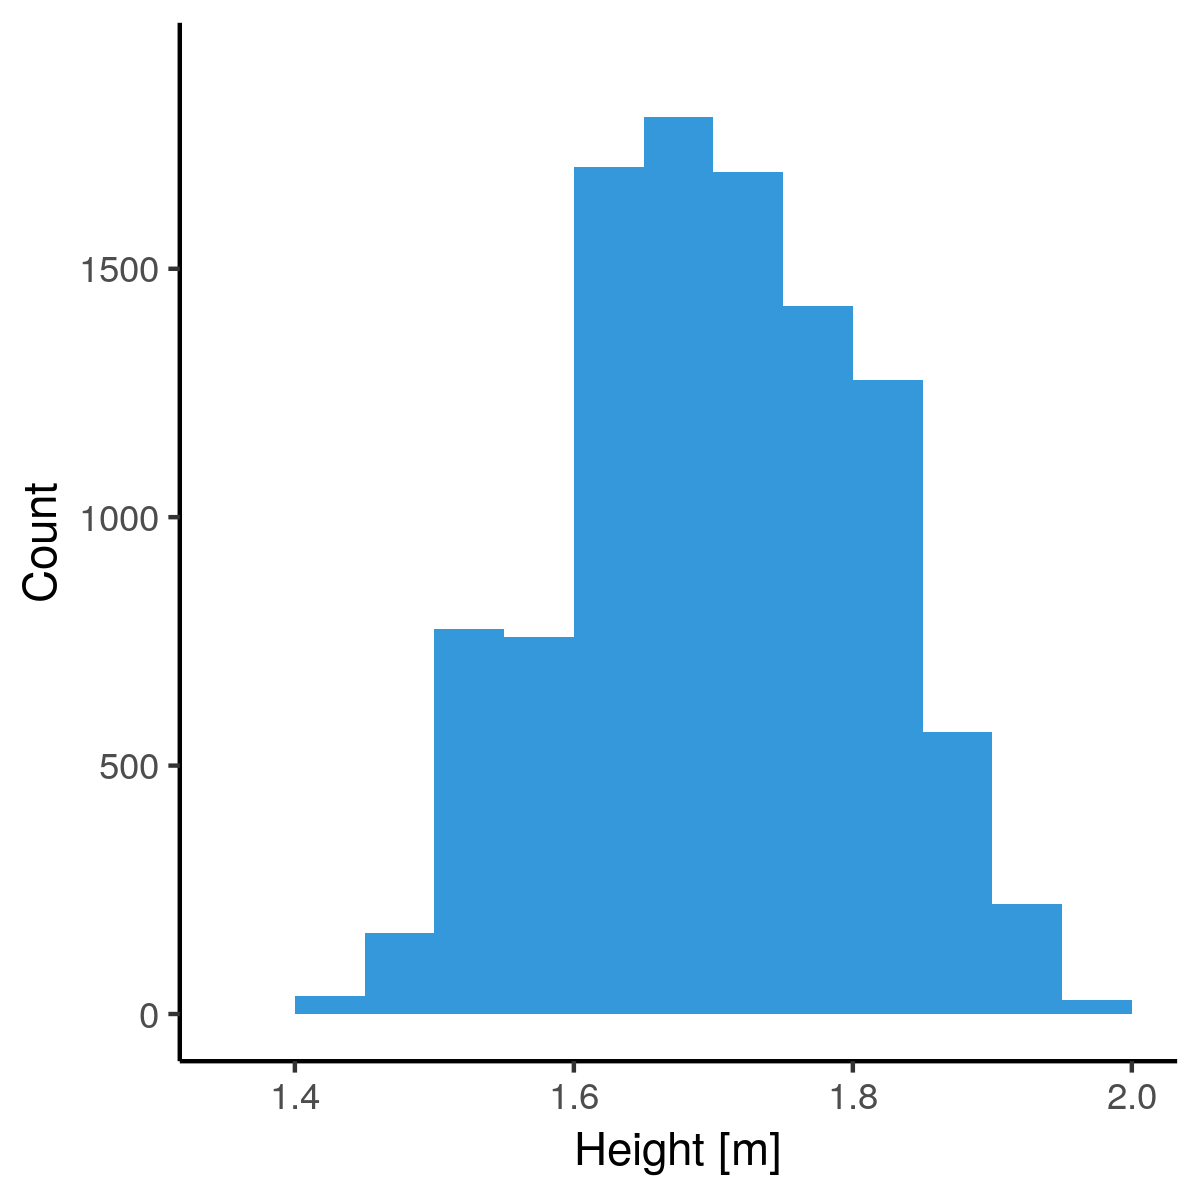
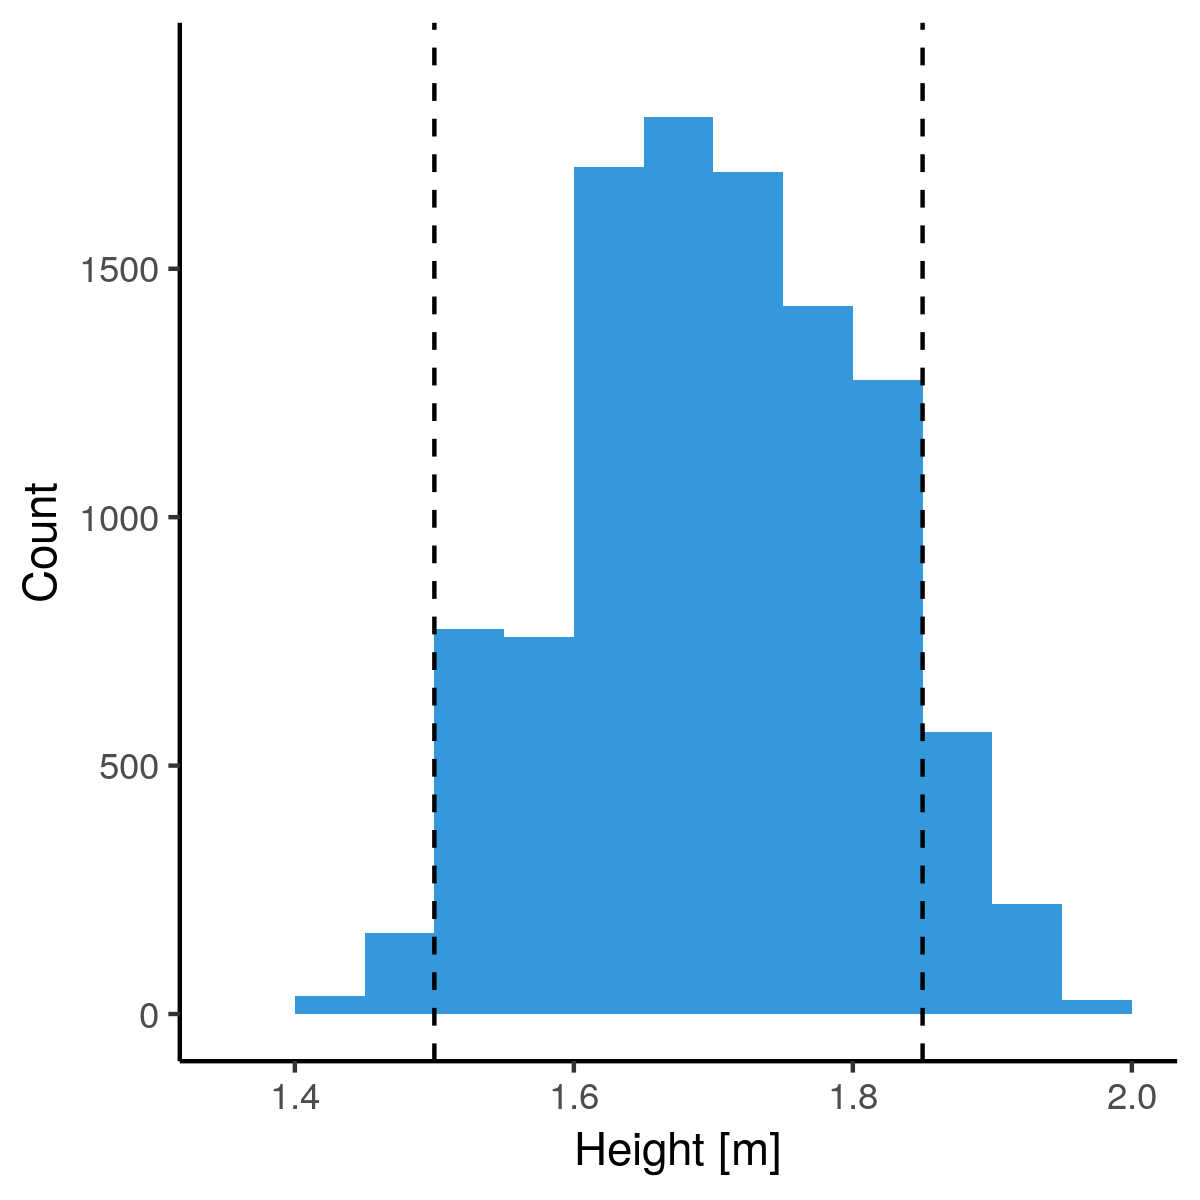
+------+
|height|
+------+
|  1.42|
|  1.45|
|  1.47|
|  1.50|
|  1.52|
|  1.57|
|  1.60|
|  1.75|
|  1.85|
|  1.88|
+------+
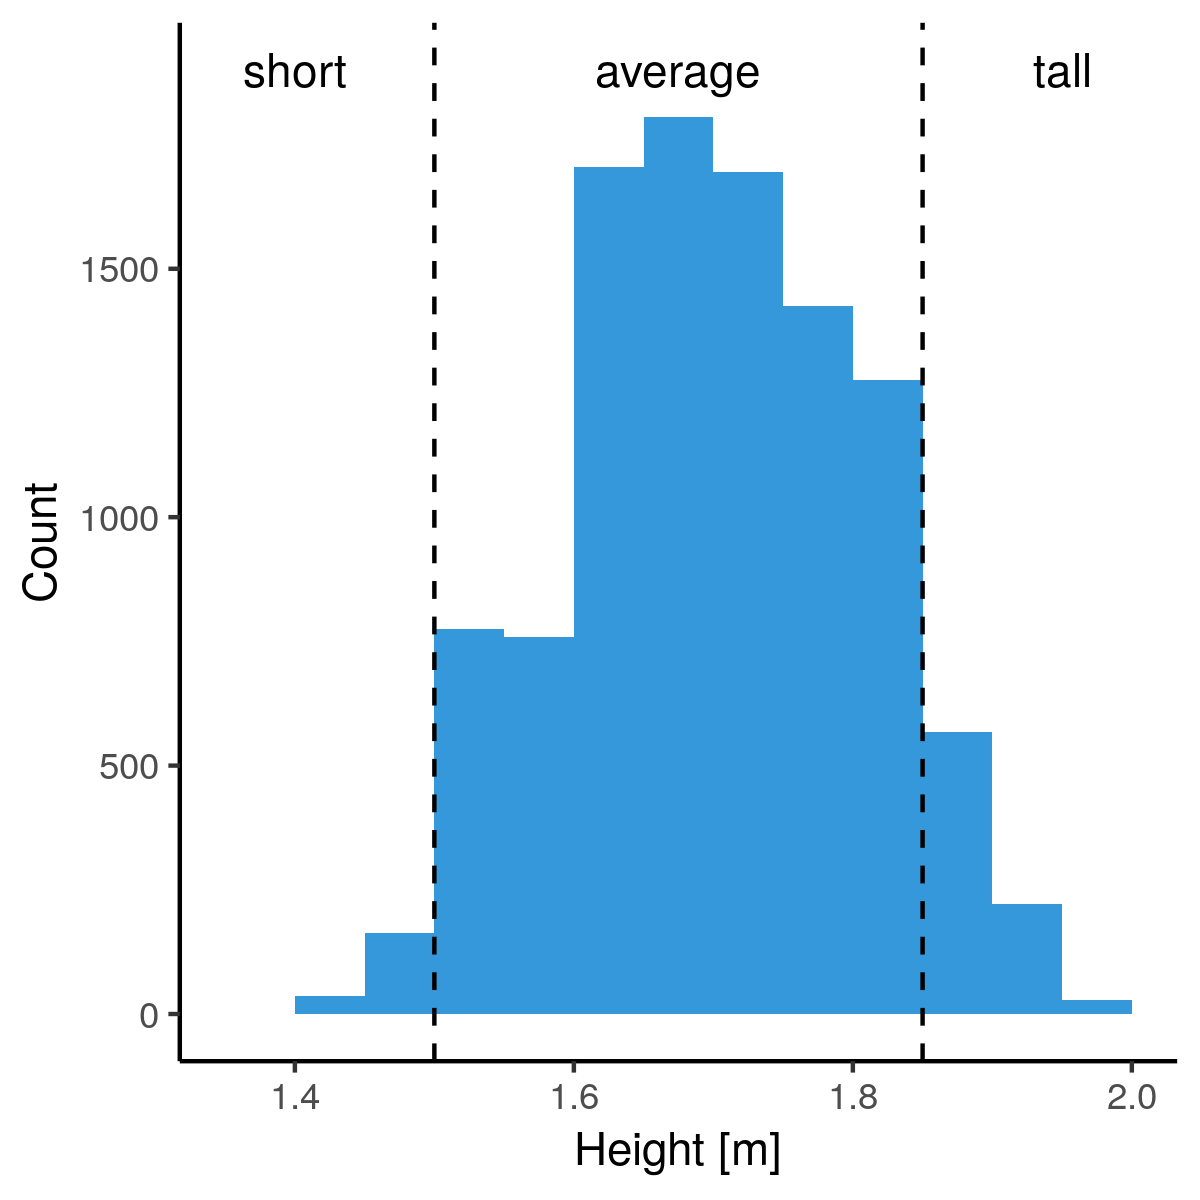
+------+----------+
|height|height_bin|
+------+----------+
|  1.42|     short|
|  1.45|     short|
|  1.47|     short|
|  1.50|     short|
|  1.52|   average|
|  1.57|   average|
|  1.60|   average|
|  1.75|   average|
|  1.85|      tall|
|  1.88|      tall|
+------+----------+
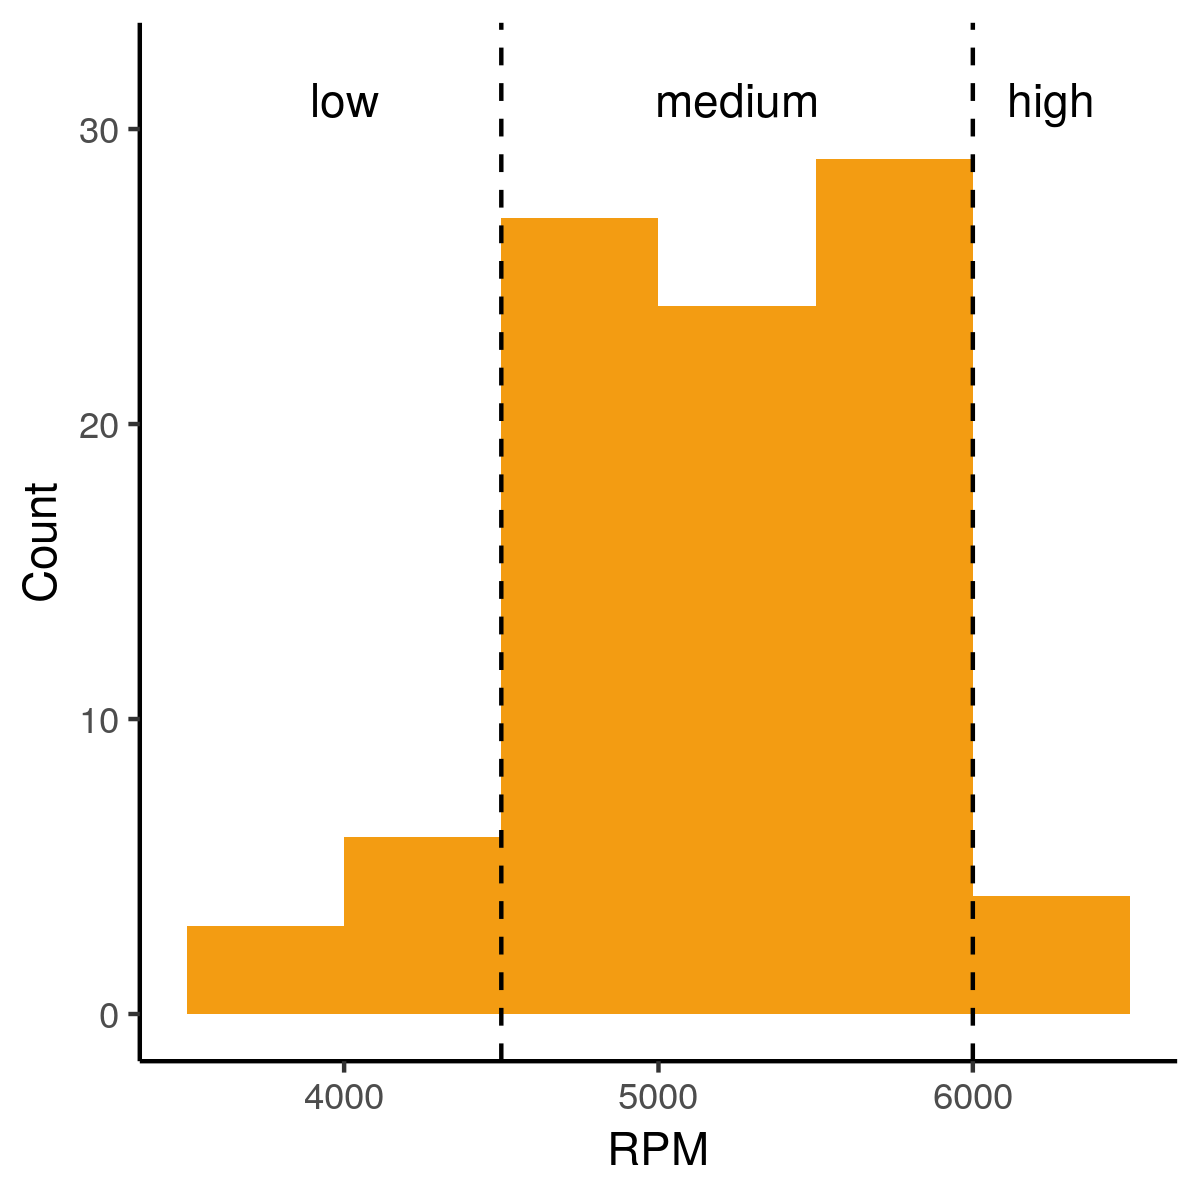
汽車 RPM 存在「自然」分界:
from pyspark.ml.feature import Bucketizer

bucketizer = Bucketizer(splits=[3500, 4500, 6000, 6500],
                        inputCol="rpm",
                        outputCol="rpm_bin")
將區間套用到 rpm 欄。
rpm
bucketed = bucketizer.transform(cars)
bucketed.select('rpm', 'rpm_bin').show(5)
+----+-------+
| rpm|rpm_bin|
+----+-------+
|3800|    0.0|
|4500|    1.0|
|5750|    1.0|
|5300|    1.0|
|6200|    2.0|
+----+-------+
bucketed.groupBy('rpm_bin').count().show()
+-------+-----+
|rpm_bin|count|
+-------+-----+
|    0.0|    8| <- low
|    1.0|   67| <- medium
|    2.0|   17| <- high
+-------+-----+
將 RPM 分箱做 one-hot 編碼為虛擬變數。
+-------+-------------+
|rpm_bin|    rpm_dummy|
+-------+-------------+
|    0.0|(2,[0],[1.0])| <- low
|    1.0|(2,[1],[1.0])| <- medium
|    2.0|    (2,[],[])| <- high
+-------+-------------+
「high」RPM 區間作為參考層級,不會有虛擬變數。
regression.coefficients
DenseVector([1.3814, 0.1433])
regression.intercept
8.1835
「low」RPM 的油耗:
8.1835 + 1.3814 = 9.5649
「medium」RPM 的油耗:
8.1835 + 0.1433 = 8.3268
單一欄位運算:
log()
sqrt()
pow()
兩欄位運算:
+------+-----+----+
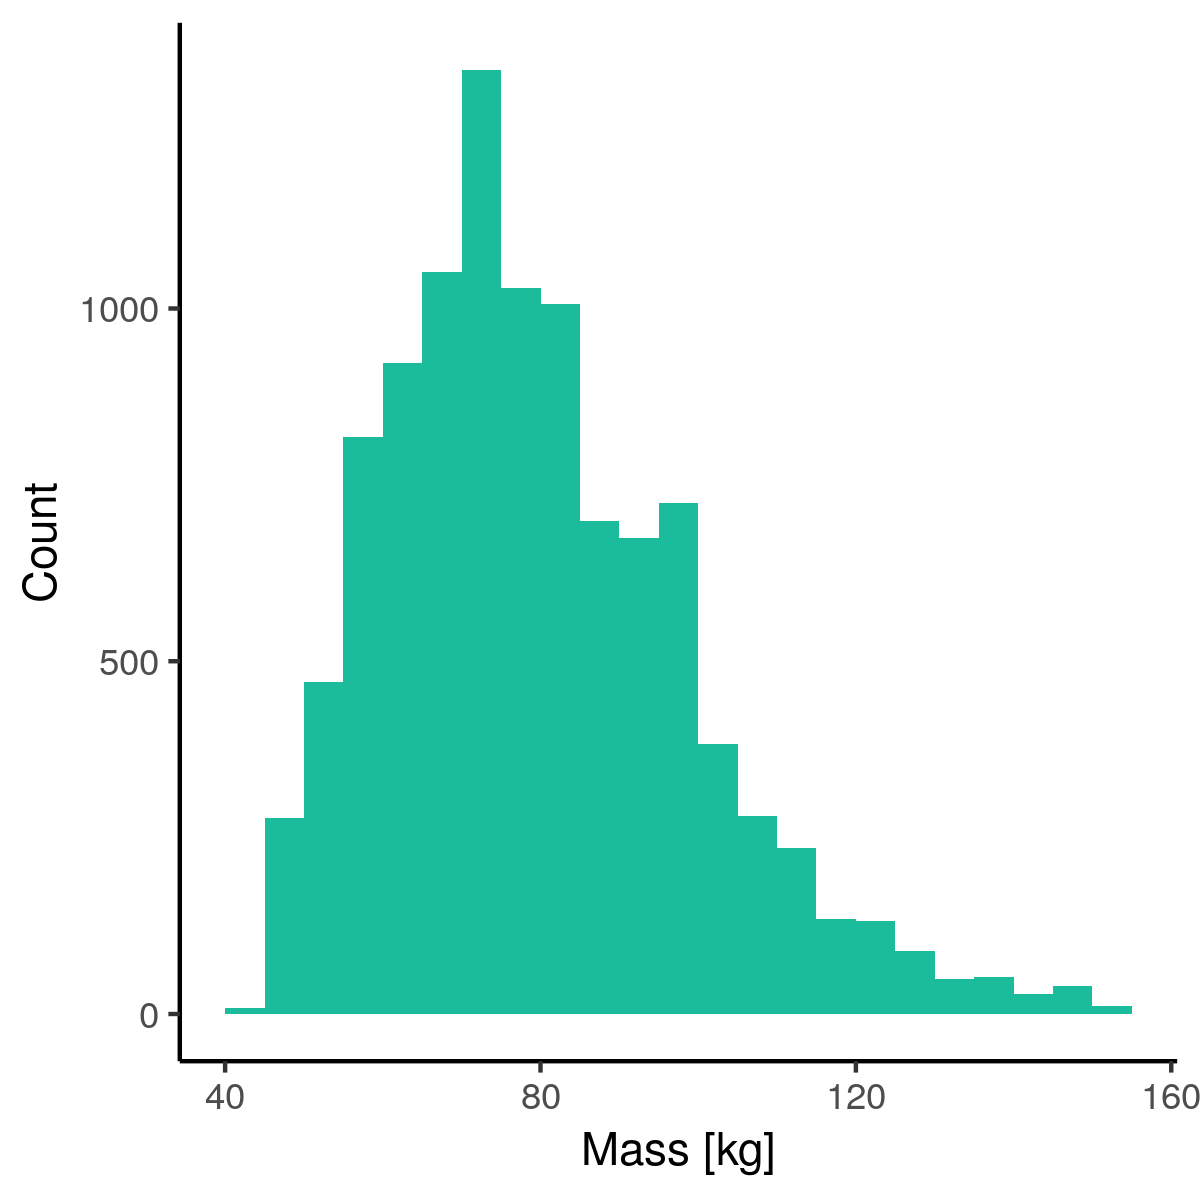
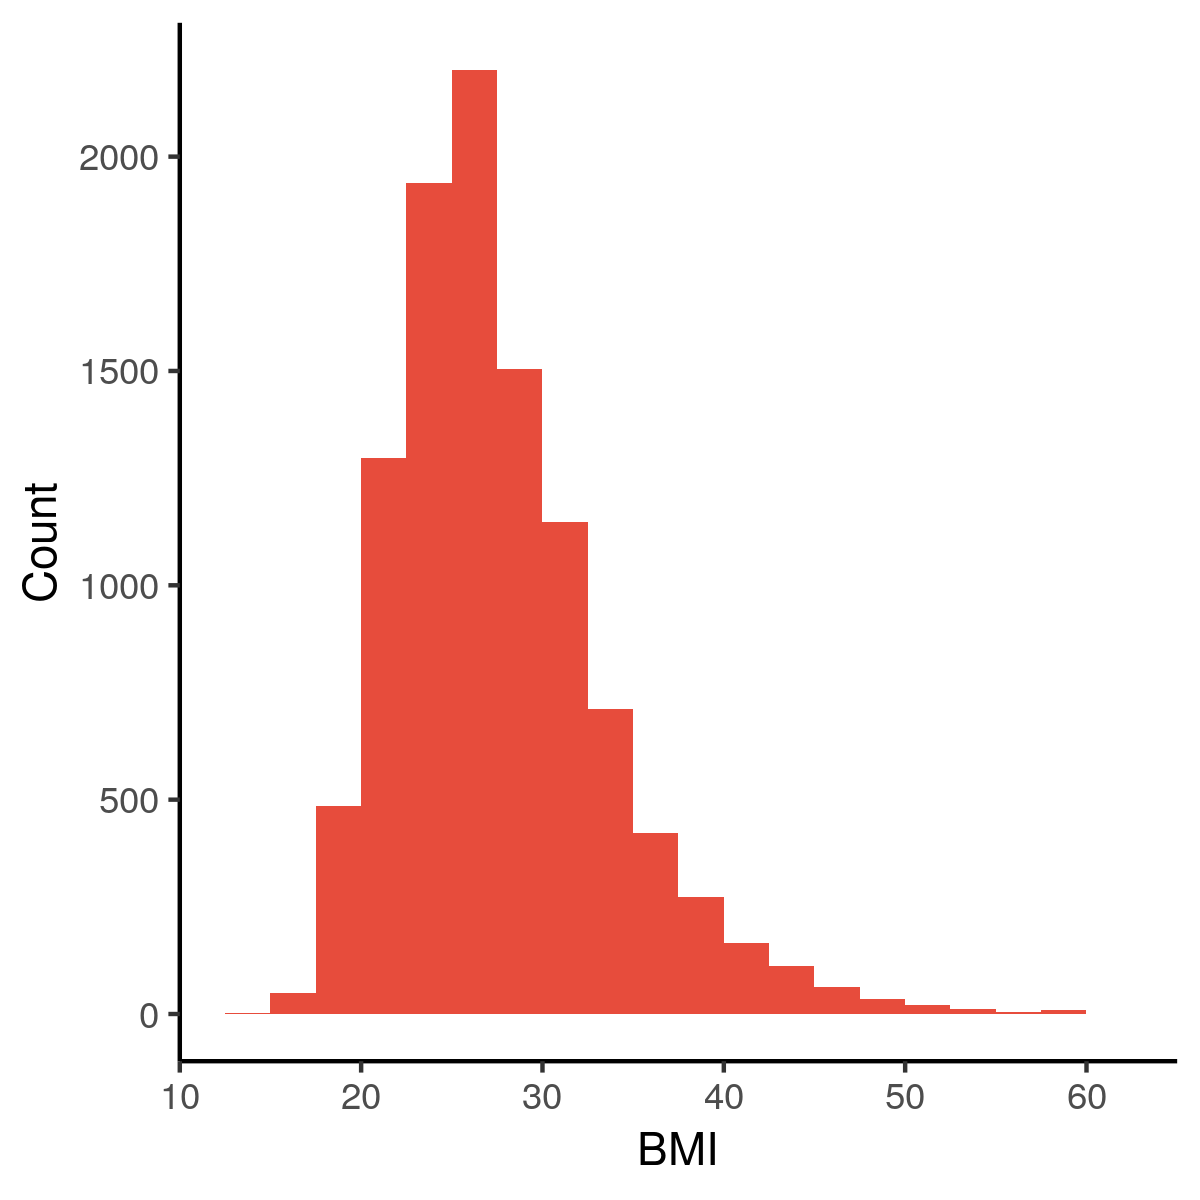
|height| mass| bmi|    bmi = mass / height^2
+------+-----+----+
|  1.52| 77.1|33.2|
|  1.60| 58.1|22.7|
|  1.57|122.0|49.4|
|  1.75| 95.3|31.0|
|  1.80| 99.8|30.7|
|  1.65| 90.7|33.3|
|  1.60| 70.3|27.5|
|  1.78| 81.6|25.8|
|  1.65| 77.1|28.3|
|  1.78|128.0|40.5|
+------+-----+----+
cars = cars.withColumn('density_line', cars.mass / cars.length)       # Linear density
cars = cars.withColumn('density_quad', cars.mass / cars.length**2)    # Area density
cars = cars.withColumn('density_cube', cars.mass / cars.length**3)    # Volume density
+------+------+------------+------------+------------+
|  mass|length|density_line|density_quad|density_cube|
+------+------+------------+------------+------------+
|1451.0| 4.775|303.87434554|63.638606397|13.327456837|
|1129.0| 4.623|244.21371403|52.825808790|11.426737787|
|1399.0| 4.547|307.67539036|67.665579583|14.881367843|
+------+------+------------+------------+------------+