Python 超參數調校
Alex Scriven
Data Scientist
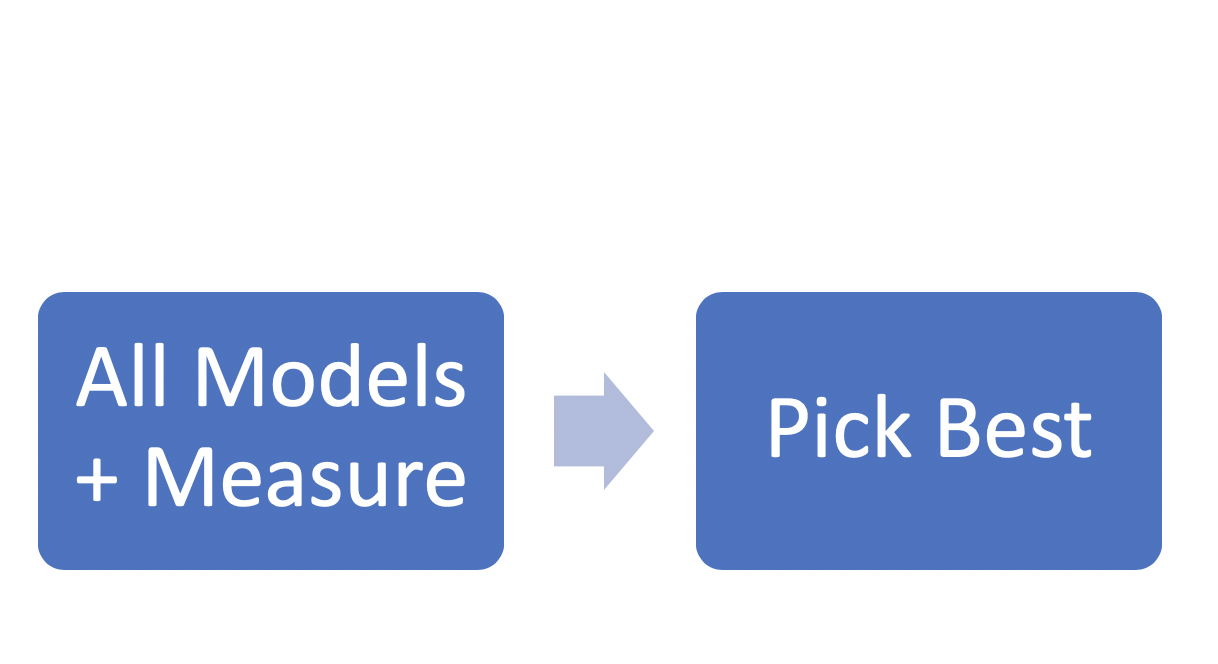
到目前為止,我們做的都是無知情搜尋:
無知情搜尋:每次超參數調校的迭代都不會從先前的結果學習。
這正是我們能平行化的原因。不過這樣效率聽起來不高?
目前流程:

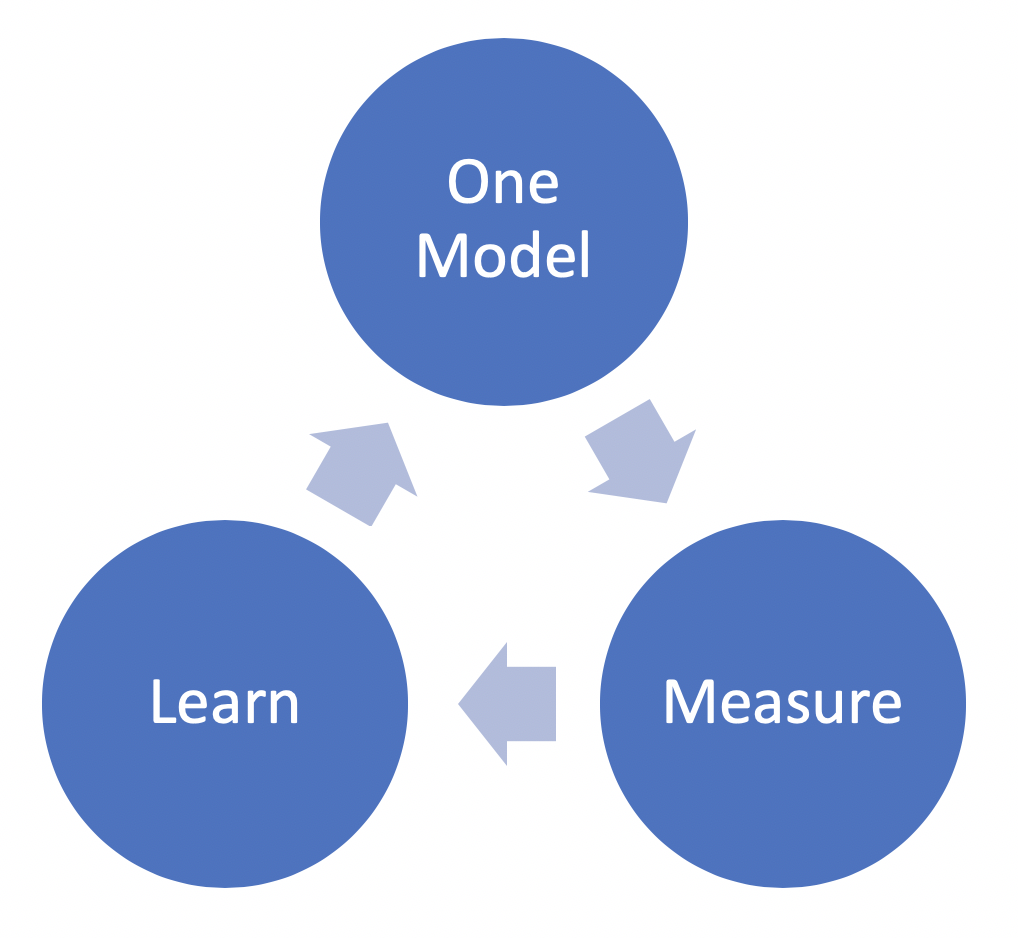
另一種做法:

基本的知情式搜尋方法:
先用粗略、隨機的方式開始,然後逐步縮小並細化搜尋。
流程如下:
你也可以在第(3)步之前,再做幾次隨機搜尋再進網格搜尋。
由粗到細的好處:
不必把時間浪費在表現不佳的搜尋空間!
注意:這是針對批次的知情式,而非單一模型。
來看一個超參數範圍的例子:
max_depth_list 介於 1 到 65min_sample_list 介於 3 到 17learn_rate_list 在 0.01 到 150 間的 150 個值可能有多少個模型?
combinations_list = [list(x) for x in product(max_depth_list, min_sample_list, learn_rate_list)]
print(len(combinations_list))
134400
先對 500 組組合做一次隨機搜尋。
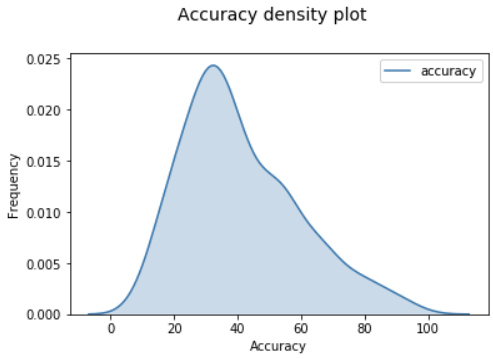
這裡繪出準確率分佈:

哪些模型表現較好?
最佳結果:
| max_depth | min_samples_leaf | learn_rate | accuracy |
|---|---|---|---|
| 10 | 7 | 0.01 | 96 |
| 19 | 7 | 0.023355705 | 96 |
| 30 | 6 | 1.038389262 | 93 |
| 27 | 7 | 1.11852349 | 91 |
| 16 | 7 | 0.597651007 | 91 |
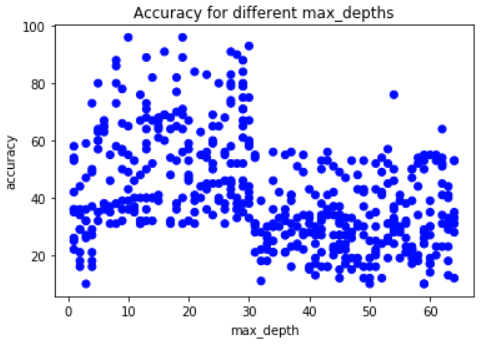
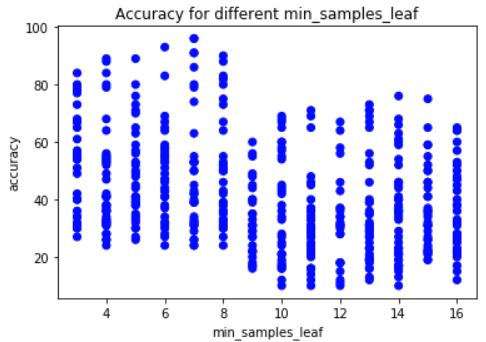
把 max_depth 與準確率畫成圖:

min_samples_leaf 在 8 以下較佳

learn_rate 在 1.3 以上較差
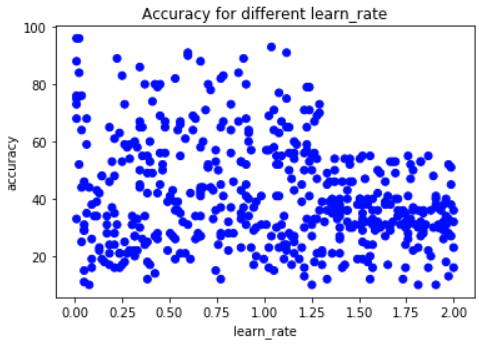
第 1 次迭代後我們知道:
max_depth 介於 8 到 30learn_rate 小於 1.3min_samples_leaf 可能小於 8下一步?用這些資訊再做一次隨機或網格搜尋!
注意:這只是雙變量分析。你也能在一張圖上探索多個超參數(3、4 個或更多),但超出本課程範圍。
Python 超參數調校