Python 超參數調校
Alex Scriven
Data Scientist
與 grid search 非常相似:
但我們改為隨機挑選格子。
Bengio & Bergstra(2012):
本文以實證與理論顯示,隨機挑選的嘗試用於超參數最佳化,比規則格點更有效率。
兩個主因:
Grid search:

要有 95% 的機率挑到綠色區塊之一,得跑多少模型?
我們的最佳模型:
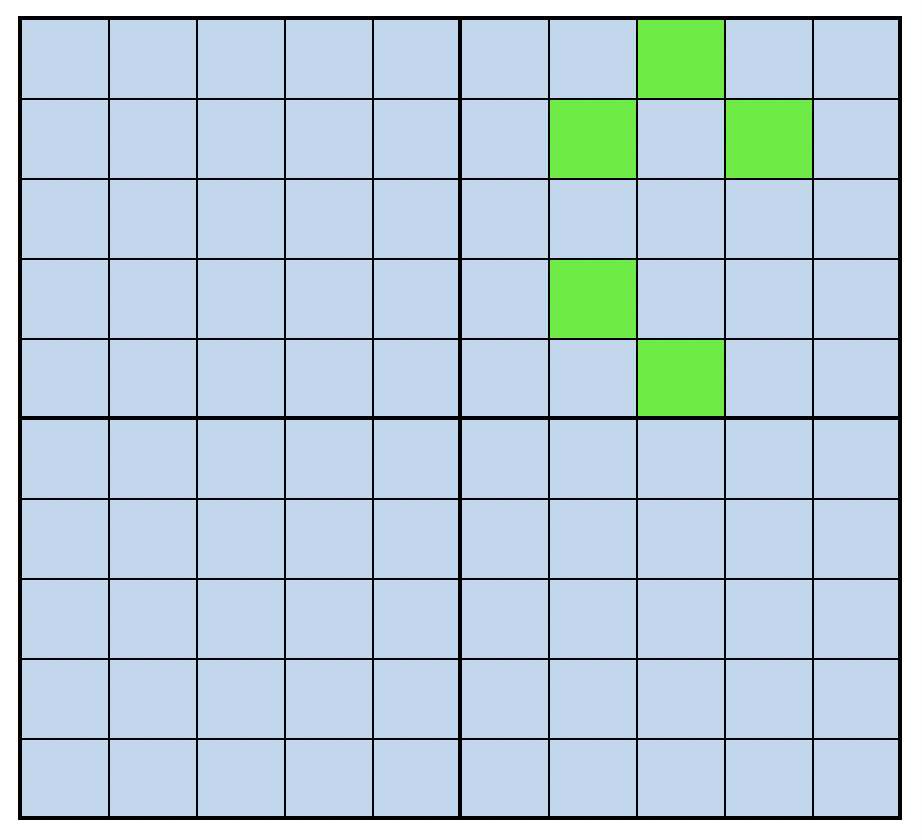
若我們以均勻隨機方式選超參數組合,先算「全部錯過」的機率,來看它有多不可能發生:
第 1 次試驗:成功機率 0.05,錯過機率為 (1 - 0.05)。
事實上,做 n 次試驗時,「每次都錯過」的機率為 (1-0.05)^n。
那要做多少次試驗,才能有高機率(95%)落在該區域內?
這代表什麼?
請記住:
最佳結果仍受你設定的格點所限。
與 grid search 公平比較時,需使用相同的建模「預算」。
我們可以自己建立隨機抽樣的超參數組合:
# Set some hyperparameter lists
learn_rate_list = np.linspace(0.001,2,150)
min_samples_leaf_list = list(range(1,51))
# Create list of combinations
from itertools import product
combinations_list = [list(x) for x in
product(learn_rate_list, min_samples_leaf_list)]
# Select 100 models from our larger set
random_combinations_index = np.random.choice(
range(0,len(combinations_list)), 100,
replace=False)
combinations_random_chosen = [combinations_list[x] for x in
random_combinations_index]
我們也能把超參數選擇畫在 X、Y 軸上,視覺化 random search 的覆蓋範圍。
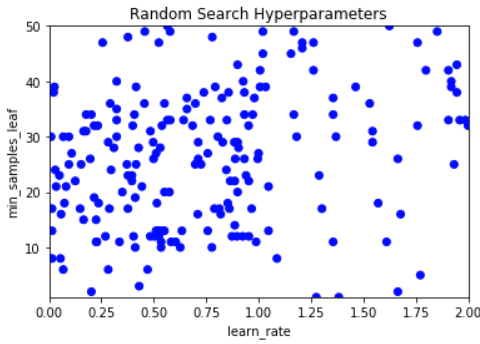
注意:散佈範圍很廣,但深度覆蓋不多。
Python 超參數調校