Python 超參數調校
Alex Scriven
Data Scientist
來分析 GridSearchCV 的輸出。
GridSearchCV 的屬性可分成三組:
cv_results_best_index_、best_params_ 與 best_score_scorer_、n_splits_ 與 refit_time_
使用點記號來存取屬性。
例如:
grid_search_object.property
其中 property 是你要讀取的實際屬性。
cv_results_ 屬性:
讀入 DataFrame 後便於列印與分析:
cv_results_df = pd.DataFrame(grid_rf_class.cv_results_)
print(cv_results_df.shape)
(12, 23)
time 欄位代表模型擬合(與評分)所花的時間。
記得我們做了 5 折交叉驗證嗎?它會執行 5 次,並儲存以秒為單位的平均與標準差。
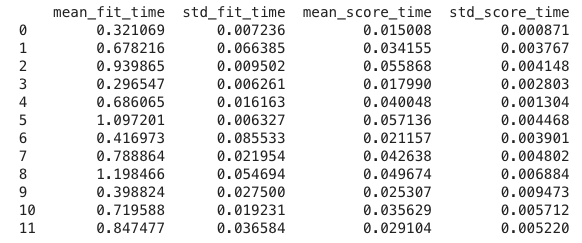
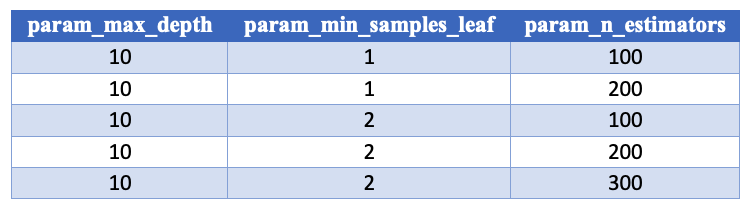
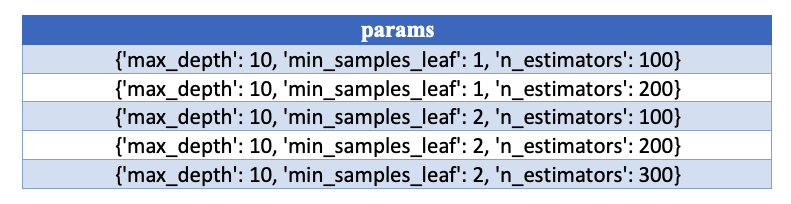
param_ 欄位存放該列所測試的參數,每個參數一欄。

params 欄位包含所有參數的字典:
pd.set_option("display.max_colwidth", -1)
print(cv_results_df.loc[:, "params"])
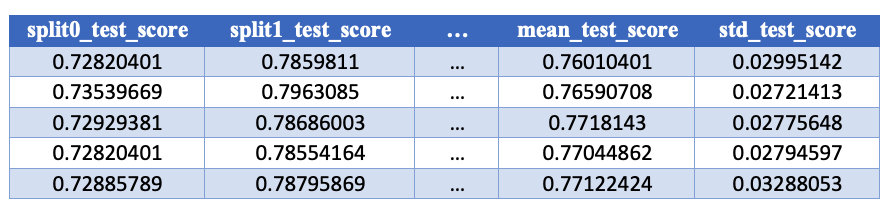
test_score 欄位包含各折在測試集上的分數,以及一些摘要統計:

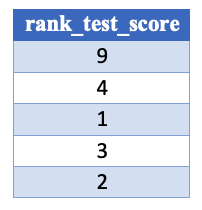
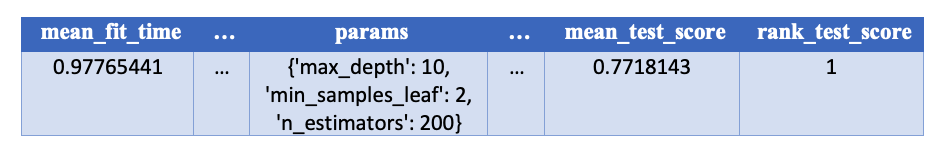
排名欄會依 mean_test_score 由高到低排序:

可用 rank_test_score 欄從 cv_results_ 輕鬆選出最佳網格組合。
best_row = cv_results_df[cv_results_df["rank_test_score"] == 1]
print(best_row)
test_score 欄位接著會對 training_scores 重複出現。
幾點重要提醒:
需將 return_train_score 設為 True 才會包含訓練分數欄。
訓練分數沒有排名欄,因為我們只在意測試集表現。
最佳網格組合的資訊彙整在以下三個屬性:
best_params_,帶來最佳分數的參數字典。
best_score_,實際的最佳分數。
best_index_,在 cv_results_.rank_test_score 中對應最佳的那一列。
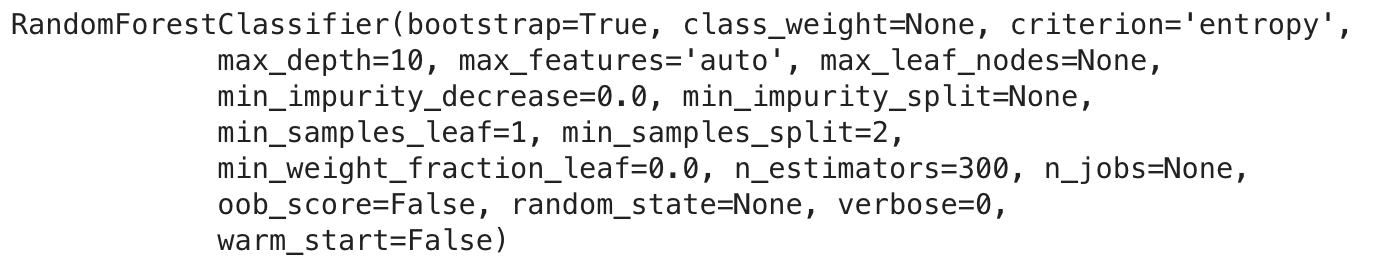
best_estimator_ 屬性是用網格搜尋到的最佳參數訓練出的估計器。
在這裡是 Random Forest 估計器:
type(grid_rf_class.best_estimator_)
sklearn.ensemble.forest.RandomForestClassifier
你也可以直接把這個物件當作估計器使用。
print(grid_rf_class.best_estimator_)

還有一些額外資訊在以下屬性:
scorer_對保留資料所用的評分函式。(我們設為 AUC)
n_splits_交叉驗證的分割數。(我們設為 5)
refit_time_在整個資料集上重新擬合最佳模型所花的秒數。
Python 超參數調校