Python 超參數調校
Alex Scriven
Data Scientist
有些超參數更值得優先調整。
但應該嘗試哪些超參數「數值」呢?
來看看幾個重點提示!
注意互相衝突的超參數選項。
LogisticRegression() 的 solver 與 penalty 存在互斥選項。The 'newton-cg', 'sag' and 'lbfgs' solvers support only l2 penalties.
有些不會明說,而是直接「忽略」(例如 ElasticNet 的 normalize 超參數):
This parameter is ignored when fit_intercept is set to False
務必查閱 Scikit Learn 說明文件!
留意為不同演算法設定「不合理」的數值:
花時間整理超參數的合理範圍很有價值。
在前一個練習中,我們這樣建立模型:
knn_5 = KNeighborsClassifier(n_neighbors=5)
knn_10 = KNeighborsClassifier(n_neighbors=10)
knn_20 = KNeighborsClassifier(n_neighbors=20)
這樣效率不高。能更好嗎?
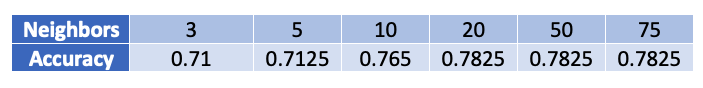
用 for 迴圈逐一嘗試選項:
neighbors_list = [3,5,10,20,50,75]accuracy_list = []for test_number in neighbors_list: model = KNeighborsClassifier(n_neighbors=test_number) predictions = model.fit(X_train, y_train).predict(X_test)accuracy = accuracy_score(y_test, predictions) accuracy_list.append(accuracy)
把結果存成 DataFrame 檢視:
results_df = pd.DataFrame({'neighbors':neighbors_list, 'accuracy':accuracy_list})
print(results_df)
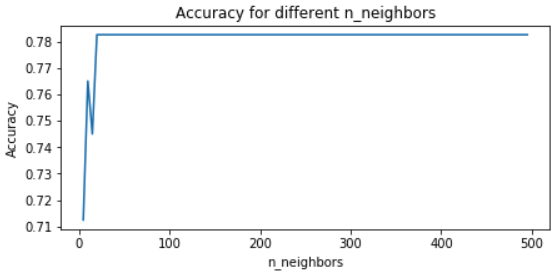
來畫學習曲線圖。
這次要測更多數值。
neighbors_list = list(range(5,500, 5))accuracy_list = [] for test_number in neighbors_list: model = KNeighborsClassifier(n_neighbors=test_number) predictions = model.fit(X_train, y_train).predict(X_test) accuracy = accuracy_score(y_test, predictions) accuracy_list.append(accuracy) results_df = pd.DataFrame({'neighbors':neighbors_list, 'accuracy':accuracy_list})
把較大的 DataFrame 視覺化:
plt.plot(results_df['neighbors'], results_df['accuracy'])# 加上標籤與標題 plt.gca().set(xlabel='n_neighbors', ylabel='Accuracy', title='Accuracy for different n_neighbors') plt.show()
我們的圖:

Python 的 range 函式不支援小數步長。
一個好用的小技巧是使用 NumPy 的 np.linspace(start, end, num)。
start、end)內等距的 num 個數值。print(np.linspace(1,2,5))
[1. 1.25 1.5 1.75 2. ]
Python 超參數調校