Scikit Learn 的隨機搜尋
Python 超參數調校

Alex Scriven
Data Scientist
與 GridSearchCV 比較
不用重新發明輪子。先回顧 Grid Search 的步驟:
- 決定演算法/估計器
- 定義要調的超參數
- 為每個超參數設定取值範圍
- 設定交叉驗證方案;以及
- 定義評分函式
- 加入其他實用資訊或函式
與 Grid Search 比較
只有一個差異:
- 第 7 步=決定要抽取的樣本數(然後抽樣)
就是這樣!(大致上)
比較 Scikit Learn 模組
這兩個模組也很像:
GridSearchCV:
sklearn.model_selection.GridSearchCV(estimator, param_grid,
        scoring=None, fit_params=None,
        n_jobs=None,
        refit=True, cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        error_score='raise-deprecating',
        return_train_score='warn')
RandomizedSearchCV:
sklearn.model_selection.RandomizedSearchCV(estimator,
        param_distributions, n_iter=10,
        scoring=None, fit_params=None,
        n_jobs=None, refit=True,
        cv='warn', verbose=0,
        pre_dispatch='2*n_jobs',
        random_state=None,
        error_score='raise-deprecating',
        return_train_score='warn')
關鍵差異
兩個關鍵差異:
n_iter是隨機搜尋要從你的網格中抽取的樣本數。上一個例子你用了 300。param_distributions與param_grid略有不同,允許(選擇性地)設定抽樣的分佈。- 預設是所有組合被選中的機率相同。
建立 RandomizedSearchCV 物件
現在我們可以像建立 grid search 一樣建立隨機搜尋物件,但加上一個小改動:
# Set up the sample space learn_rate_list = np.linspace(0.001,2,150) min_samples_leaf_list = list(range(1,51)) # Create the grid parameter_grid = { 'learning_rate' : learn_rate_list, 'min_samples_leaf' : min_samples_leaf_list}# Define how many samples number_models = 10
建立 RandomizedSearchCV 物件
現在來建立這個物件:
# Create a random search object
random_GBM_class = RandomizedSearchCV(
    estimator = GradientBoostingClassifier(),
    param_distributions = parameter_grid,
    n_iter = number_models,
    scoring='accuracy',
    n_jobs=4,
    cv = 10,
    refit=True,
    return_train_score = True)
# Fit the object to our data
random_GBM_class.fit(X_train, y_train)
分析輸出結果
輸出完全一樣!
要怎麼看選到了哪些超參數值?
看 cv_results_ 字典(對應的 param_ 欄位)!
把清單取出來:
rand_x = list(random_GBM_class.cv_results_['param_learning_rate'])
rand_y = list(random_GBM_class.cv_results_['param_min_samples_leaf'])
分析輸出結果
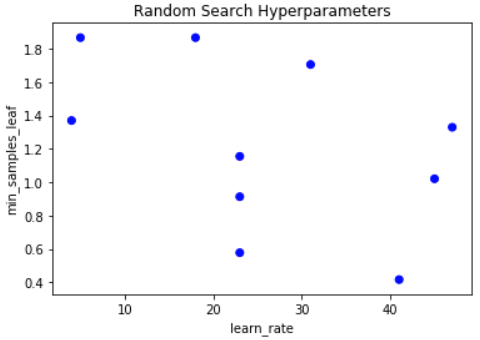
建立視覺化:
# Make sure we set the limits of Y and X appriately x_lims = [np.min(learn_rate_list), np.max(learn_rate_list)] y_lims = [np.min(min_samples_leaf_list), np.max(min_samples_leaf_list)]# Plot grid results plt.scatter(rand_y, rand_x, c=['blue']*10) plt.gca().set(xlabel='learn_rate', ylabel='min_samples_leaf', title='Random Search Hyperparameters') plt.show()
分析輸出結果
與先前類似的圖:
一起來練習吧!
Python 超參數調校

