使用 spaCy 的 RegEx

使用 spaCy 的自然語言處理

Azadeh Mobasher

Principal Data Scientist

什麼是 RegEx?


  • 規則式資訊擷取(IR)對許多 NLP 任務很實用
  • Regular expressionRegEx)用於複雜的字串比對樣式
  • RegEx 可尋找擷取樣式,或取代符合的樣式

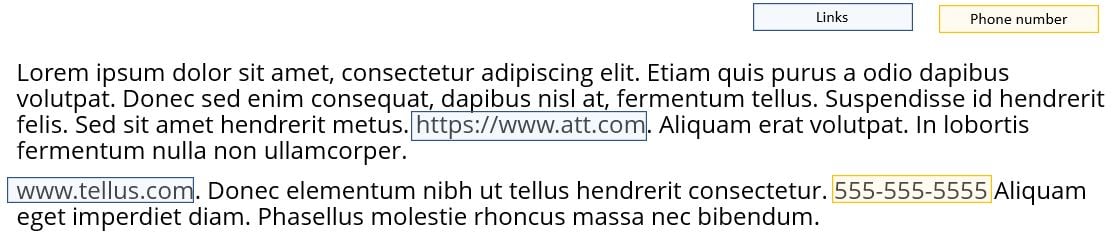
RegEx:連結與電話資訊擷取

使用 spaCy 的自然語言處理

RegEx 的優缺點

優點

  • 能撰寫穩健規則來擷取資訊
  • 可找出字串中的多種變化
  • 執行速度快
  • 多數程式語言支援

缺點

  • 語法對初學者不易
  • 需要了解樣式在文本中可能出現的各種寫法
使用 spaCy 的自然語言處理

Python 中的 RegEx


  • Python 內建 RegEx 函式庫 re
  • 使用 re 套件的第一步是定義 pattern
  • 產生的樣式可用來尋找相符內容。


import re

pattern = r"((\d){3}-(\d){3}-(\d){4})"
text = "Our phone number is 832-123-5555 and their phone number is 425-123-4567."
使用 spaCy 的自然語言處理

Python 中的 RegEx


  • 我們使用 re 套件的 .finditer() 方法
iter_matches = re.finditer(pattern, text)

for match in iter_matches: start_char = match.start() end_char = match.end()
print ("Start character: ", start_char, "| End character: ", end_char, "| Matching text: ", text[start_char:end_char])
>>> Start character:  20 | End character:  32 | Matching text:  832-123-5555
Start character:  59 | End character:  71 | Matching text:  425-123-4567
使用 spaCy 的自然語言處理

spaCy 中的 RegEx

  • 在三個管線元件中使用 RegExMatcherPhraseMatcherEntityRuler
text = "Our phone number is 832-123-5555 and their phone number is 425-123-4567."

nlp = spacy.blank("en") patterns = [{"label": "PHONE_NUMBER", "pattern": [{"SHAPE": "ddd"}, {"ORTH": "-"}, {"SHAPE": "ddd"}, {"ORTH": "-"}, {"SHAPE": "dddd"}]}]
ruler = nlp.add_pipe("entity_ruler") ruler.add_patterns(patterns) doc = nlp(text) print ([(ent.text, ent.label_) for ent in doc.ents])
>>> [('832-123-5555', 'PHONE_NUMBER'), ('425-123-4567', 'PHONE_NUMBER')]
使用 spaCy 的自然語言處理

一起來練習吧!

使用 spaCy 的自然語言處理

Preparing Video For Download...