import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
import numpy as np

nlp = spacy.load("en_core_web_md")
擷取給定單字清單的詞向量並縱向堆疊。
words = ["wonderful", "horrible",
           "apple", "banana", "orange", "watermelon",
           "dog", "cat"]
word_vectors = np.vstack([nlp.vocab.vectors[nlp.vocab.strings[w]] for w in words])
plt.figure(figsize=(10, 8))
plt.scatter(word_vectors_transformed[:, 0], word_vectors_transformed[:, 1])

for word, coord in zip(words, word_vectors_transformed):
    x, y = coord
    plt.text(x, y, word, size=10)
plt.show()
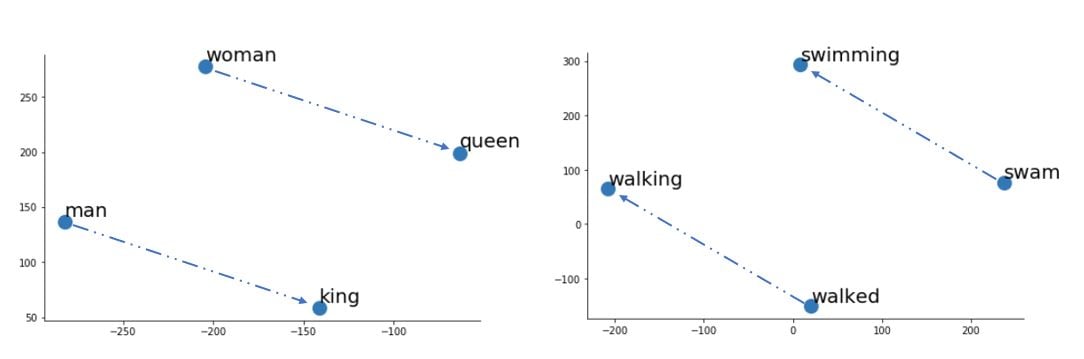
類比與向量運算
一對單字之間的語意關係。
詞嵌入可產生性別、時態等類比:
queen - woman + man = king
辭彙中的相似單字
spaCy 可找出給定詞的「語意相近詞」
import numpy as np
import spacy
nlp = spacy.load("en_core_web_md")

word = "covid"

most_similar_words = nlp.vocab.vectors.most_similar(
    np.asarray([nlp.vocab.vectors[nlp.vocab.strings[word]]]), n=5)

words = [nlp.vocab.strings[w] for w in most_similar_words[0][0]]
print(words)