spaCy 基礎

使用 spaCy 的自然語言處理

Azadeh Mobasher

Principal Data Scientist

spaCy NLP 管線

import spacy

nlp = spacy.load("en_core_web_sm")
doc = nlp("Here's my spaCy pipeline.")
  • 匯入 spaCy
  • spacy.load() 取得 nlp,一個 Language 類別
    • Language 物件是文字處理的管線
  • 對任意文字呼叫 nlp() 可得到 Doc 容器
使用 spaCy 的自然語言處理

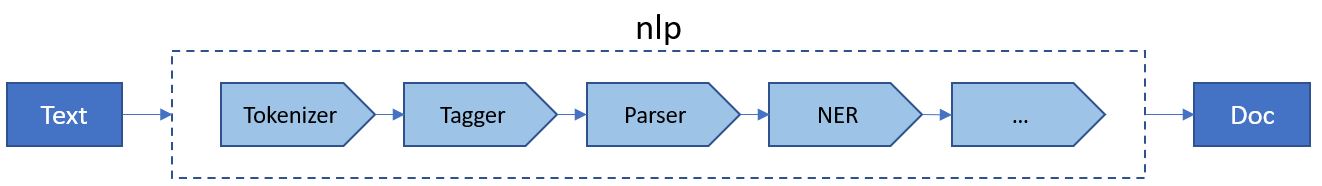
spaCy NLP 管線


spaCy 透過其 Language 類別執行多個處理步驟:

spaCy 語言管線

使用 spaCy 的自然語言處理

spaCy 的容器物件

  • spaCy 中有多種結構可表示文字資料:


Name Description
Doc 存取文字語言註記的容器
Span Doc 物件的一段切片
Token 個別權標,例如單字、標點、空白等
使用 spaCy 的自然語言處理

管線元件

  • spaCy 的語言處理管線取決於所載入模型及其能力。


Component Name Description
Tokenizer Tokenizer 將文字切成權標並建立 Doc 物件
Tagger Tagger 指派詞性標記
Lemmatizer Lemmatizer 將單字還原成詞元(原形)
EntityRecognizer NER 偵測並標注具名實體
使用 spaCy 的自然語言處理

管線元件


  • 各元件有其處理文字的專長功能

    • Language
    • DependencyParser
    • Sentencizer
使用 spaCy 的自然語言處理

Tokenization(斷詞)

  • 永遠是第一步
  • 其他作業都需要權標
  • 權標可為單字、數字與標點
import spacy
nlp = spacy.load("en_core_web_sm")

doc = nlp("Tokenization splits a sentence into its tokens.")

print([token.text for token in doc])
['Tokenization', 'splits', 'a', 'sentence', 'into', 'its', 'tokens', '.']
使用 spaCy 的自然語言處理

句子切分

  • 比斷詞更複雜
  • DependencyParser 元件的一部分
import spacy
nlp = spacy.load("en_core_web_sm")

text = "We are learning NLP. This course introduces spaCy."
doc = nlp(text)

for sent in doc.sents: print(sent.text)
We are learning NLP.
This course introduces spaCy.
使用 spaCy 的自然語言處理

Lemmatization(詞形還原)

  • 「lemma」是權標的原形
  • eatsate 的 lemma 為 eat
  • 有助提升語言模型的準確度
import spacy
nlp = spacy.load("en_core_web_sm")
doc = nlp("We are seeing her after one year.")

print([(token.text, token.lemma_) for token in doc])
[('We', 'we'), ('are', 'be'), ('seeing', 'see'), ('her', 'she'), 
('after', 'after'), ('one', 'one'), ('year', 'year'), ('.', '.')]
使用 spaCy 的自然語言處理

一起來練習吧!

使用 spaCy 的自然語言處理

Preparing Video For Download...