spaCy 管線

使用 spaCy 的自然語言處理

Azadeh Mobasher

Principal Data Scientist

spaCy 管線


  • spaCy 會先將文字斷詞,產生一個 Doc 物件。
  • Doc 會經過多個步驟的處理管線處理。


import spacy
nlp = spacy.load("en_core_web_sm")

doc = nlp(example_text)
使用 spaCy 的自然語言處理

spaCy 管線

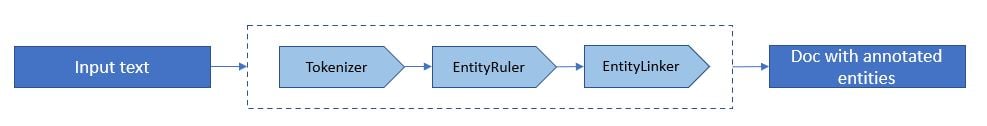
  • 管線是一連串的 pipes,也就是對資料進行處理的元件。
  • spaCyNER 管線包含:
    • 斷詞(Tokenization)
    • 具名實體辨識
    • 具名實體分類  

spaCy 的 NER 管線範例

print([ent.text for ent in doc.ents])
使用 spaCy 的自然語言處理

加入管線元件


  • sentencizerspaCy 的句子切分管線元件。
text = " ".join(["This is a test sentence."]*10000)

en_core_sm_nlp = spacy.load("en_core_web_sm") start_time = time.time() doc = en_core_sm_nlp(text)
print(f"Finished processing with en_core_web_sm model in {round((time.time() - start_time)/60.0 , 5)} minutes")
>>> Finished processing with en_core_web_sm model in 0.09332 minutes
使用 spaCy 的自然語言處理

加入管線元件


  • 建立空白模型並加入 sentencizer 元件:
blank_nlp = spacy.blank("en")

blank_nlp.add_pipe("sentencizer")
start_time = time.time() doc = blank_nlp(text) print(f"Finished processing with blank model in {round((time.time() - start_time)/60.0 , 5)} minutes")
>>> Finished processing with blank model in 0.00091 minutes
使用 spaCy 的自然語言處理

分析管線元件

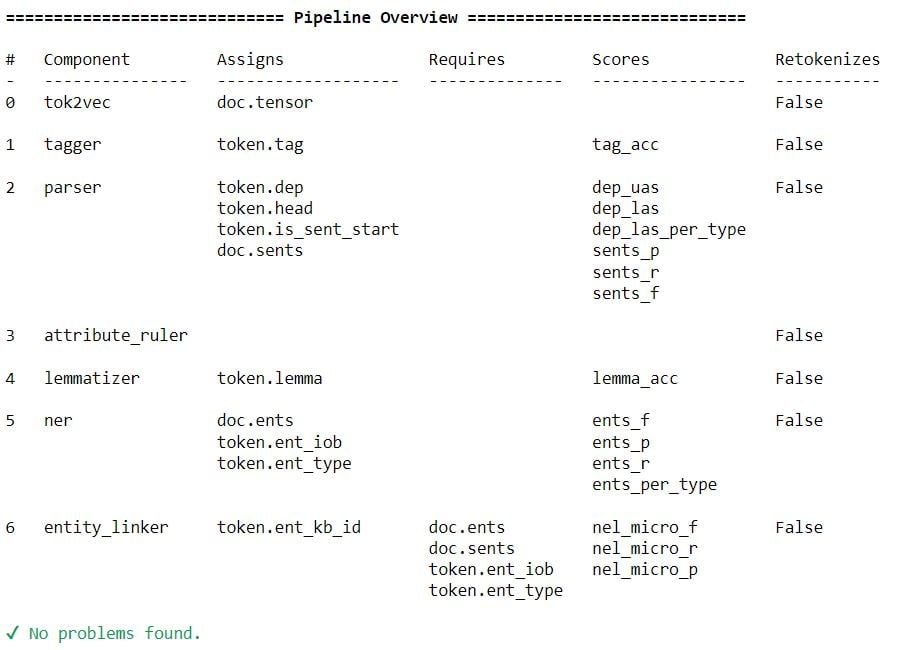
  • nlp.analyze_pipes() 會分析 spaCy 管線以判斷:
    • 各元件設定了哪些屬性
    • 元件在訓練期間產生的分數
    • 是否具備所有必要屬性


  • pretty 設為 True 會印出表格,而不只回傳結構化資料。
import spacy

nlp = spacy.load("en_core_web_sm")
analysis = nlp.analyze_pipes(pretty=True)
使用 spaCy 的自然語言處理

分析管線元件

analyze_pipes 方法的結果

使用 spaCy 的自然語言處理

一起來練習吧!

使用 spaCy 的自然語言處理

Preparing Video For Download...