總結
使用 spaCy 的自然語言處理

Azadeh Mobasher
Principal data scientist
第 1 章-NLP 與 spaCy 入門
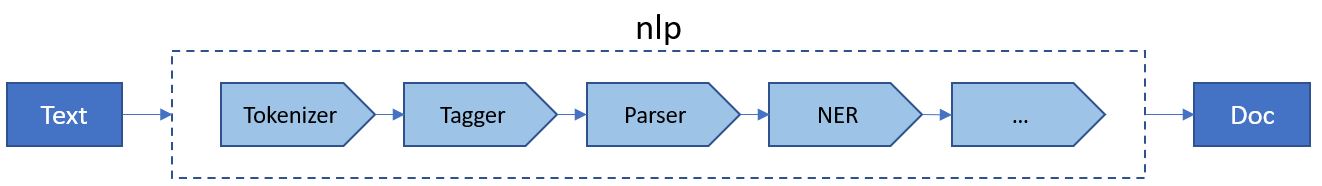
- 使用
spaCy的文字處理 pipeline 萃取語言特徵:
第 2 章-spaCy 語言標註與詞向量
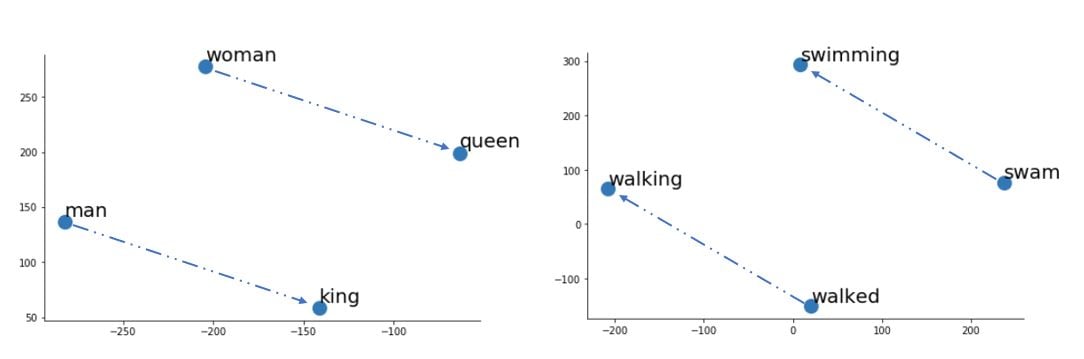
- 操作
spaCy的Doc、Token、Span類別,並用詞向量預測語意相似度:
第 4 章-自訂 spaCy 模型
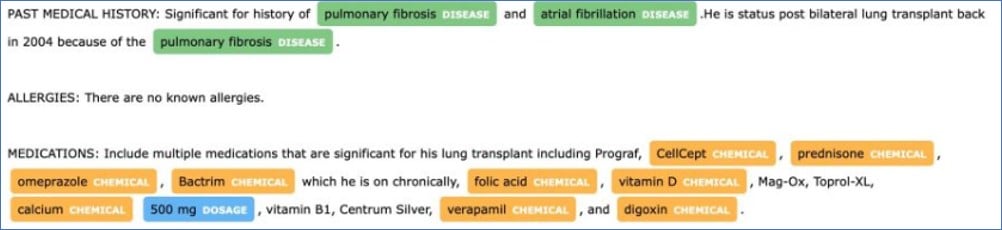
- 標註並準備資料以進行訓練
- 訓練
spaCy模型並在推論時使用
使用 spaCy 的自然語言處理
Azadeh Mobasher
Principal data scientist
spaCy 的文字處理 pipeline 萃取語言特徵:
spaCy 的 Doc、Token、Span 類別,並用詞向量預測語意相似度:
spaCy 模型並在推論時使用

