自然語言處理(NLP)基礎

使用 spaCy 的自然語言處理

Azadeh Mobasher

Principal Data Scientist

自然語言處理(NLP)
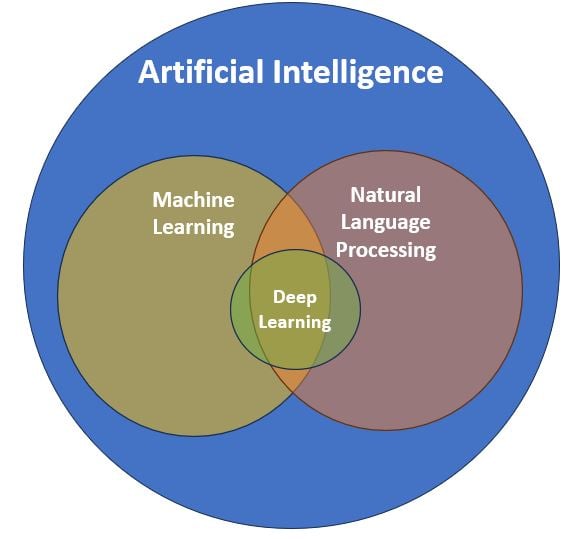
 

  • 人工智慧(AI) 的一個子領域
  • 協助電腦理解人類語言
  • 從非結構化資料中擷取洞見
  • 結合 統計學機器學習模型深度學習模型


NLP,AI 的子領域

使用 spaCy 的自然語言處理

NLP 應用案例

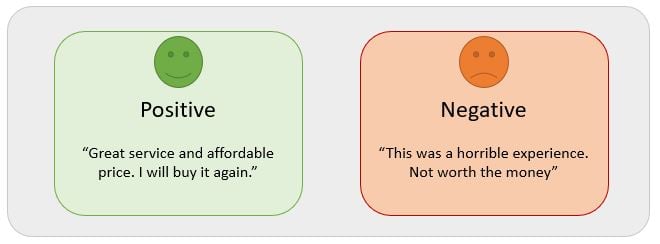
情感分析  

  • 使用電腦判定文字的主觀情緒傾向


情感分析範例

使用 spaCy 的自然語言處理

NLP 應用案例

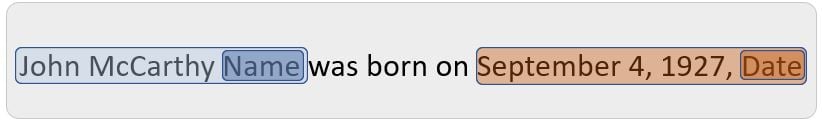
命名實體辨識(NER)  

  • 在非結構化文本中定位並分類命名實體到預先定義的類別
  • 命名實體 是真實世界的物件,如人名或地名


NER 範例

使用 spaCy 的自然語言處理

NLP 應用案例


  • 產生類人回應的對話系統,如 ChatGPT


聊天機器人

使用 spaCy 的自然語言處理

spaCy 簡介

spaCy 是 免費開源Python NLP 函式庫,具備:

  • 資訊擷取 系統而設計
  • 提供可直接上線的 NLP 程式碼
  • 支援 64+ 種語言
  • 穩健快速,並含 視覺化函式庫


spaCy 與 NLP

使用 spaCy 的自然語言處理

安裝並匯入 spaCy


  • 第一步,可用 Python 套件管理工具 pip 安裝 spaCy
  • 可下載 spaCy 的訓練模型
  • 英文有多個已訓練模型,可至 spacy.io 取得


$ python3 pip install spacy
python3 -m spacy download en_core_web_sm
import spacy
nlp = spacy.load("en_core_web_sm")
使用 spaCy 的自然語言處理

用 spaCy 讀取並處理文本

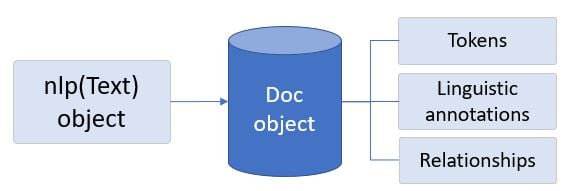
  • 載入 spaCy 模型 en_core_web_sm 後得到 nlp 物件
  • nlp 物件將文字轉為儲存處理後文本的 Doc 物件(容器)

使用 spaCy 進行文字處理

使用 spaCy 的自然語言處理

spaCy 實作

  • 使用 spaCy處理字串
import spacy
nlp = spacy.load("en_core_web_sm")
text = "A spaCy pipeline object is created."
doc = nlp(text)
  • 斷詞(Tokenization)
    • Token 定義為文字中最小且有意義的單位。
    • Tokenization:將文本切分成有意義 token 的過程
print([token.text for token in doc])
['A', 'spaCy', 'pipeline', 'object', 'is', 'created', '.']
使用 spaCy 的自然語言處理

一起來練習吧!

使用 spaCy 的自然語言處理

Preparing Video For Download...