不同模態的前處理

使用 Hugging Face 的多模態模型

James Chapman

Curriculum Manager, DataCamp

文字前處理
範例文字字串。

  • Tokenizer:將文字對應為模型輸入
使用 Hugging Face 的多模態模型

文字前處理

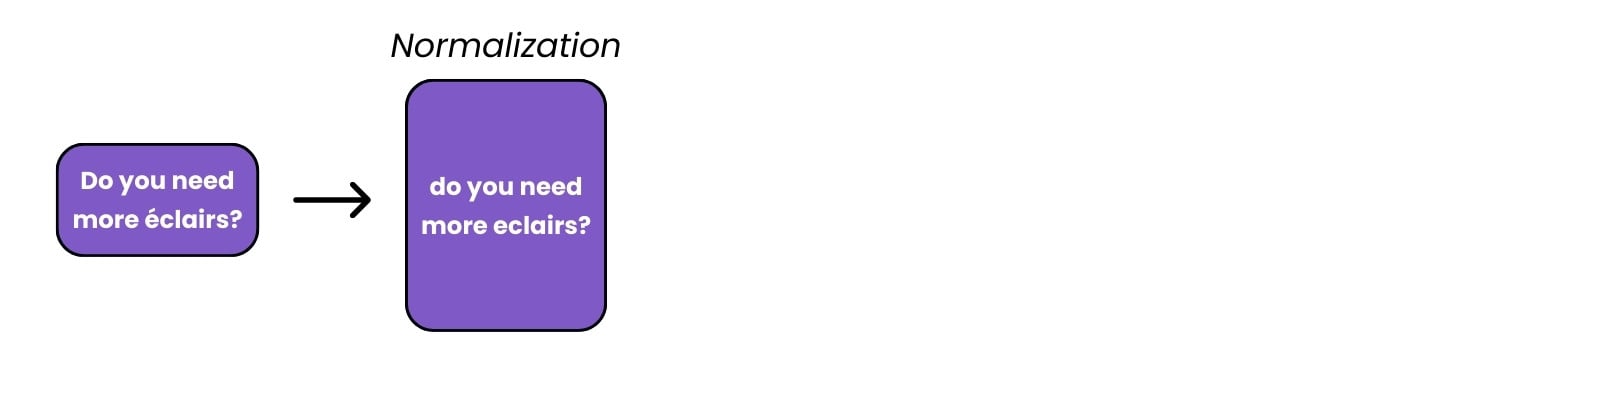
文字前處理到正規化的流程圖

  • Tokenizer:將文字對應為模型輸入
    • Normalization:轉小寫、移除特殊字元、移除多餘空白
使用 Hugging Face 的多模態模型

文字前處理

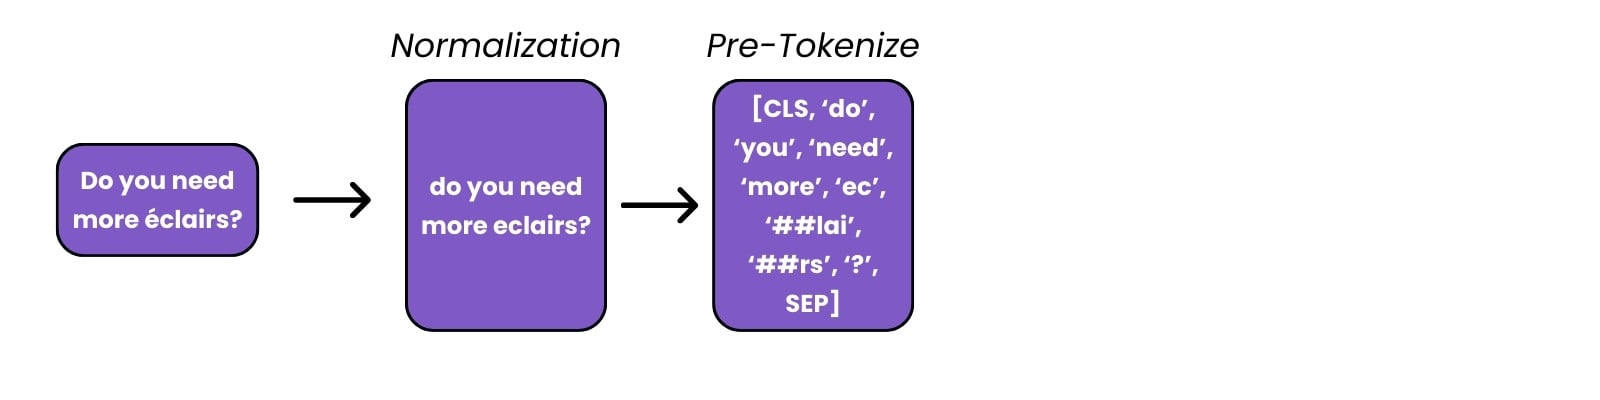
流程圖延伸到分詞

  • Tokenizer:將文字對應為模型輸入
    • Normalization:轉小寫、移除特殊字元、移除多餘空白
    • (預)分詞:將文字切成字詞/次詞
使用 Hugging Face 的多模態模型

文字前處理

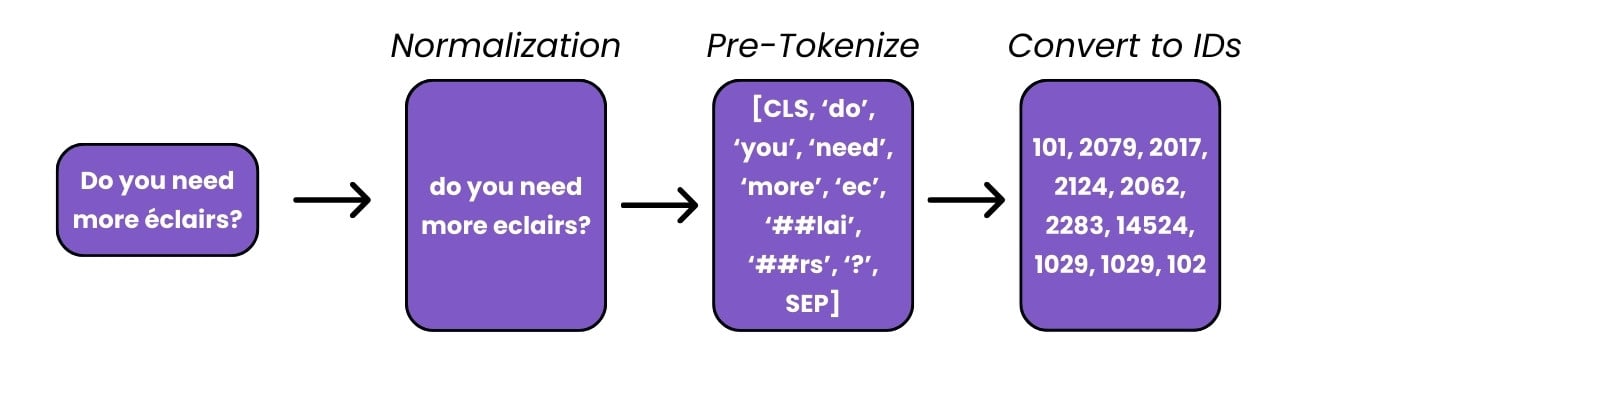
流程圖延伸到 ID 轉換與補齊

  • Tokenizer:將文字對應為模型輸入
    • Normalization:轉小寫、移除特殊字元、空白
    • (預)分詞:將文字切成字詞/次詞
    • ID 轉換:用詞彙表將 token 對應為整數
使用 Hugging Face 的多模態模型

文字前處理

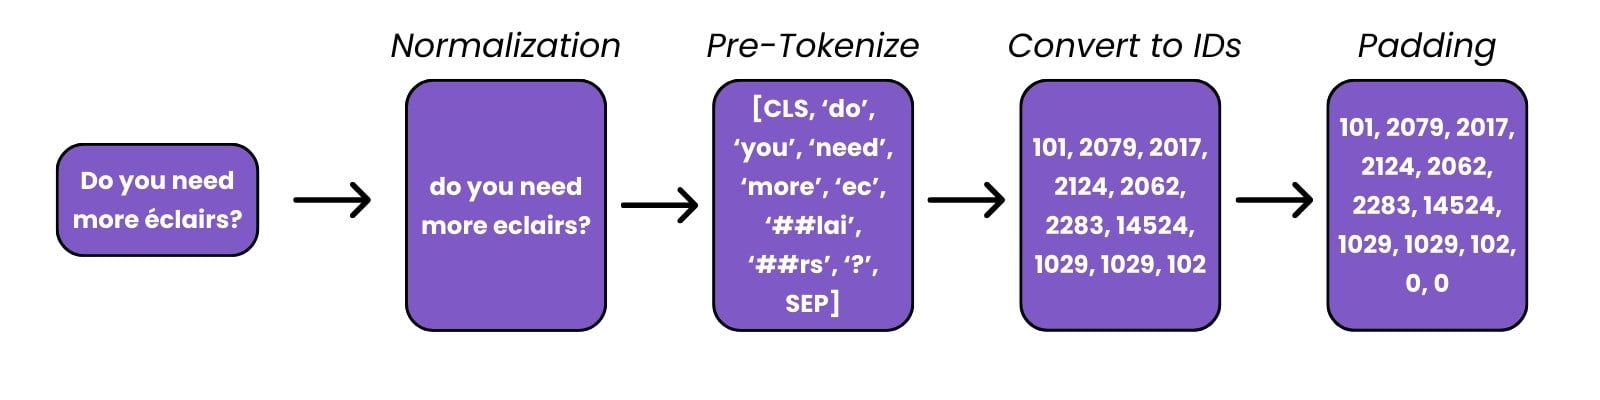
preprocessing_text5.jpg

  • Tokenizer:將文字對應為模型輸入
    • Normalization:轉小寫、移除特殊字元、空白
    • (預)分詞:將文字切成字詞/次詞
    • ID 轉換:用詞彙表將 token 對應為整數
    • 補齊(Padding):加入額外 token 使長度一致
使用 Hugging Face 的多模態模型

文字前處理

from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained('distilbert/distilbert-base-uncased')

text = "Do you need more éclairs?"
print(tokenizer.backend_tokenizer.normalizer.normalize_str(text))
do you need more eclairs
tokenizer(text, return_tensors='pt', padding=True)
{'input_ids': tensor([[  101,  ..., 102]]), ...}
使用 Hugging Face 的多模態模型

影像前處理

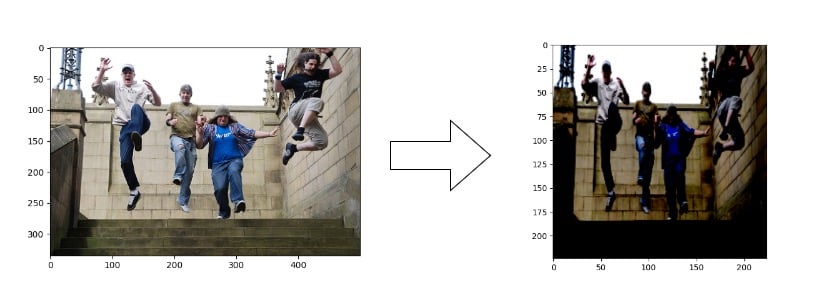
  • Normalization:像素強度調整
  • Resize:符合模型輸入層
  • 通則 → 使用原模型的前處理

多人跳躍影像在前處理前後的比較

1 https://huggingface.co/datasets/nlphuji/flickr30k
使用 Hugging Face 的多模態模型

影像前處理

多模態任務需要「一致的前處理」:

from transformers import BlipProcessor, BlipForConditionalGeneration

checkpoint = "Salesforce/blip-image-captioning-base"
model = BlipForConditionalGeneration.from_pretrained(checkpoint) processor = BlipProcessor.from_pretrained(checkpoint)

編碼影像 → 轉為文字編碼 → 解碼文字

image = load_dataset("nlphuji/flickr30k")['test'][11]["image"]
inputs = processor(images=image, return_tensors="pt")

output = model.generate(**inputs)
print(processor.decode(output[0]))
[{'generated_text': 'a group of people jumping'}]
使用 Hugging Face 的多模態模型

音訊前處理

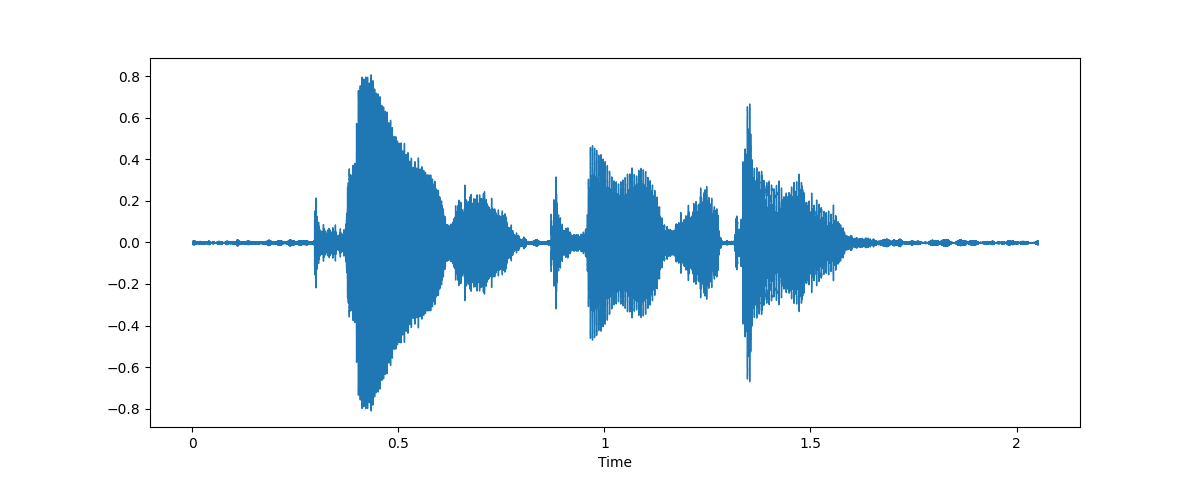
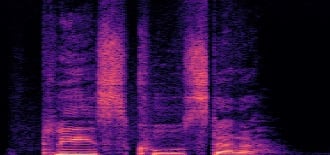
音訊頻譜

  • 音訊前處理:
    • 序列陣列 → 濾波/補齊
    • 取樣率 → 重取樣

擷取特徵作為模型輸入(spectrogram

spectro

使用 Hugging Face 的多模態模型

音訊前處理

from datasets import load_dataset, Audio

dataset = load_dataset("CSTR-Edinburgh/vctk")["train"] dataset = dataset.cast_column("audio", Audio(sampling_rate=16_000))
  • 應能取得模型專用的完整前處理器:
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("openai/whisper-small")
audio_pp = processor(dataset[0]["audio"]["array"], 
                     sampling_rate=16_000, return_tensors="pt")
  • 取樣率必須符合模型輸入需求
1 https://huggingface.co/datasets/CSTR-Edinburgh/vctk
使用 Hugging Face 的多模態模型

一起來練習吧!

使用 Hugging Face 的多模態模型

Preparing Video For Download...