事件來源對應與串流處理

使用 AWS Lambda 的無伺服器應用程式

Claudio Canales

Senior DevOps Engineer

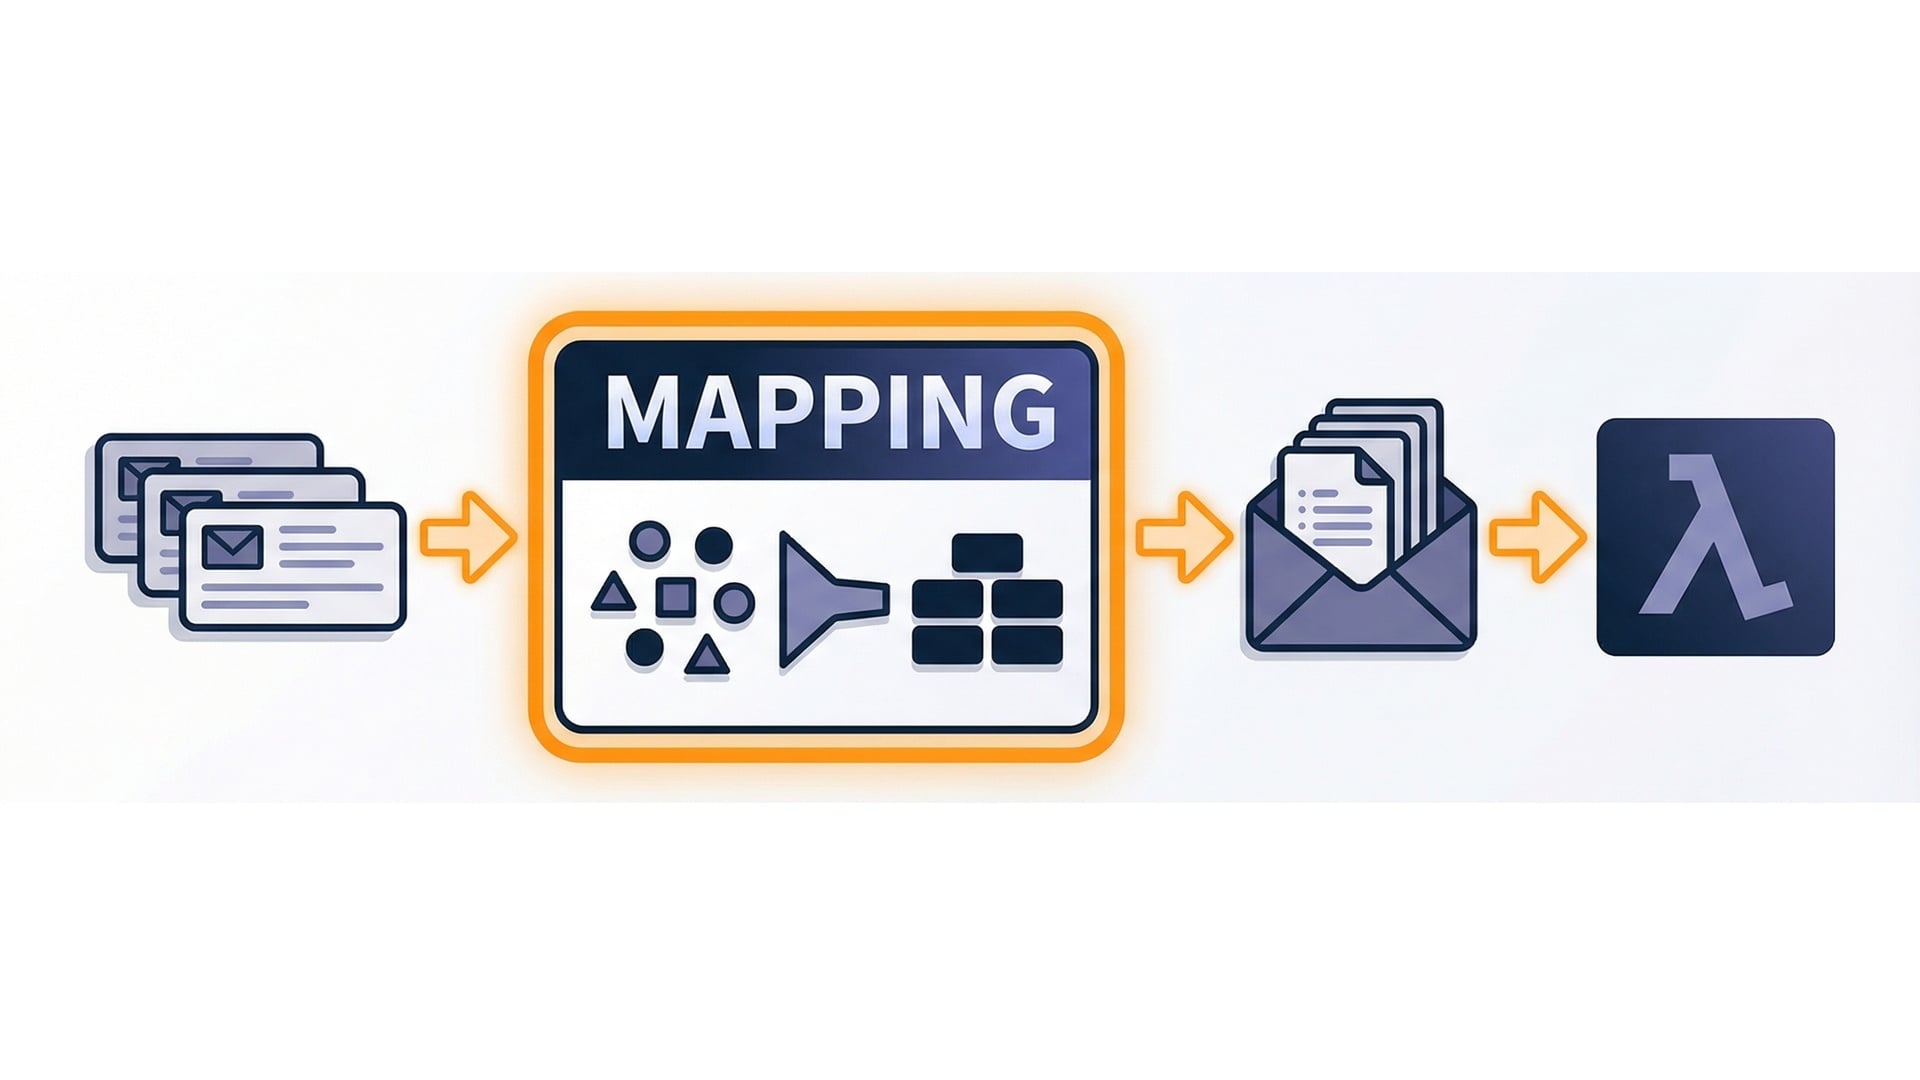
事件來源對應的定位

  • 佇列與串流通常以批次輪詢。
  • 事件來源對應管理輪詢與批次行為。

事件來源對應的位置

使用 AWS Lambda 的無伺服器應用程式

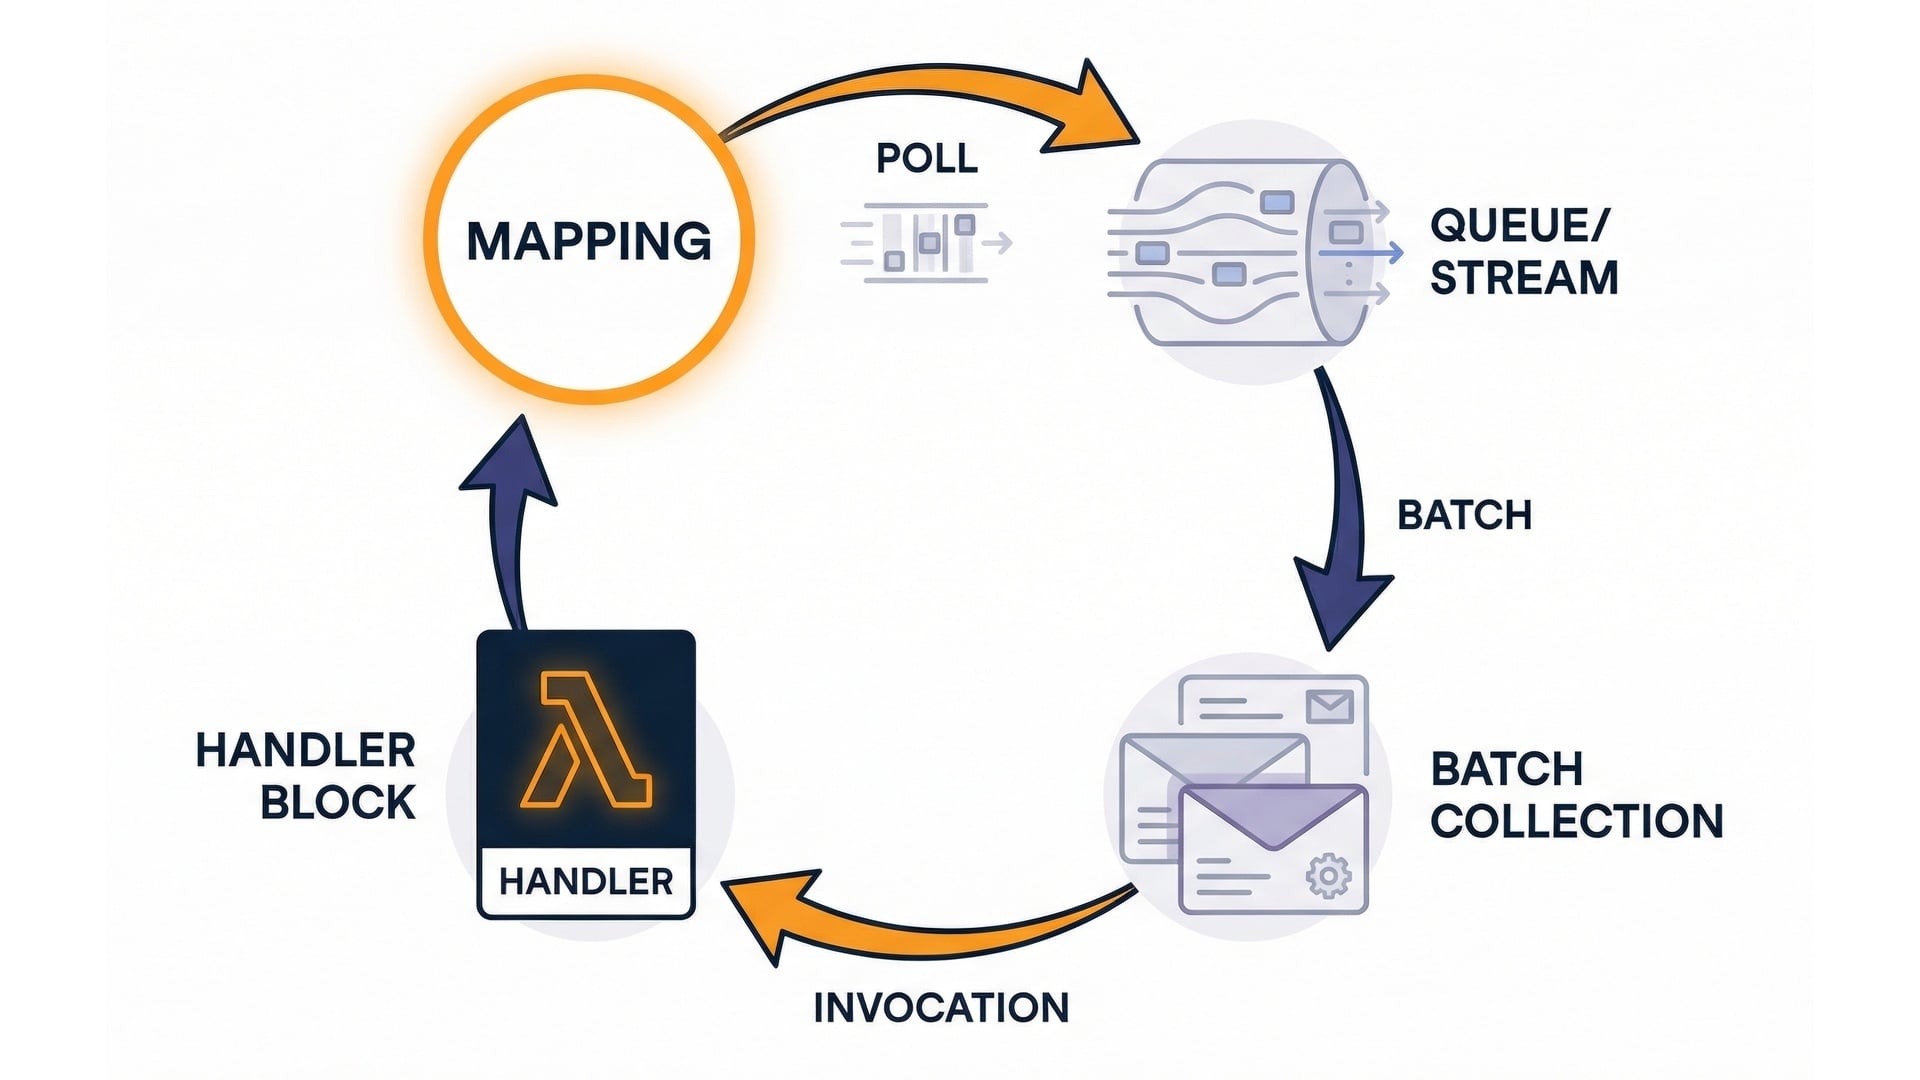
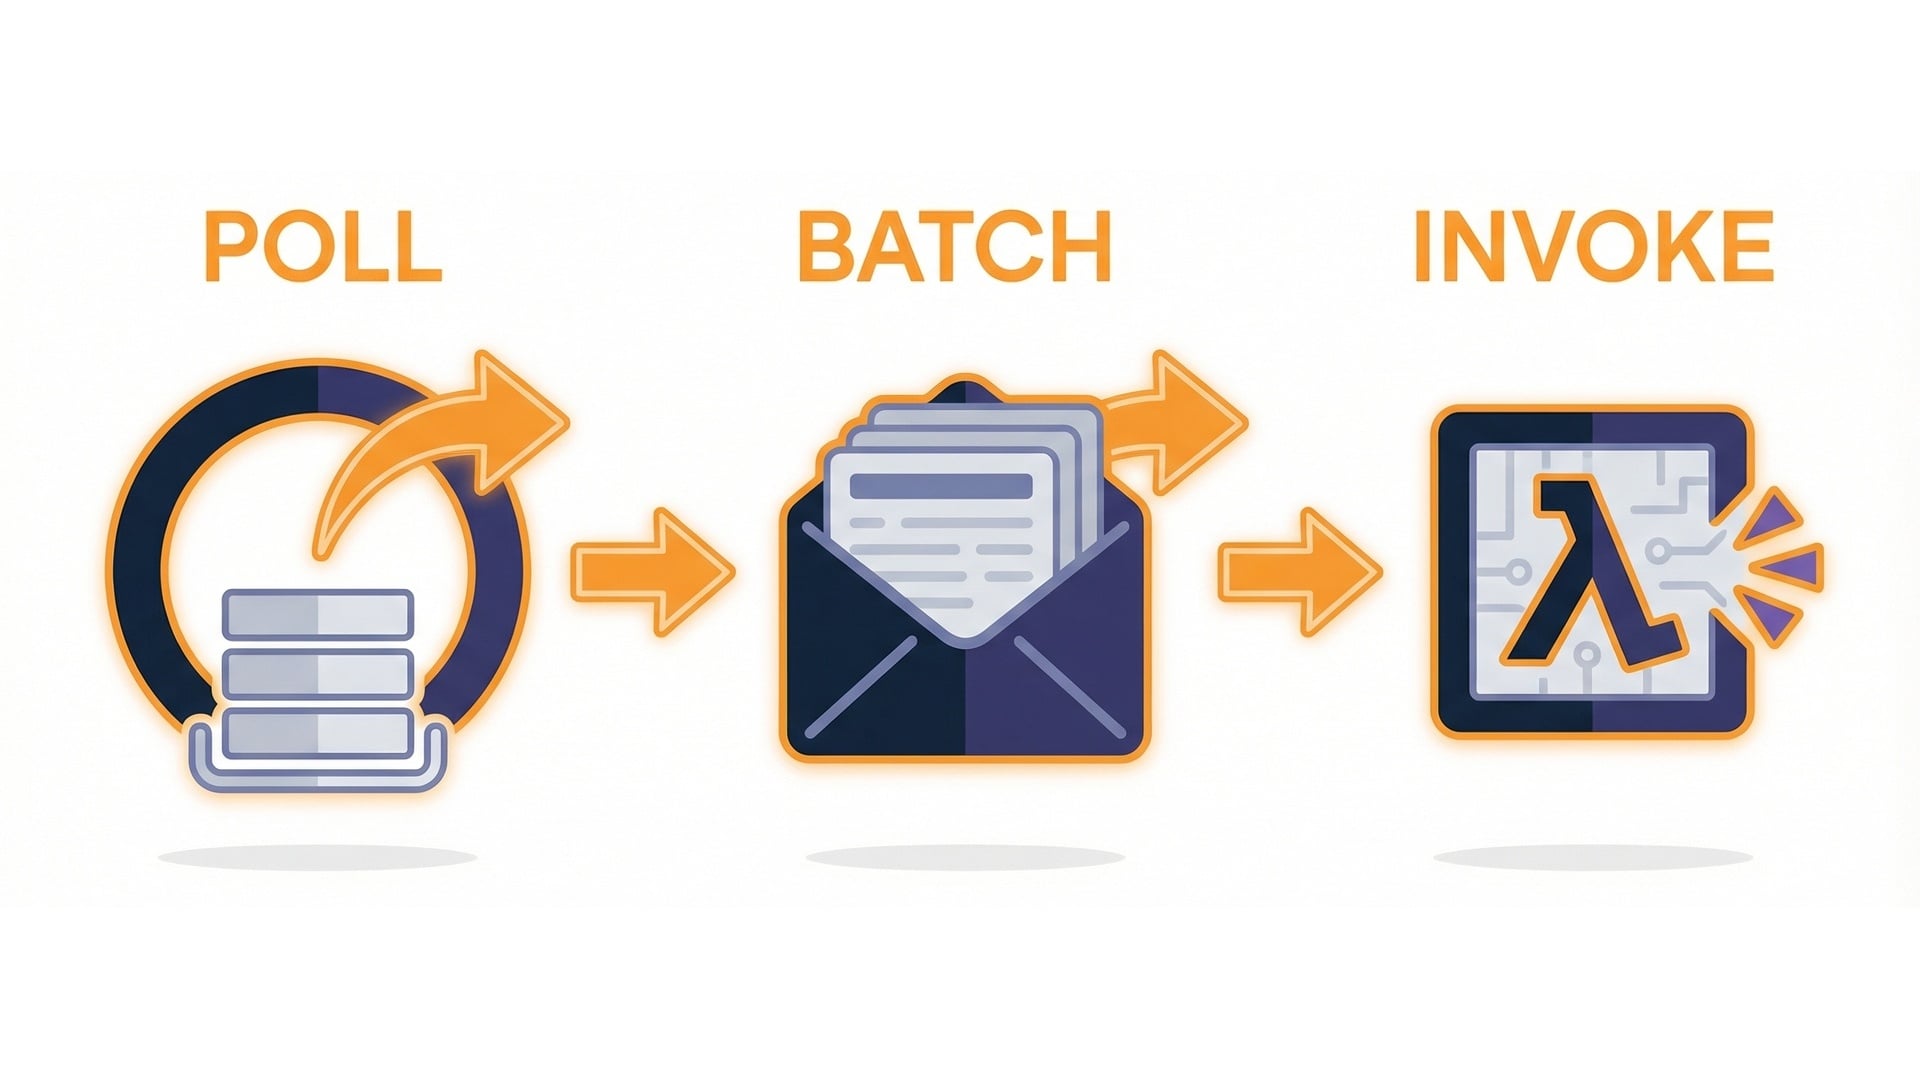
什麼是事件來源對應?

  • 一種將來源連到你的函式的資源。
  • Lambda 會輪詢來源以取得記錄。
  • Lambda 以批次呼叫你的處理器。

事件來源對應流程

使用 AWS Lambda 的無伺服器應用程式

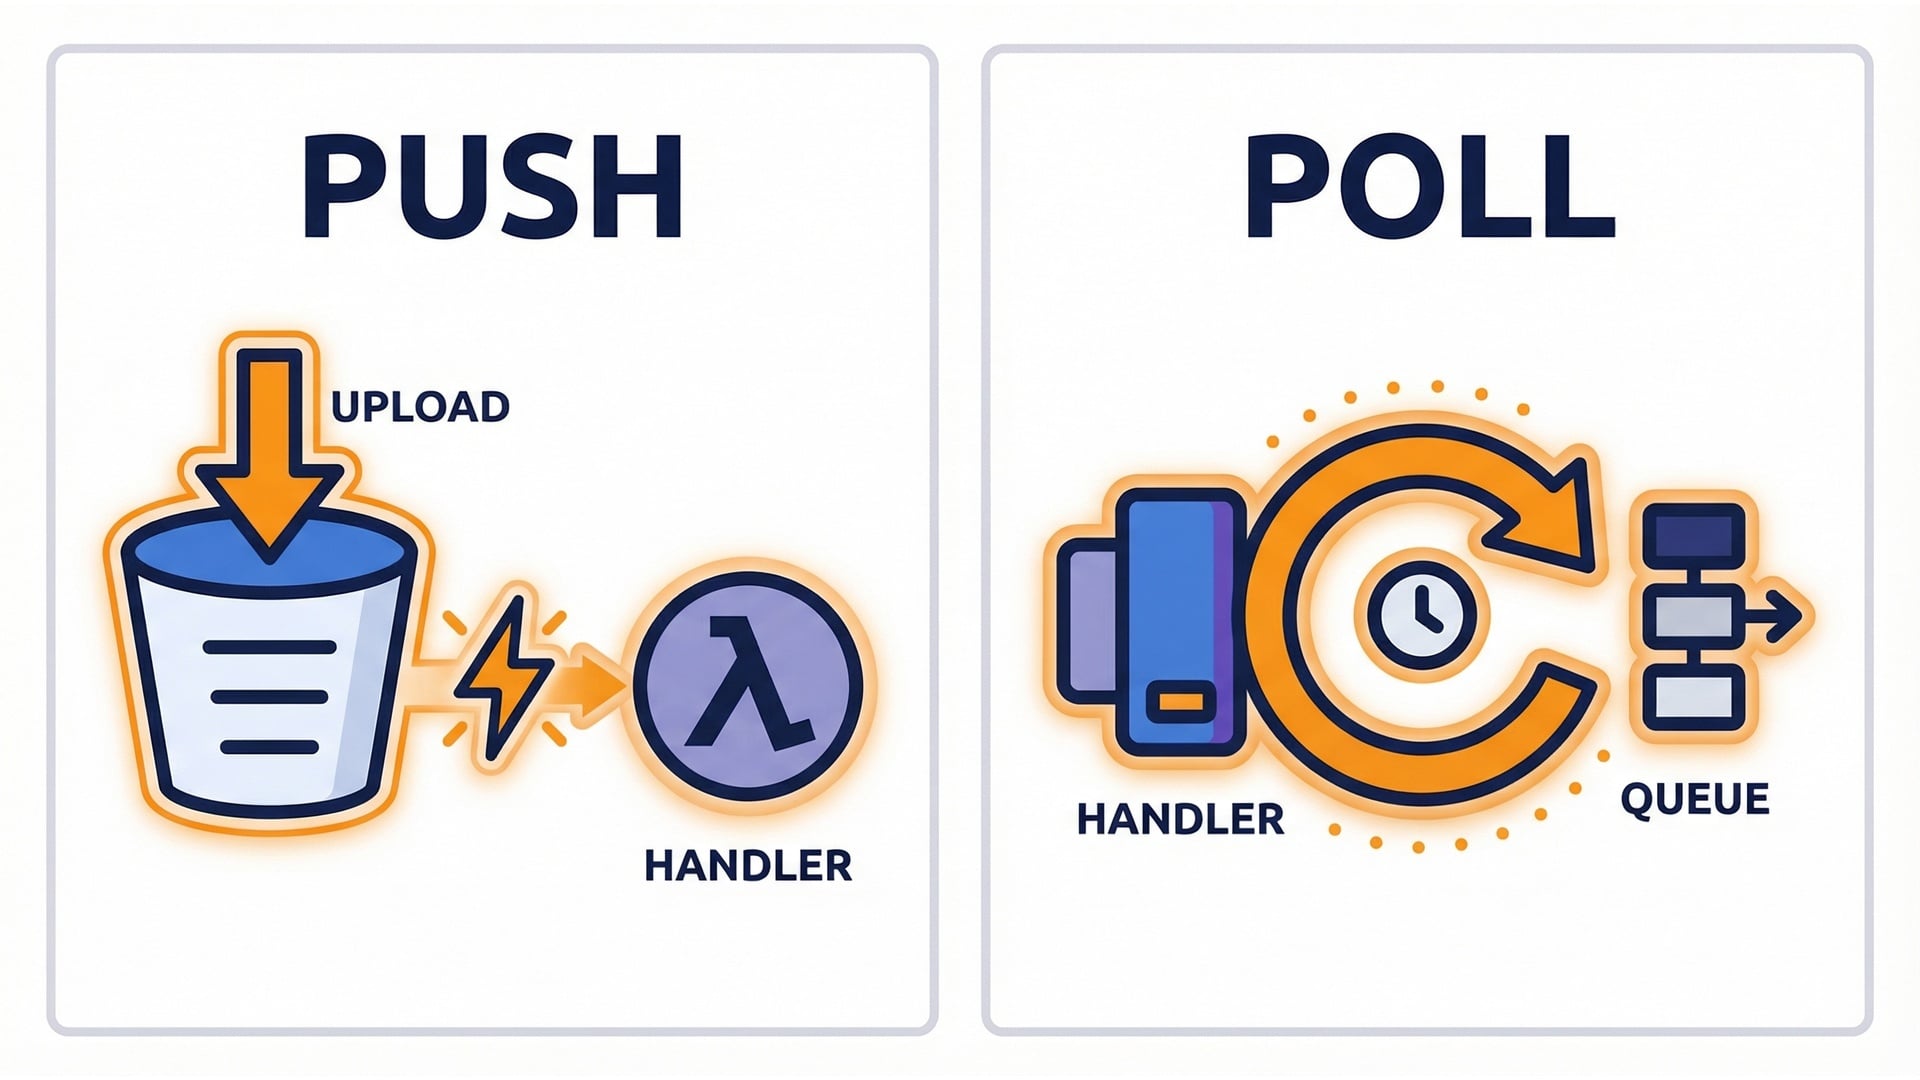
推送 vs 輪詢(為何重要)

推送模型

  • 推送來源會立即送出事件。
  • 例如:上傳到 Amazon S3。

輪詢模型

  • 輪詢來源由 Lambda 檢查。
  • Lambda 組成批次並呼叫你的處理器。
  • 這會影響延遲與重試行為。

推送 vs 輪詢模型

使用 AWS Lambda 的無伺服器應用程式

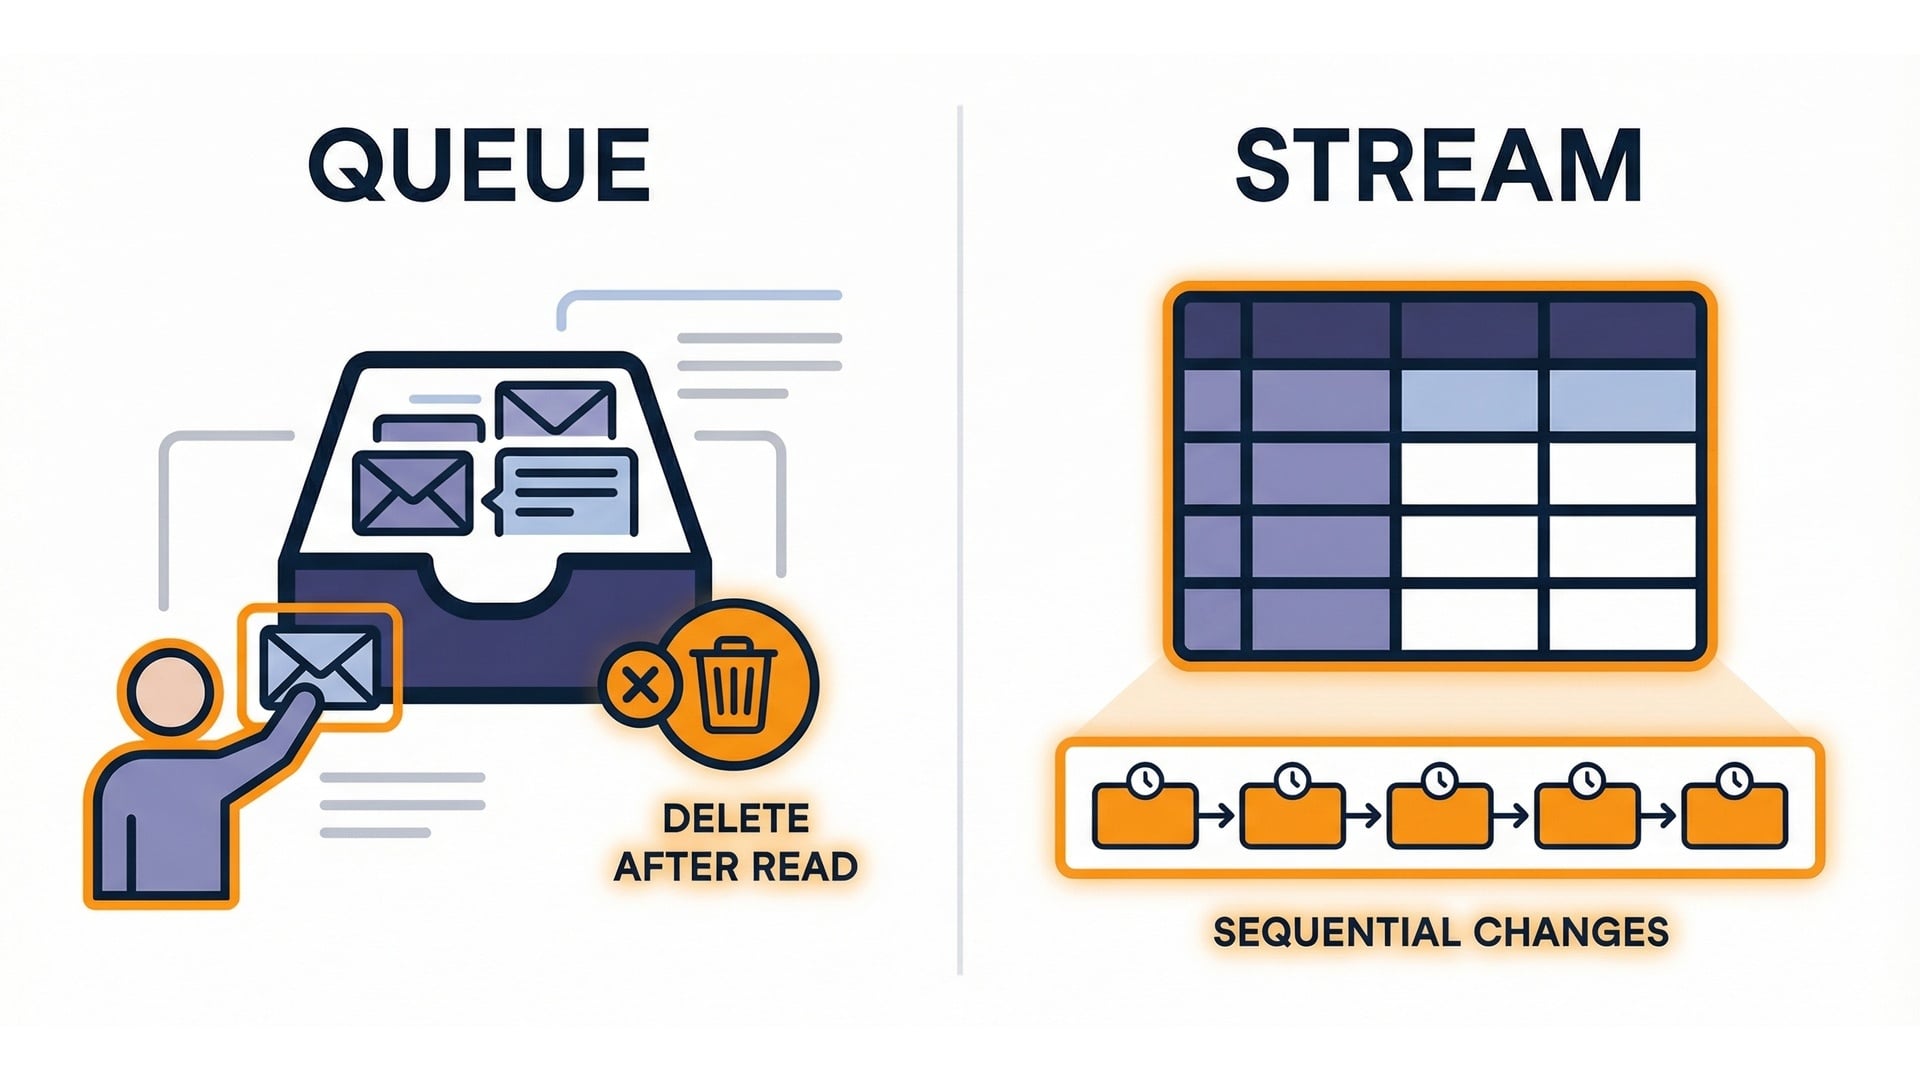
佇列 vs 串流

佇列(Amazon SQS)

  • 受管的訊息佇列,類似收件匣。

串流(DynamoDB Streams)

  • DynamoDB 資料表的變更日誌。
  • 都以 Records 送達,但意義不同。

佇列 vs 串流比較

使用 AWS Lambda 的無伺服器應用程式

批次事件結構(簡化)

{
  "Records": [{
    "messageId": "abc-123",
    "body": "{\"order_id\": \"A-42\"}"
  }]
}
  • 多數對應事件以 Records 開頭。
  • 每筆記錄含有 messageIdbody 字串。
  • body 解析成你自己的酬載。
使用 AWS Lambda 的無伺服器應用程式

示範:處理每筆記錄

def lambda_handler(event, context):
    records = event.get("Records", [])
    for record in records:
        body = record.get("body", "")
        print("BODY:", body)
    return {"statusCode": 200}
  • 以預設清單讀取 Records
  • 逐一迭代並安全讀取 body
  • 紀錄所需資訊,然後回傳。
使用 AWS Lambda 的無伺服器應用程式

示範:解析 JSON 本文

import json

def lambda_handler(event, context):
    record = event.get("Records", [])[0]
    payload = json.loads(record.get("body", "{}"))
    order_id = payload.get("order_id")
    print("ORDER_ID:", order_id)
    return {"statusCode": 200}
  • 匯入 json,以安全預設讀取 body
  • json.loads 解析成 dict。
  • 擷取所需欄位;先驗證再使用。
使用 AWS Lambda 的無伺服器應用程式

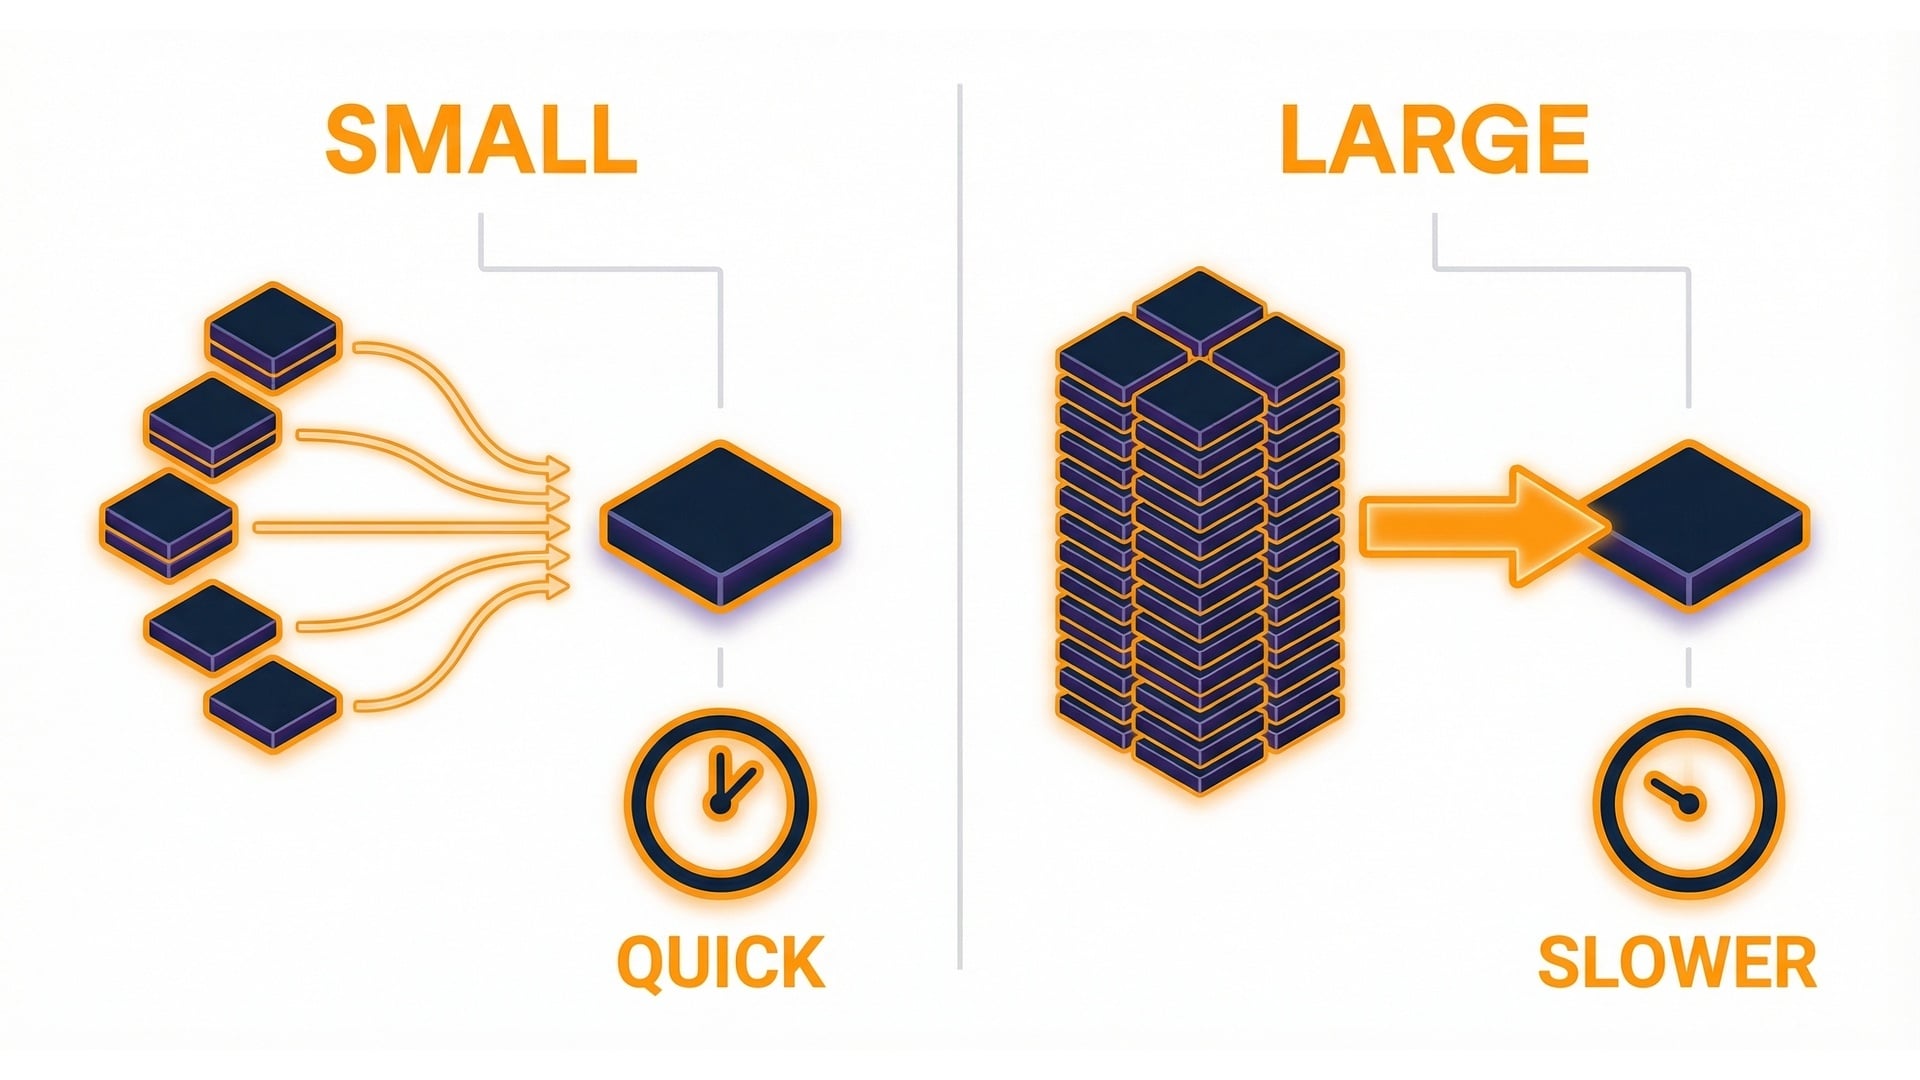
批次化:批次大小與視窗

  • 批次大小:每次呼叫包含多少記錄。
  • 批次視窗:Lambda 等待填滿批次的時間。
  • 批次越大,吞吐越高,但每次執行負擔也增加。
  • 對 SQS,監看 ApproximateAgeOfOldestMessage 以評估壅塞。

批次大小取捨示意圖

使用 AWS Lambda 的無伺服器應用程式

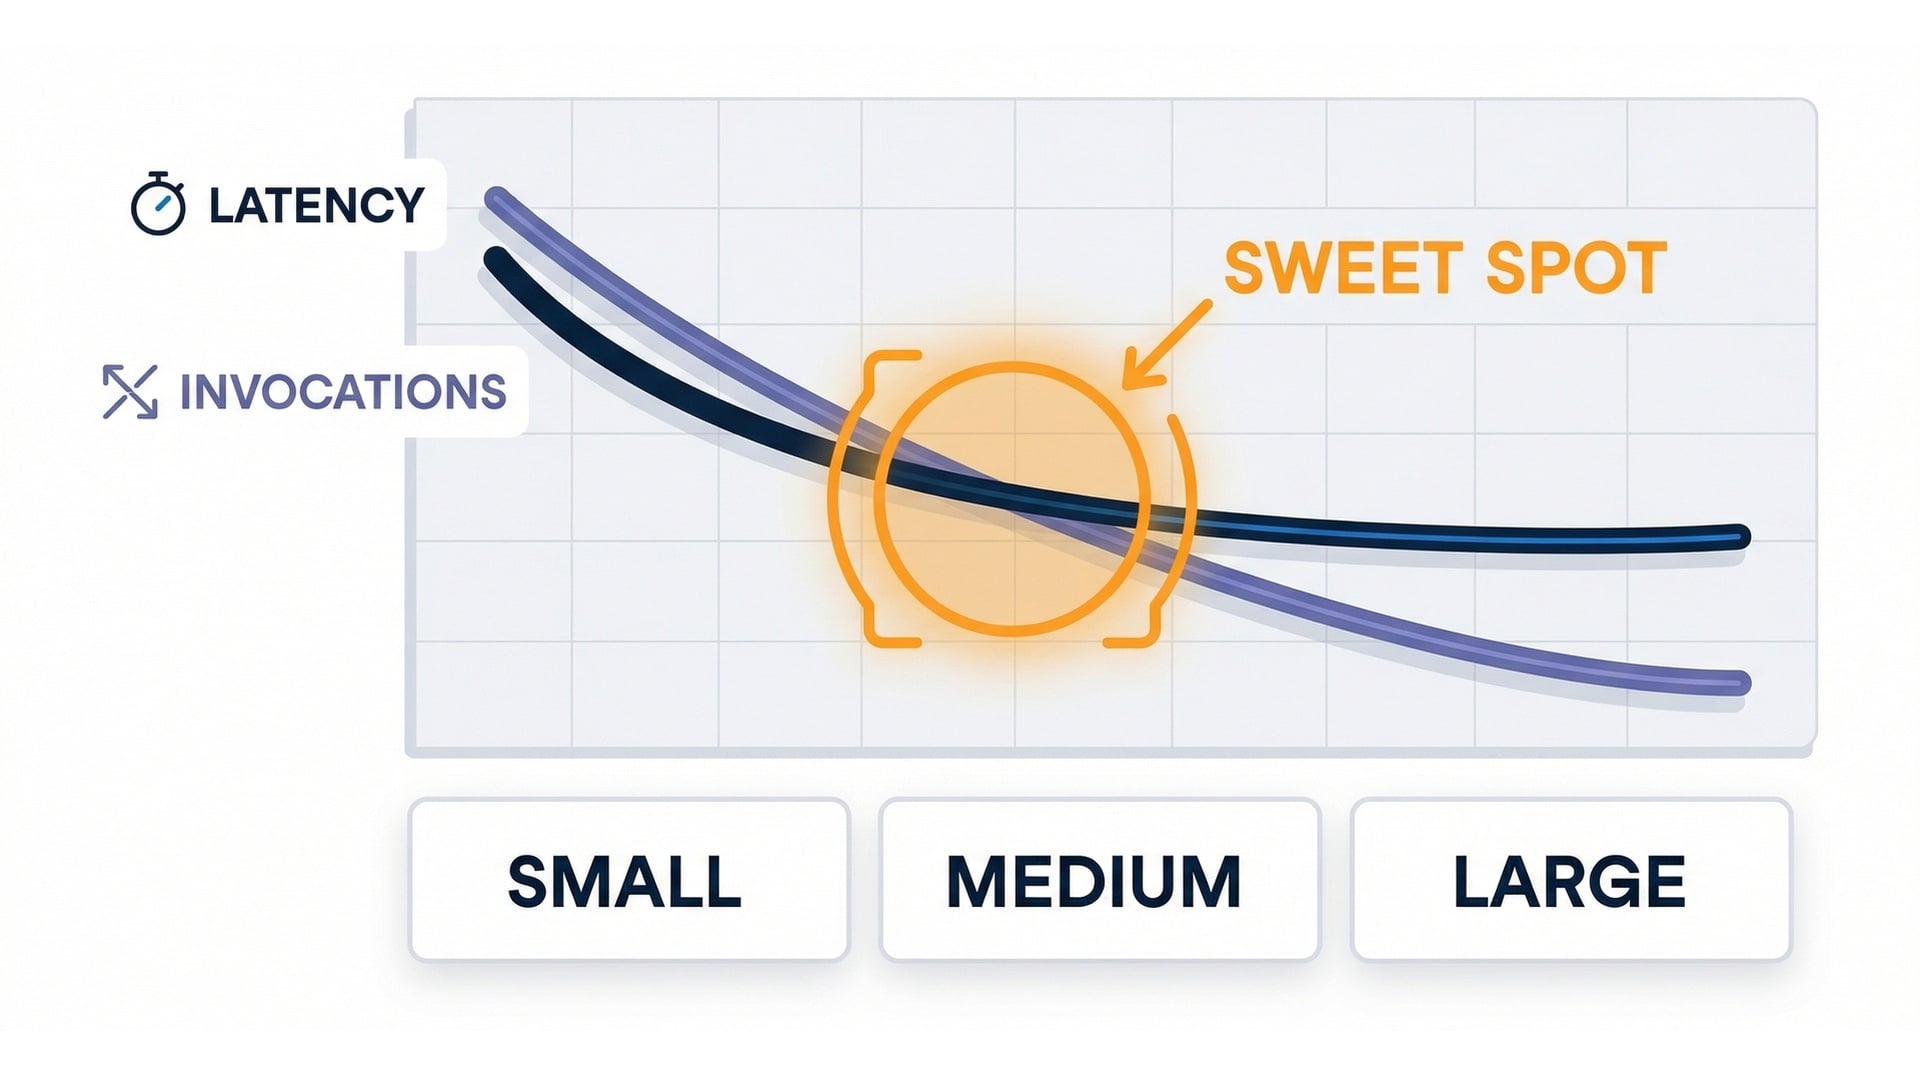
批次大小的取捨

  • 大批次效率高,但可能增加延遲。
  • 小批次縮短首次處理時間,但呼叫次數增加。
  • 依工作負載選擇。

批次大小 vs 延遲圖

使用 AWS Lambda 的無伺服器應用程式

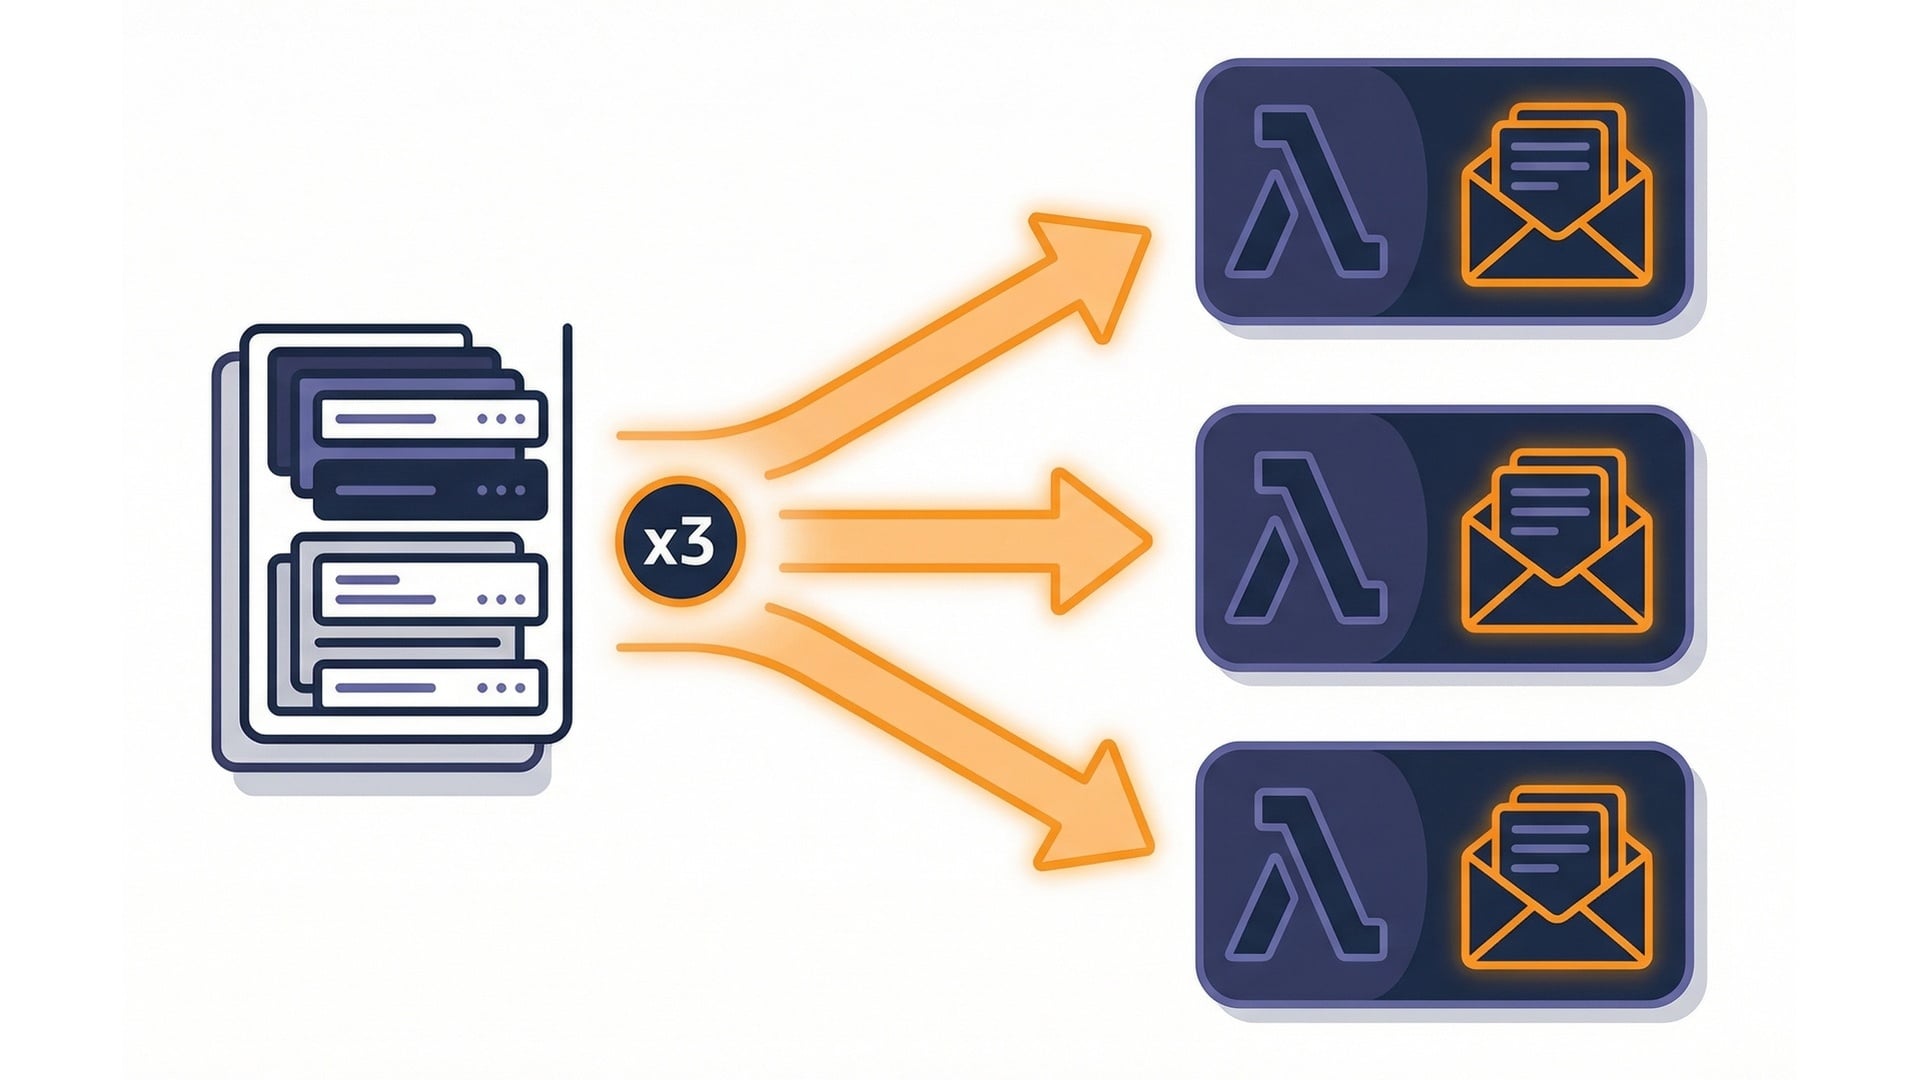
以並行度擴展

  • 多個批次可同時處理。
  • 較高的並行度提升吞吐。
  • 但也會增加下游負載。

並行批次處理

使用 AWS Lambda 的無伺服器應用程式

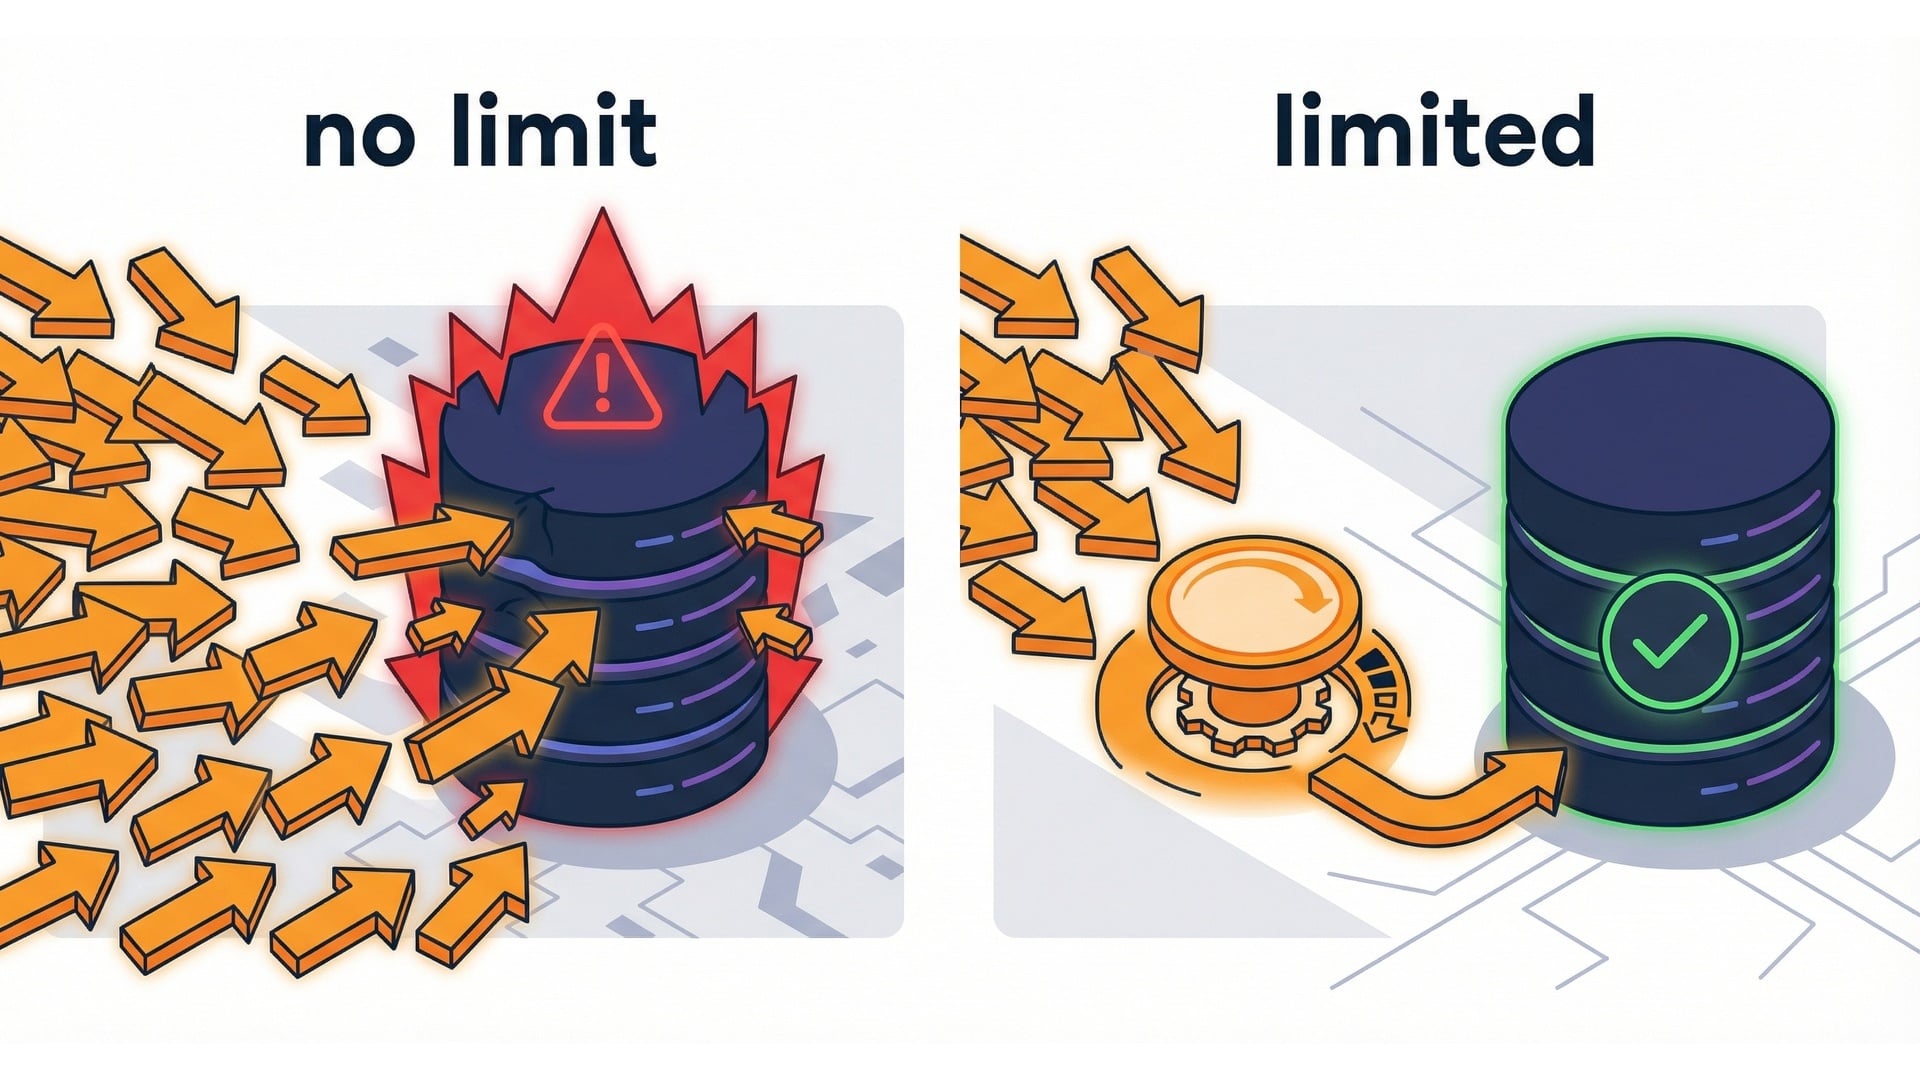
保護下游系統

  • 過多並行可能壓垮資料庫或 API。
  • 用限制來控管負載。
  • 偏好小而安全的工作單位。

下游負載保護

使用 AWS Lambda 的無伺服器應用程式

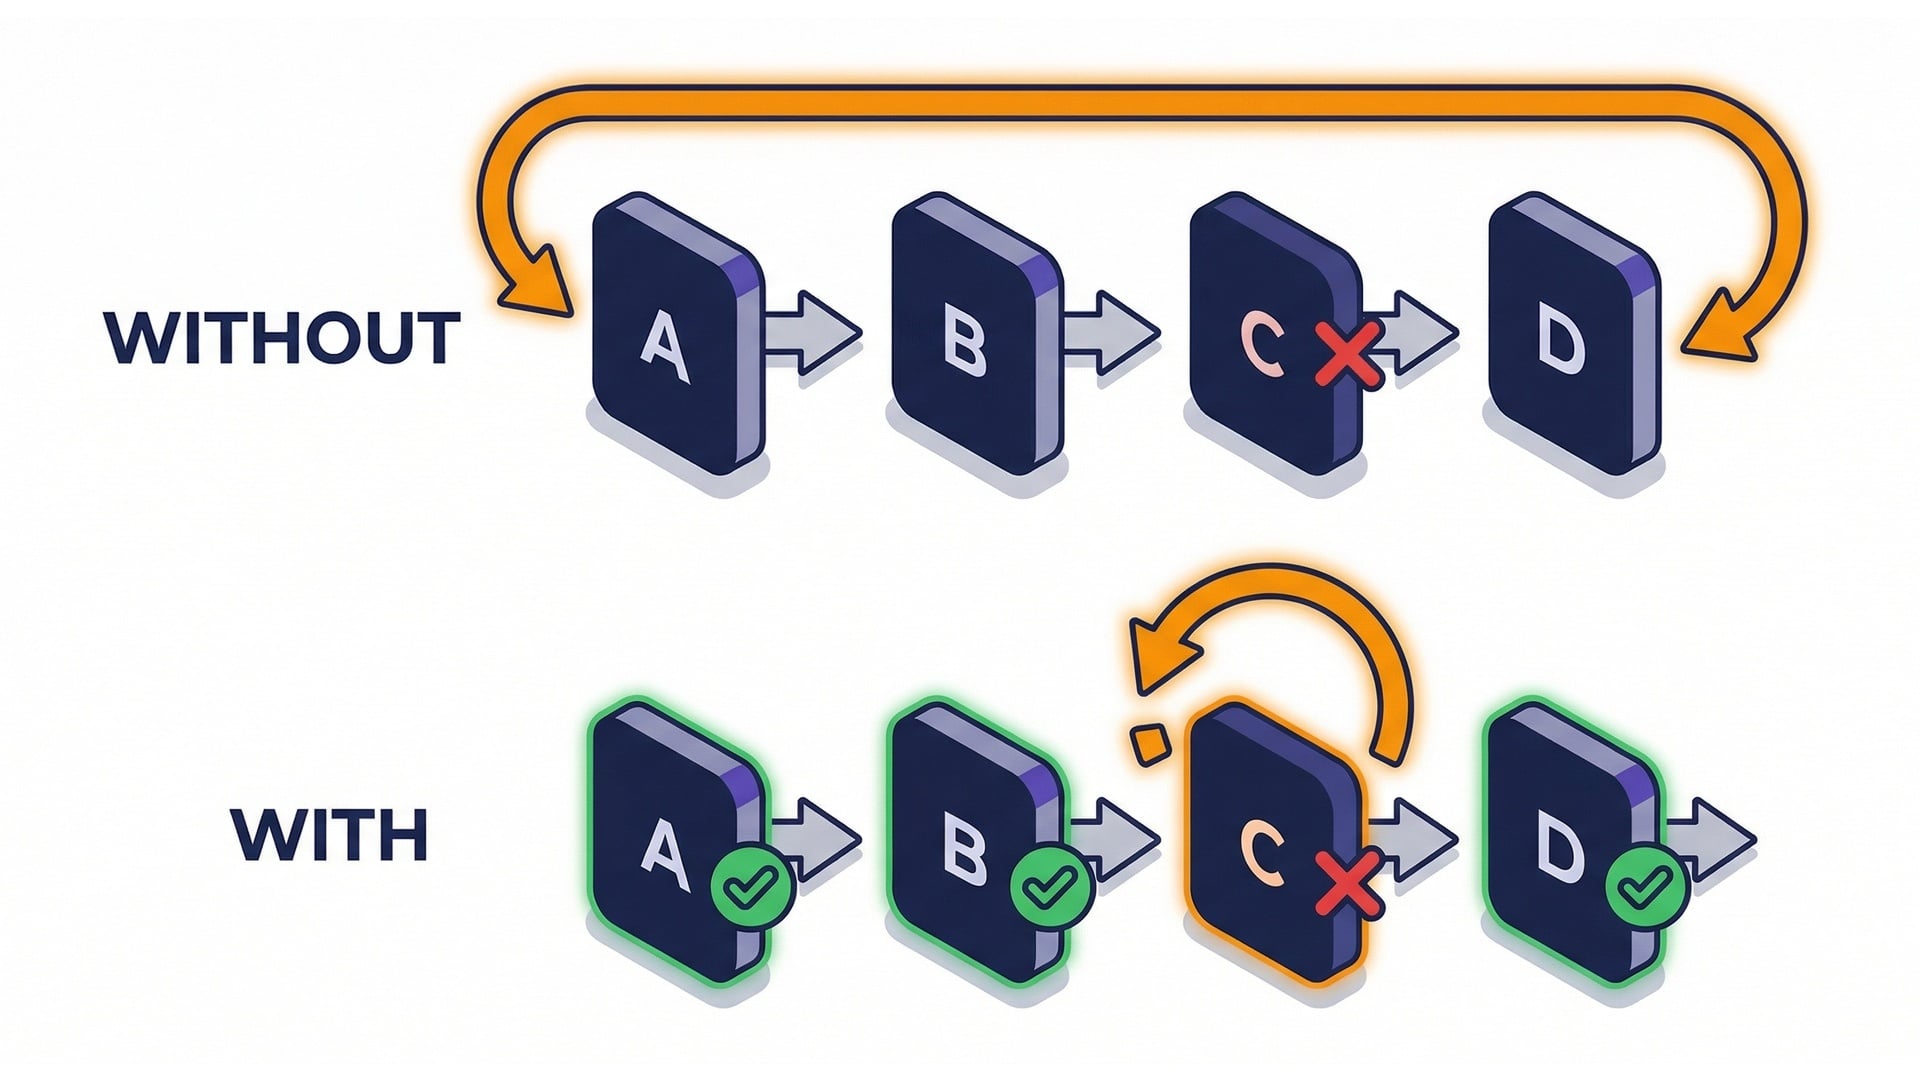
部分批次失敗

  • 一個批次可能同時含有良好與錯誤的記錄。
  • 若不支援部分失敗,一筆壞記錄會重試整個批次。
  • 部分失敗處理可只重試失敗項目。

部分批次失敗流程

使用 AWS Lambda 的無伺服器應用程式

示範:回報部分失敗(SQS)

def lambda_handler(event, context):
    failures = []
    for record in event.get("Records", []):
        try:
            process(record)
        except Exception:
            failures.append({"itemIdentifier": record["messageId"]})
    return {"batchItemFailures": failures}
  • batchItemFailures 收集失敗記錄的 messageId
  • Lambda 只會重試那些項目。
  • 已成功處理的記錄不會再送。
使用 AWS Lambda 的無伺服器應用程式

重點整理

  • 事件來源對應會輪詢佇列與串流。
  • 它們以批次將 Records 送到你的處理器。
  • 批次大小與視窗在延遲與吞吐間取捨。
  • 部分失敗可避免重處理已成功的項目。

對應重點摘要圖

使用 AWS Lambda 的無伺服器應用程式

一起來練習吧!

使用 AWS Lambda 的無伺服器應用程式

Preparing Video For Download...