用 Python 拿下 Kaggle 競賽
Yauhen Babakhin
Kaggle Grandmaster

特徵洩漏(features)– 使用實務上不會取得的資料
驗證策略洩漏(validation strategy)– 驗證方式與真實情境不符


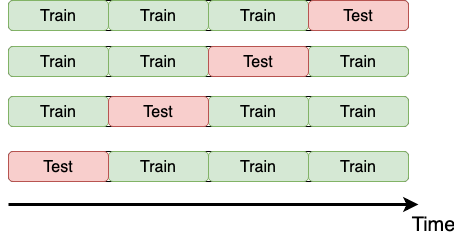
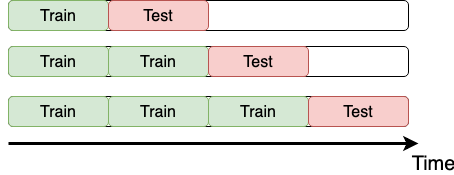
# Import TimeSeriesSplit
from sklearn.model_selection import TimeSeriesSplit
# Create a TimeSeriesSplit object
time_kfold = TimeSeriesSplit(n_splits=5)
# Sort train by date
train = train.sort_values('date')
# Loop through each cross-validation split
for train_index, test_index in time_kfold.split(train):
cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]
# List for the results fold_metrics = []for train_index, test_index in CV_STRATEGY.split(train): cv_train, cv_test = train.iloc[train_index], train.iloc[test_index]# Train a model model.fit(cv_train)# Make predictions predictions = model.predict(cv_test)# Calculate the metric metric = evaluate(cv_test, predictions) fold_metrics.append(metric)
| 摺數 | 模型 A MSE | 模型 B MSE |
|---|---|---|
| Fold 1 | 2.95 | 2.97 |
| Fold 2 | 2.84 | 2.45 |
| Fold 3 | 2.62 | 2.73 |
| Fold 4 | 2.79 | 2.83 |
import numpy as np
# 各摺取簡單平均
mean_score = np.mean(fold_metrics)
# 整體驗證分數
overall_score_minimizing = np.mean(fold_metrics) + np.std(fold_metrics)
# 或
overall_score_maximizing = np.mean(fold_metrics) - np.std(fold_metrics)
| 摺數 | 模型 A MSE | 模型 B MSE |
|---|---|---|
| Fold 1 | 2.95 | 2.97 |
| Fold 2 | 2.84 | 2.45 |
| Fold 3 | 2.62 | 2.73 |
| Fold 4 | 2.79 | 2.83 |
| 平均 | 2.80 | 2.75 |
| 整體 | 2.919 | 2.935 |
用 Python 拿下 Kaggle 競賽