使用隨機化分佈

R 統計推論基礎

Jo Hardin

Instructor

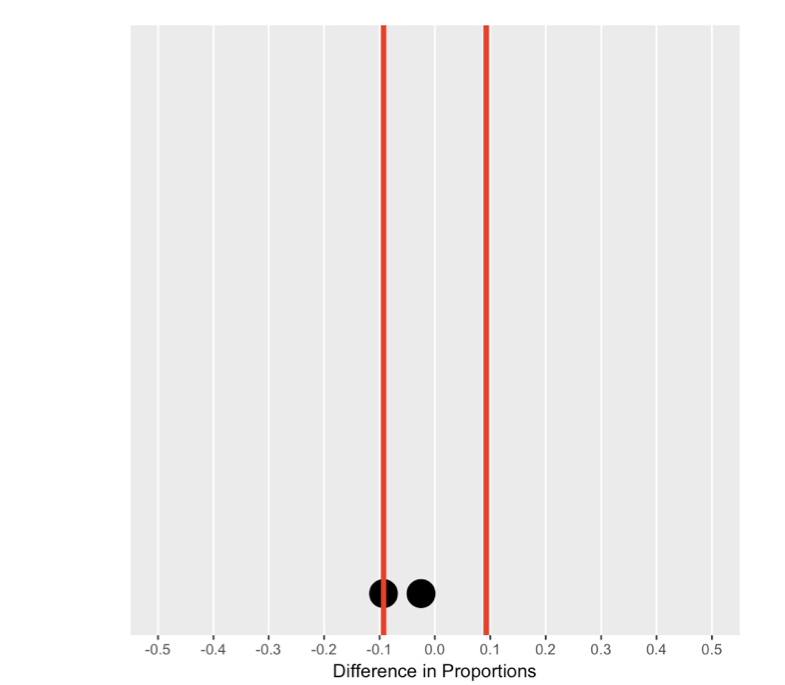
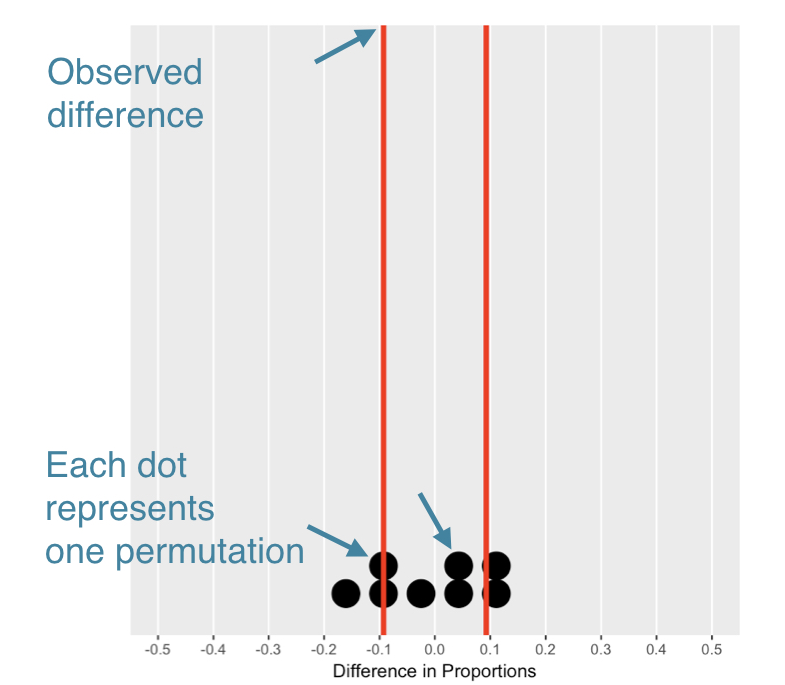
理解虛無分佈

第 1 章第 3 張圖:推論.003

R 統計推論基礎

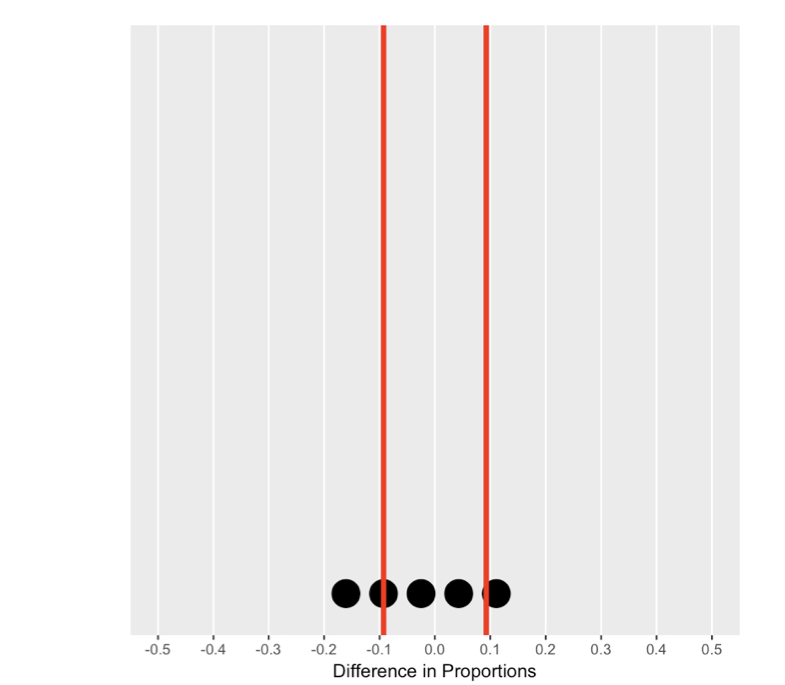
理解虛無分佈

第 1 章第 3 張圖:推論.004

R 統計推論基礎

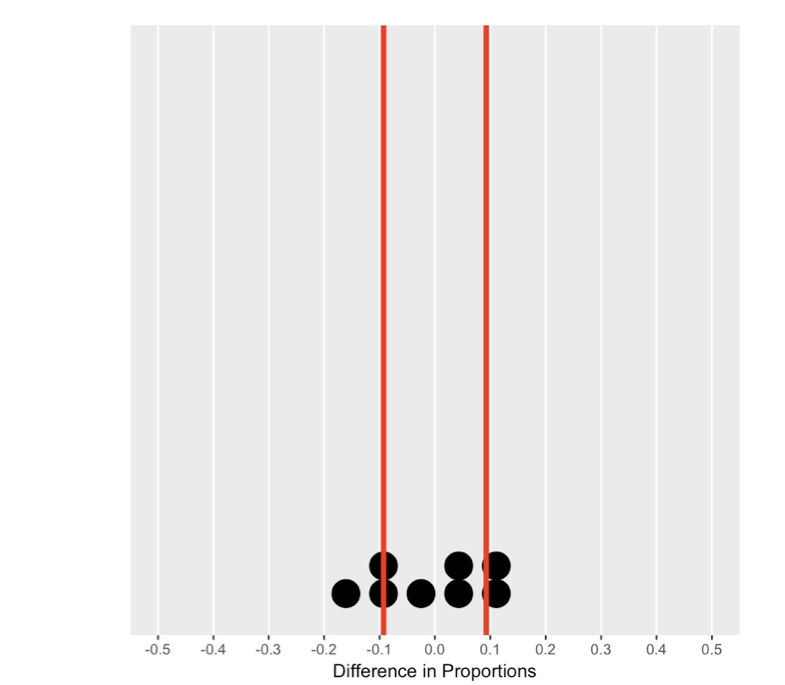
理解虛無分佈

第 1 章第 3 張圖:推論.005

R 統計推論基礎

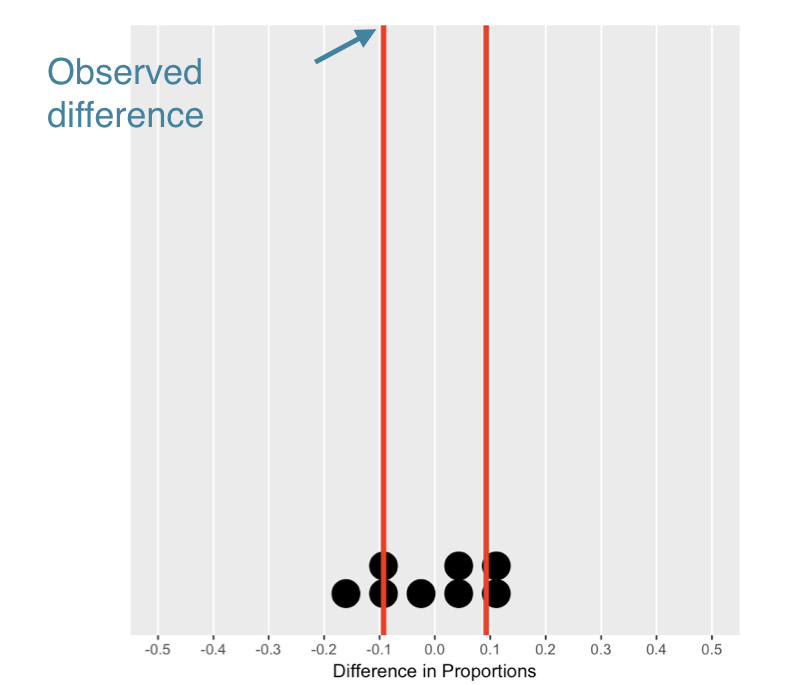
理解虛無分佈

第 1 章第 3 張圖:推論.006

R 統計推論基礎

理解虛無分佈

第 1 章第 3 張圖:推論.007

R 統計推論基礎

資料與虛無相符嗎?

table(soda)
         location
drink    East West
cola     28   19
orange   6    7
soda %>% group_by(location) %>% 
    summarize(mean(drink == "cola"))
# A tibble: 2 × 2
  location `mean(drink == "cola")`
    <fctr>                   <dbl>
1     East               0.8235294
2     West               0.7307692
R 統計推論基礎

顯著性

第 1 章第 3 張圖:推論.011

R 統計推論基礎

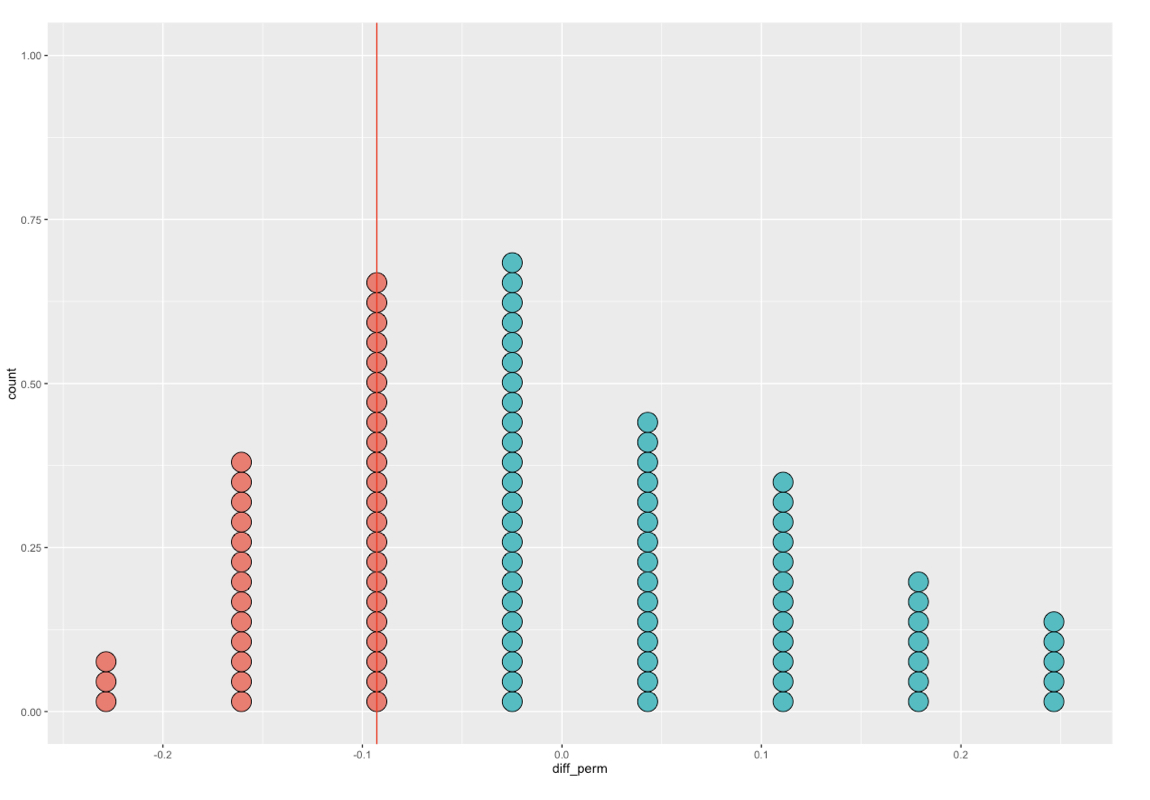
觀察到的資料有多極端?

diff_orig <- soda %>%
  group_by(location) %>%
  summarize(prop_cola = mean(drink == "cola")) %>%
  summarize(diff(prop_cola)) %>%
  pull()

 soda_perm <- soda %>%
  specify(drink ~ location, success = "cola") %>%
  hypothesize(null = "independence") %>%
  generate(reps = 100, type = "permute") %>%
  calculate(stat = "diff in props", 
              order = c("west", "east"))

soda_perm %>% 
    summarize(proportion = mean(diff_orig >= stat))
 # A tibble: 1 x 1
  proportion
       <dbl>
1      0.380
R 統計推論基礎

一起來練習吧!

R 統計推論基礎

Preparing Video For Download...