變數的置中與縮放

Python 的客群分群

Karolis Urbonas

Head of Data Science, Amazon

找出問題

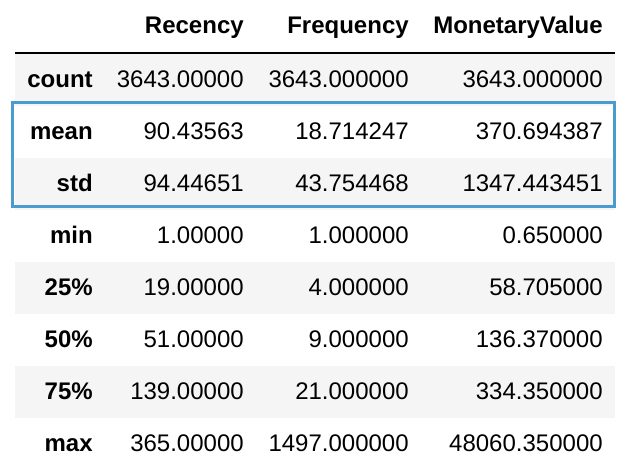
  • 分析資料集 {{1}} 的關鍵統計量
  • 比較平均數與標準差
datamart_rfm.describe()

Python 的客群分群

置中不同平均數的變數

  • K-means 適用於平均數相同的變數
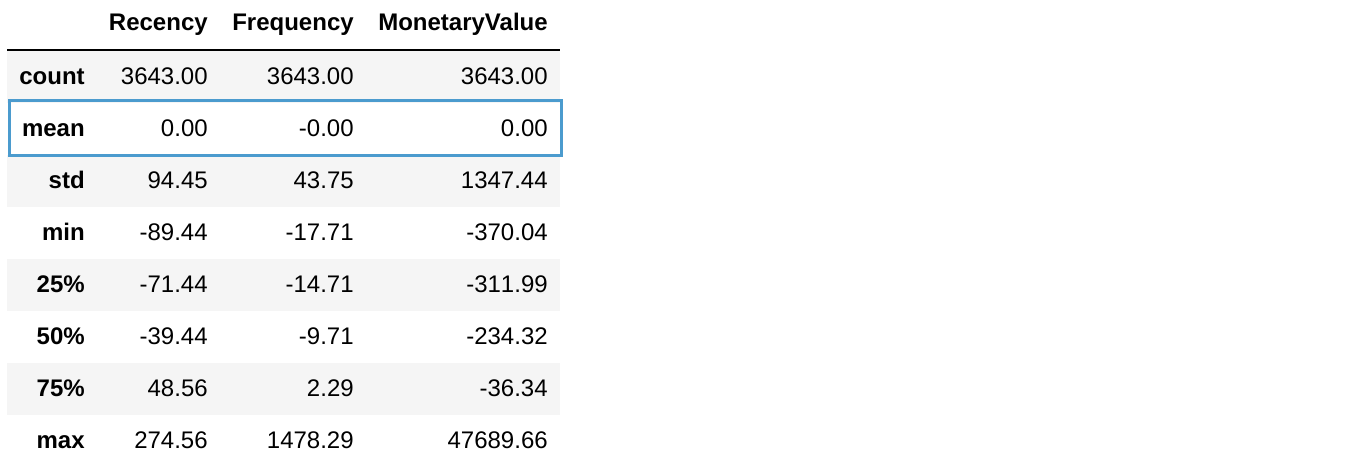
  • 置中作法:每個觀測值減去其平均數
datamart_centered = datamart_rfm - datamart_rfm.mean()
datamart_centered.describe().round(2)
Python 的客群分群

縮放不同變異數的變數

  • K-means 更適用於變異數/標準差相同的變數
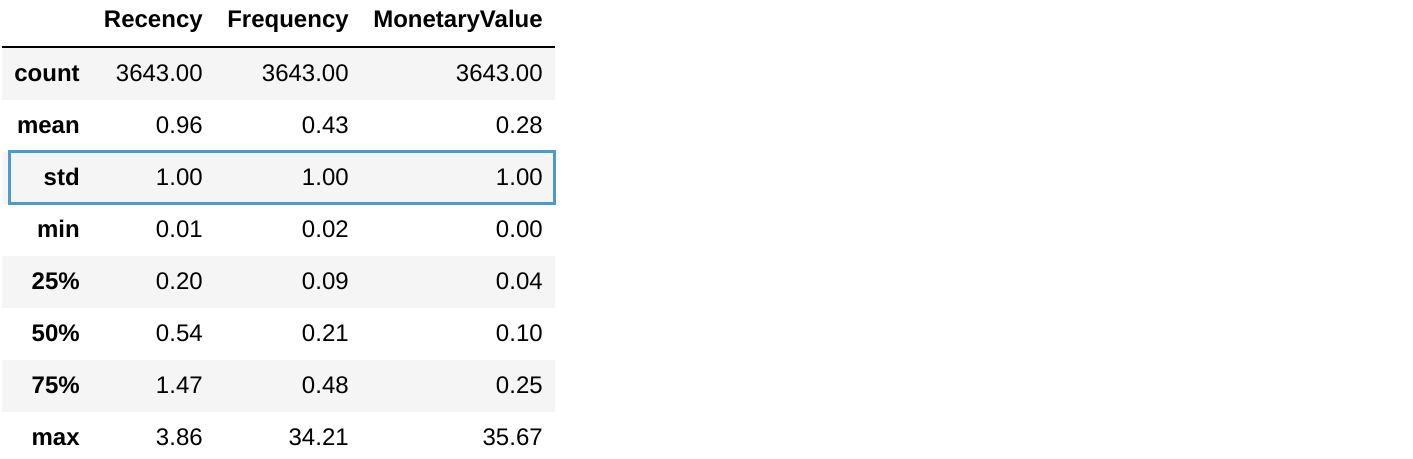
  • 縮放作法:各變數除以其標準差
datamart_scaled = datamart_rfm / datamart_rfm.std()
datamart_scaled.describe().round(2)
Python 的客群分群

結合置中與縮放

  • 手動先減去平均數,再除以標準差
  • 或使用 scikit-learn 的 scaler(回傳 numpy.ndarray 物件)
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(datamart_rfm)
datamart_normalized = scaler.transform(datamart_rfm)

print('mean: ', datamart_normalized.mean(axis=0).round(2)) print('std: ', datamart_normalized.std(axis=0).round(2))
mean:  [-0. -0.  0.]
std:  [1. 1. 1.]
Python 的客群分群

自己動手測試不同方法!

Python 的客群分群

Preparing Video For Download...