k-means 分群的實作

Python 的客群分群

Karolis Urbonas

Head of Data Science, Amazon

關鍵步驟

  • 資料前處理
  • 選擇叢集數
  • 對前處理資料執行 k-means
  • 分析各叢集的平均 RFM 值
Python 的客群分群

資料前處理

我們已完成前處理,並得到兩個物件:

  • datamart_rfm
  • datamart_normalized
import numpy as np
datamart_log = np.log(datamart_rfm)

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(datamart_log)

datamart_normalized = scaler.transform(datamart_log)
Python 的客群分群

決定叢集數的方法

  • 視覺法:elbow 準則
  • 數學法:silhouette 係數
  • 實驗與詮釋
Python 的客群分群

執行 k-means

# Import package
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=2, random_state=1)
# Compute k-means clustering on pre-processed data
kmeans.fit(datamart_normalized)
# Extract cluster labels from labels_ attribute
cluster_labels = kmeans.labels_
Python 的客群分群

分析各叢集的平均 RFM 值

# Create a cluster label column in the original DataFrame
datamart_rfm_k2 = datamart_rfm.assign(Cluster = cluster_labels)
# Calculate average RFM values and size for each cluster
datamart_rfm_k2.groupby(['Cluster']).agg({
    'Recency': 'mean',
    'Frequency': 'mean',
    'MonetaryValue': ['mean', 'count'],
}).round(0)
Python 的客群分群

分析各叢集的平均 RFM 值

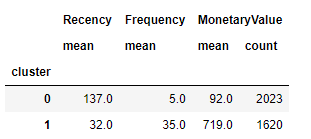
簡單 2 叢集解的結果:

Python 的客群分群

一起來練習吧!

Python 的客群分群

Preparing Video For Download...