Python 的行銷機器學習
Karolis Urbonas
Head of Analytics & Science, Amazon
使用 K-means 分群(k 為叢集數):
k
from sklearn.cluster import KMeans

kmeans=KMeans(n_clusters=k)

kmeans.fit(wholesale_scaled_df)

wholesale_kmeans4 = wholesale.assign(segment = kmeans.labels_)
from sklearn.cluster import KMeans
kmeans=KMeans(n_clusters=k)
kmeans.fit(wholesale_scaled_df)
wholesale_kmeans4 = wholesale.assign(segment = kmeans.labels_)
使用 NMF 分群(k 為叢集數):
from sklearn.decomposition import NMF
nmf = NMF(k)
nmf.fit(wholesale)
components = pd.DataFrame(nmf.components_, columns=wholesale.columns)
取得分群指派:
segment_weights = pd.DataFrame(nmf.transform(wholesale, columns=components.index)
segment_weights.index = wholesale.index
wholesale_nmf = wholesale.assign(segment = segment_weights.idxmax(axis=1))
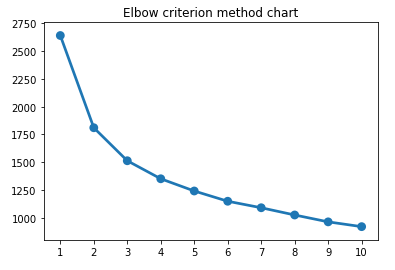
SSE
sse = {}
for k in range(1, 11):
    kmeans=KMeans(n_clusters=k, random_state=333)
    kmeans.fit(wholesale_scaled_df)
    sse[k] = kmeans.inertia_
plt.title('Elbow criterion method chart')
sns.pointplot(x=list(sse.keys()), y=list(sse.values()))
plt.show()