分群的資料前處理

Python 的行銷機器學習

Karolis Urbonas

Head of Analytics & Science, Amazon

模型假設

  • 先從 K-means 開始
  • 當資料 1)近似常態(無偏態),2)已標準化(mean = 0、standard deviation = 1)時,K-means 表現良好
  • 第二個模型 NMF 可用於原始資料,特別是稀疏矩陣
Python 的行銷機器學習

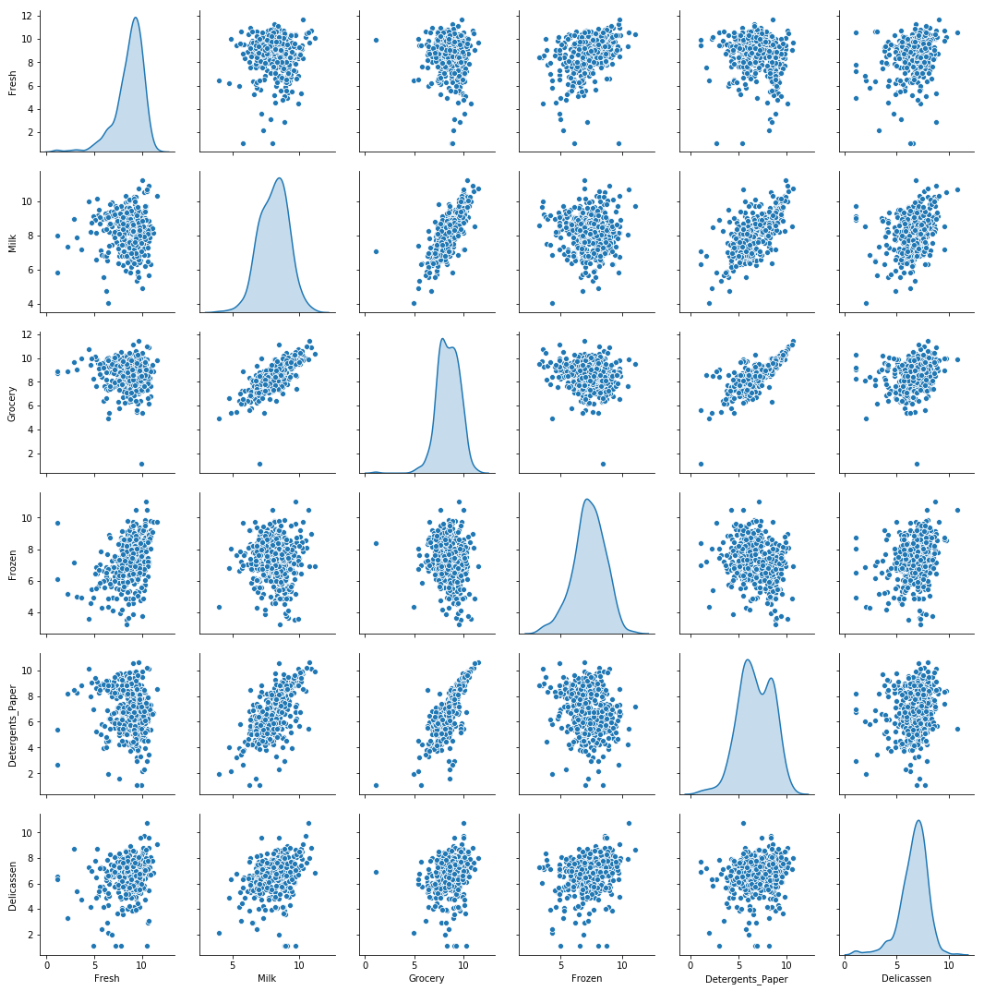
用對數轉換校正偏態

# First option - log transformation
wholesale_log = np.log(wholesale)
sns.pairplot(wholesale_log, diag_kind='kde')
plt.show()
Python 的行銷機器學習

探索對數轉換後的資料

對數轉換的配對圖

Python 的行銷機器學習

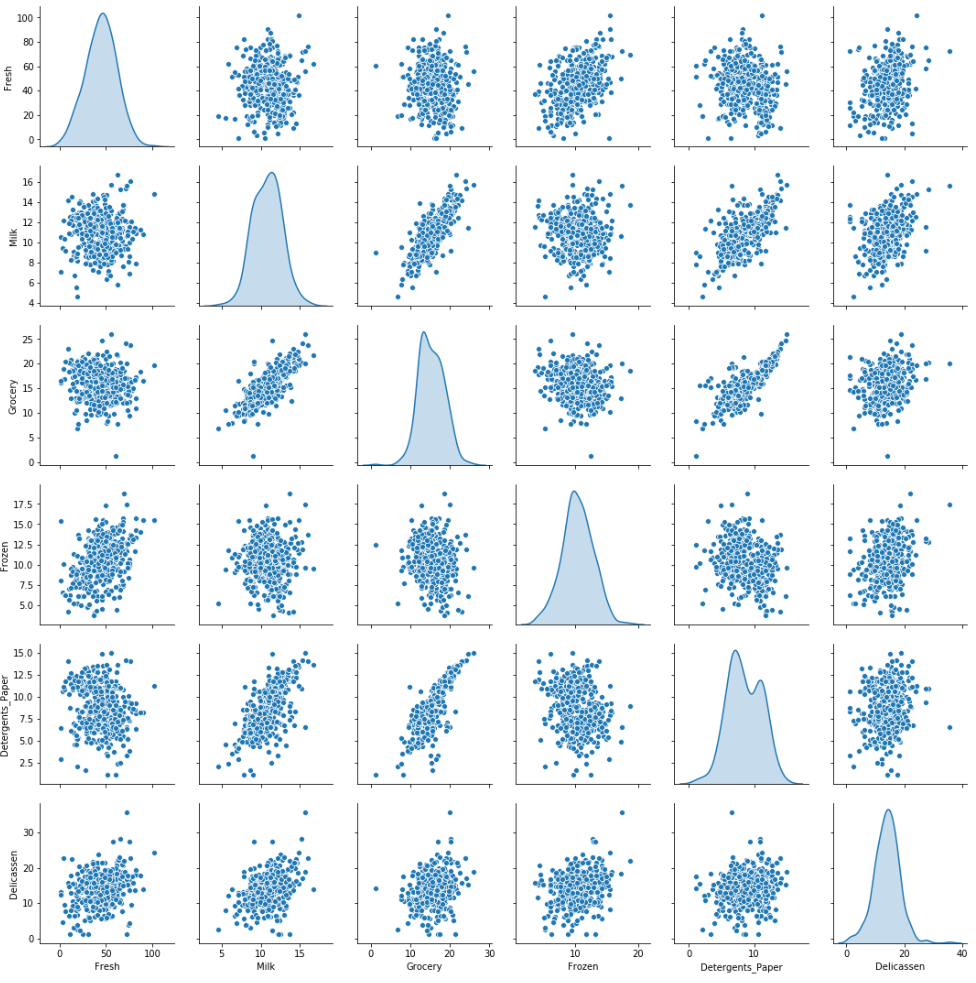
用 Box-Cox 轉換校正偏態

# Second option - Box-Cox transformation
from scipy import stats

def boxcox_df(x):
    x_boxcox, _ = stats.boxcox(x)
    return x_boxcox

wholesale_boxcox = wholesale.apply(boxcox_df, axis=0)
sns.pairplot(wholesale_boxcox, diag_kind='kde')
plt.show()
Python 的行銷機器學習

探索 Box-Cox 轉換後的資料

Box-Cox 配對圖

Python 的行銷機器學習

縮放資料

  • 以各欄平均數為基準,逐欄減去平均
  • 再以各欄標準差做縮放,逐欄相除
  • 將使用 sklearnStandardScaler() 模組
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()

scaler.fit(wholesale_boxcox) wholesale_scaled = scaler.transform(wholesale_boxcox) wholesale_scaled_df = pd.DataFrame(data=wholesale_scaled, index=wholesale_boxcox.index, columns=wholesale_boxcox.columns) wholesale_scaled_df.agg(['mean','std']).round()
      Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicassen
mean   -0.0   0.0      0.0     0.0              -0.0         0.0
std     1.0   1.0      1.0     1.0               1.0         1.0
Python 的行銷機器學習

一起來練習吧!

Python 的行銷機器學習

Preparing Video For Download...