應用程式健全狀態儀表板

AWS 監控與疑難排解

John Q. Martin

Principal Consultant

儀表板設計:資訊層級
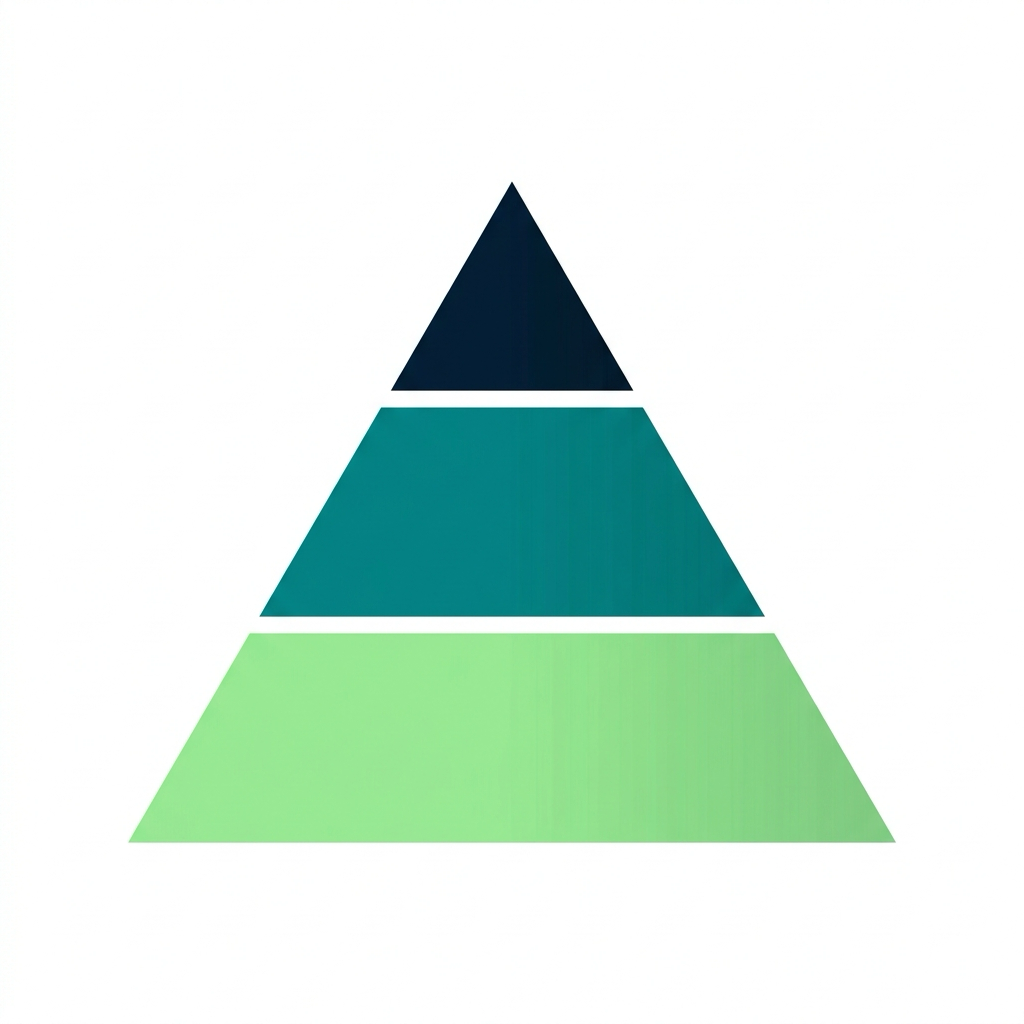
 

三層金字塔:上層深色窄、中層藍綠較寬、底層綠色最寬

就像醫院:掛號 → 病房 → 專科醫師


頂層-管理摘要

  • 系統整體健康
  • 重要商業指標、SLA、目前事件

中層-服務健康

  • 錯誤率、延遲分位數、吞吐量

底層-詳細診斷

  • 追蹤、日誌、資源使用、相依健康
AWS 監控與疑難排解

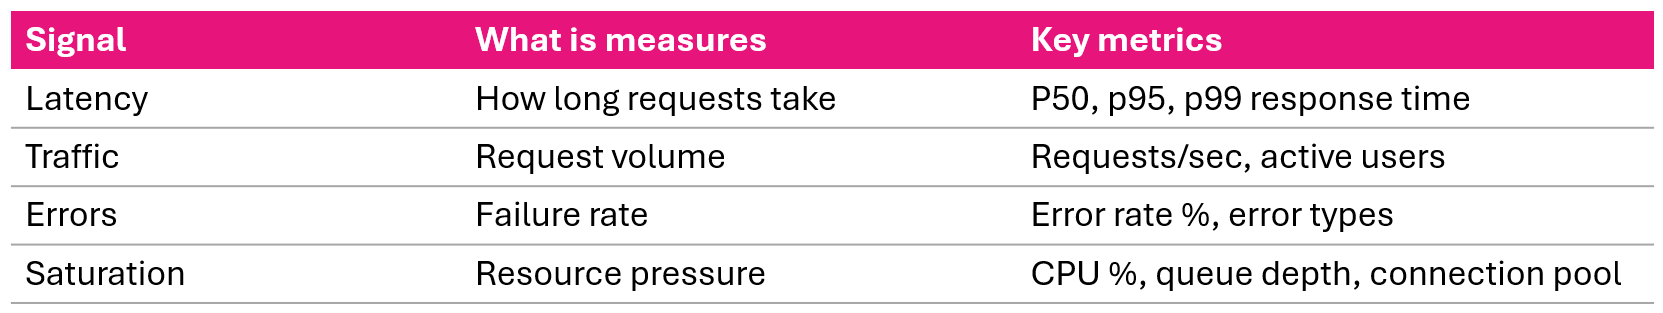
四個黃金指標


監控的四個黃金指標:延遲、流量、錯誤、飽和

掌握這四項,你就能涵蓋絕大多數問題。

AWS 監控與疑難排解

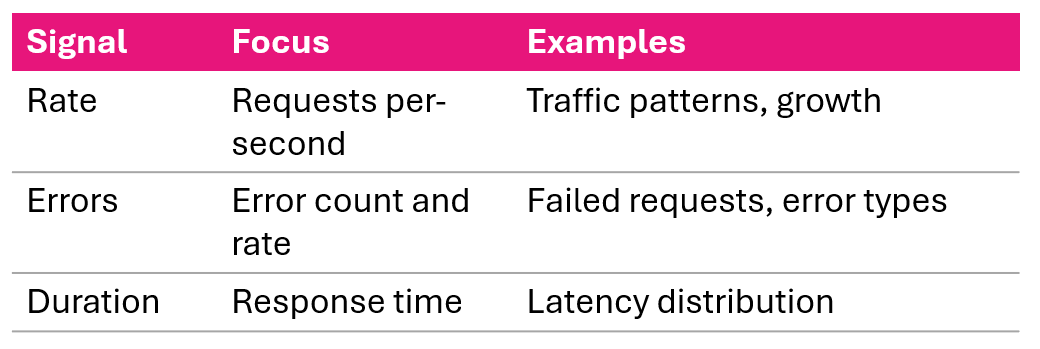
RED 方法


針對請求導向服務的 RED:

RED 方法樣式,顯示 rate、errors、duration 適用於請求導向服務


與黃金指標的關係:

  • RED 是四個黃金指標的聚焦子集
  • 為處理使用者請求的服務而設計
  • 飽和度(第 4 個指標)用於基礎設施監控

以 RED 為起點,加入飽和度以更深入診斷。

AWS 監控與疑難排解

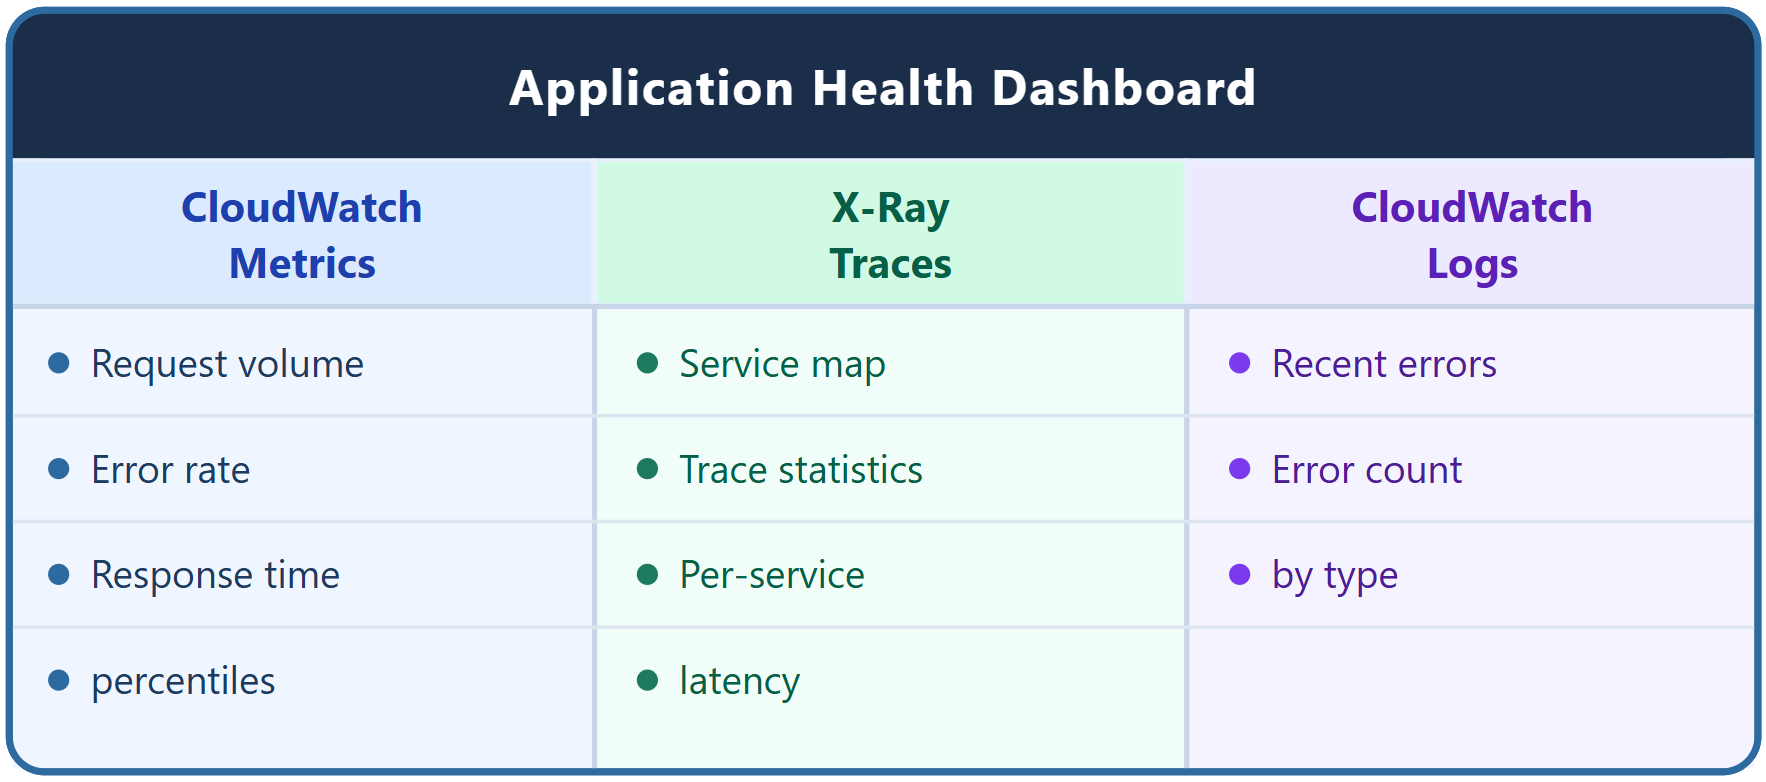
三大資料來源


三種儀表板資料來源示意圖:CloudWatch 指標、X-Ray 追蹤、CloudWatch Logs

AWS 監控與疑難排解

CloudWatch 指標元件

請求量:

["AWS/ApplicationELB",
 "RequestCount",
 {"stat": "Sum"}]

錯誤率(metric math):

"metrics": [
  ["AWS/Lambda", "Errors",
   {"stat":"Sum","id":"errors"}],
  [".", "Invocations",
   {"stat":"Sum","id":"invocations"}],
  [{"expression":
    "(errors/invocations)*100",
    "label":"Error Rate %"}]
]

回應時間分位數:

["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p50"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p95"}],
["AWS/ApplicationELB",
 "TargetResponseTime",
 {"stat": "p99"}]
  • 請求量來自 ALB 的 RequestCount
  • 錯誤率用 metric math:errors / invocations × 100
  • 回應時間的 p50、p95、p99 分位數
AWS 監控與疑難排解

X-Ray 與日誌元件


X-Ray 元件:

  • Service map-含健康指標的應用拓樸
  • Trace statistics-平均回應時間、錯誤率、故障率
  • Service latency-各服務回應時間比較


CloudWatch Logs 元件:

最近錯誤查詢:

fields @timestamp, @message
| filter @message like /ERROR/
| sort @timestamp desc
| limit 20

依型別統計錯誤數:

filter @message like /ERROR/
| stats count(*) as errors
    by errorType
| sort errors desc
AWS 監控與疑難排解

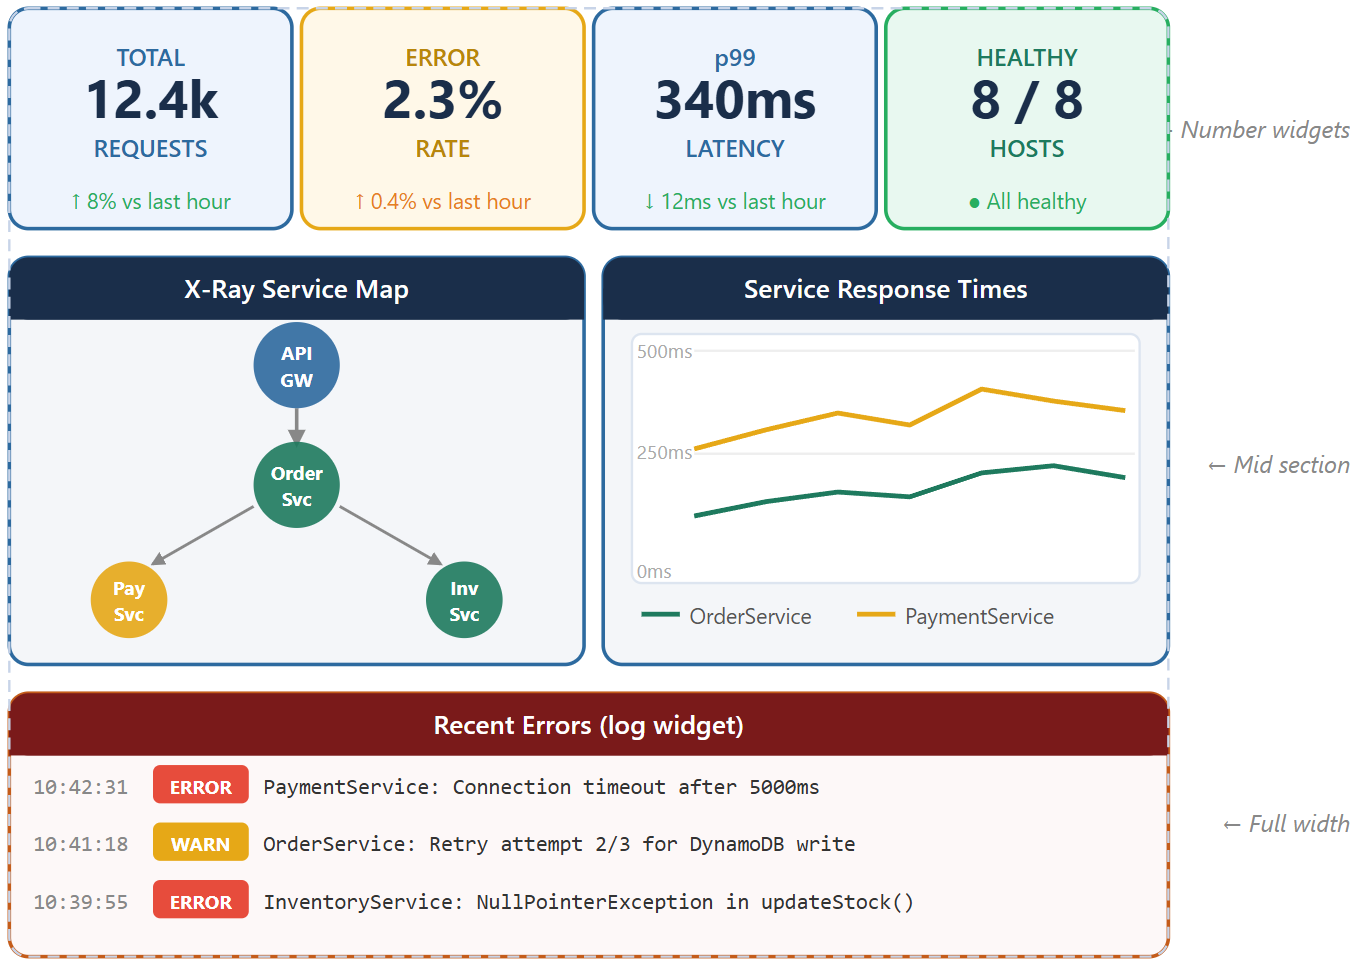
完整儀表板版面配置


健康狀態儀表板版面:上方摘要元件、中間服務地圖、下方錯誤日誌

AWS 監控與疑難排解

事件疑難排解流程


急診分流夾板,含彩色優先帶與聽診器

如同急診分流:穩定 → 診斷 → 處置 → 驗證

  1. 辨識-紅/黃指標、錯誤激增
  2. 界定範圍-哪些服務?何時?是否惡化?
  3. 關聯-錯誤+延遲、流量+資源
  4. 向下鑽研-服務地圖 → 追蹤 → 日誌
  5. 根因-相依、資料庫、記憶體、設定
  6. 修復-斷路器、擴展、回滾、切換備援
  7. 驗證-錯誤率恢復、地圖轉綠、警報清除
AWS 監控與疑難排解

情境 1:突發流量暴增

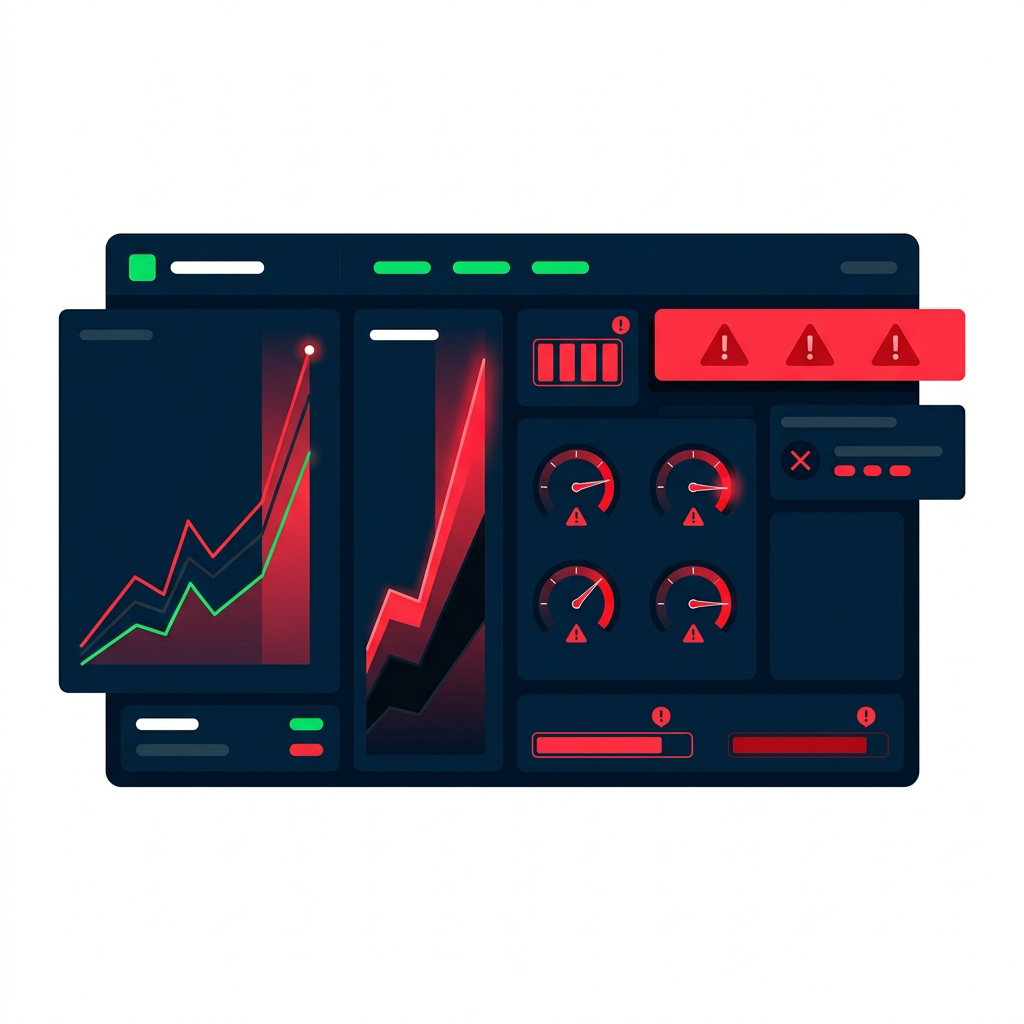
流量激增時的監控儀表板:折線圖劇烈上衝、指針打到紅區、紅色警示橫幅

儀表板上可見:

  • 請求量為平常的 10×
  • 錯誤率 25%
  • 延遲 3000ms
  • CPU 95%

分析: 流量暴增導致資源飽和


採取行動:

  • 立刻擴展(scale out)
  • 啟用自動擴展
  • 實作速率限制
  • 加入快取以減輕後端壓力
AWS 監控與疑難排解

情境 2:資料庫瓶頸

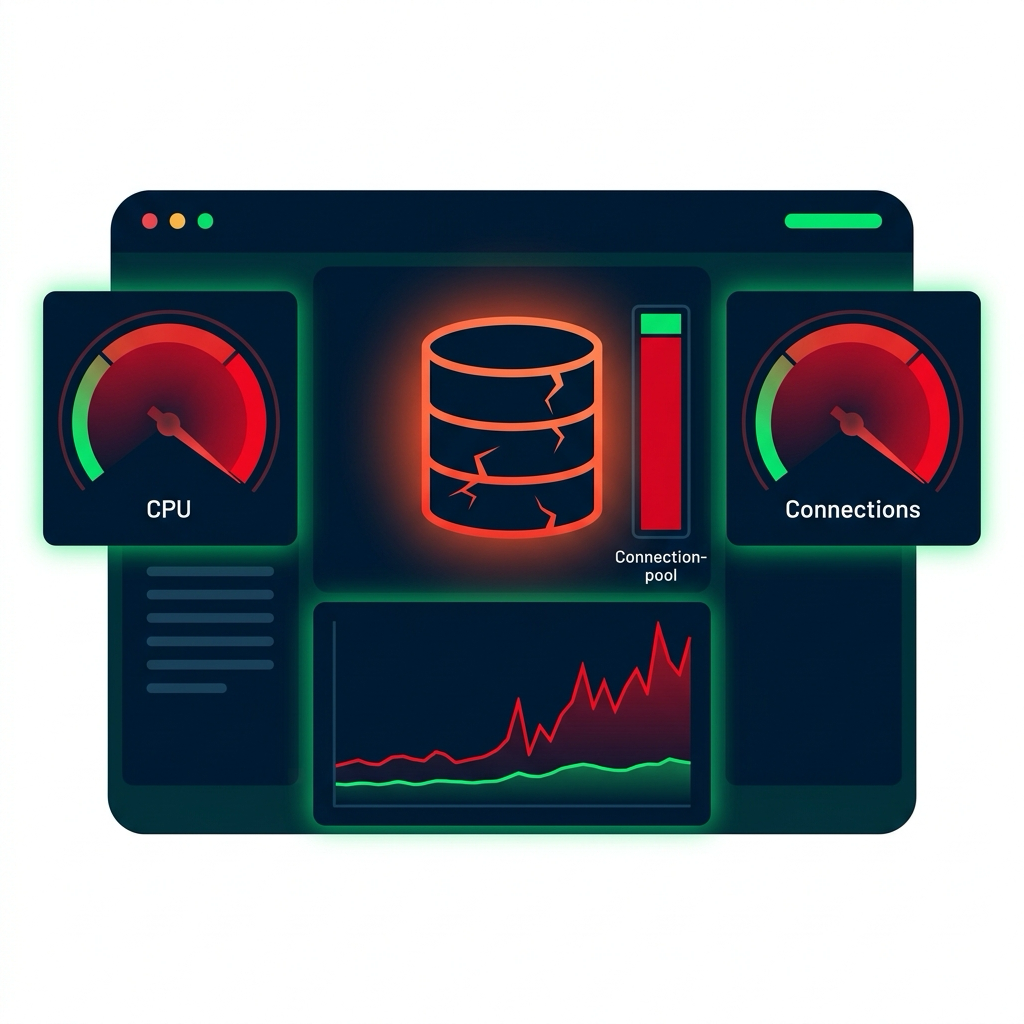
監控儀表板顯示資料庫瓶頸:破裂的紅色 DB 圖示、CPU 與連線錶達紅區、查詢延遲飆升、連線池近滿

儀表板上可見:

  • DB CPU 95%
  • DB 連線 95/100
  • 查詢延遲 5000ms
  • 應用延遲 5500ms

分析: 資料庫成為瓶頸,慢查詢耗盡連線池


採取行動:

  • 從日誌找出慢查詢
  • 新增索引並最佳化查詢
  • 擴大連線池大小
  • 擴展資料庫
AWS 監控與疑難排解

情境 3:連鎖性故障


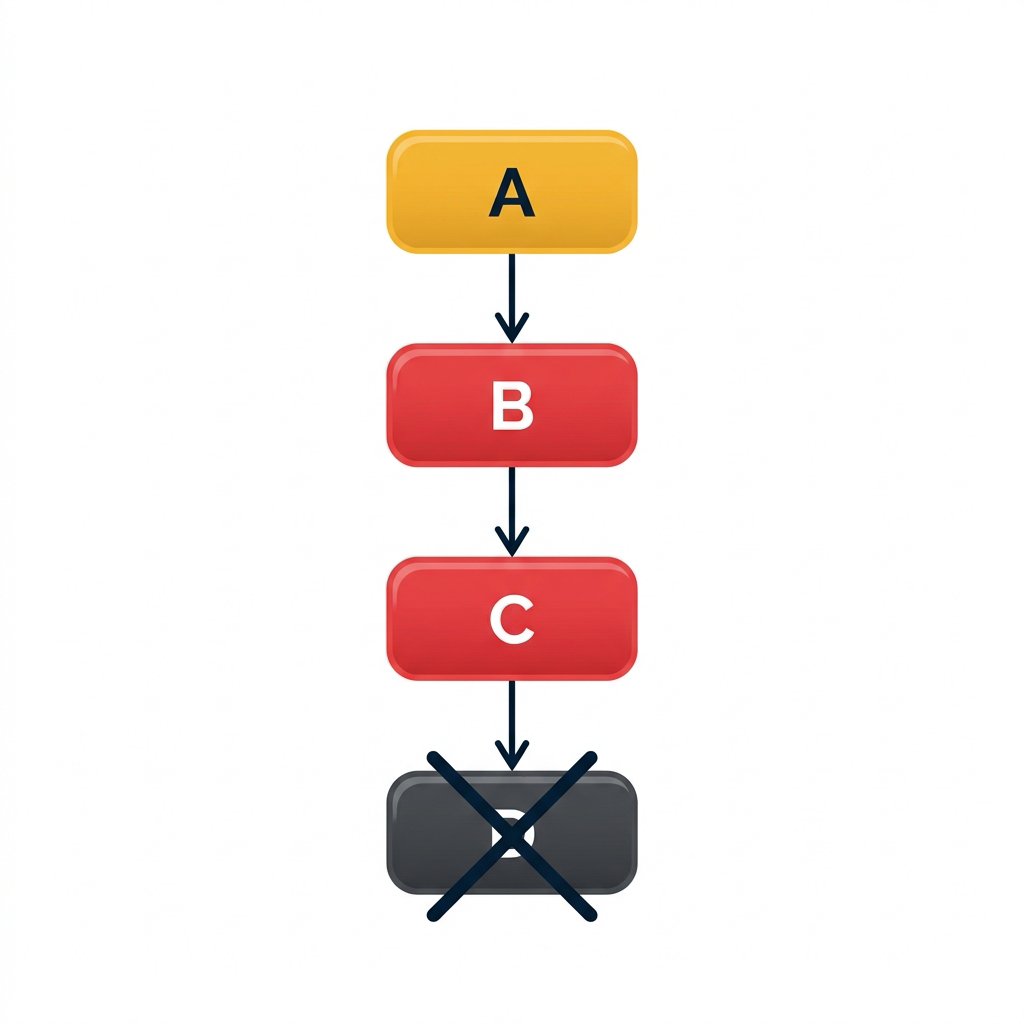
服務地圖上可見:

服務地圖的連鎖故障:節點 A 呈琥珀色為客戶端錯誤,B 與 C 紅色為伺服器故障,D 全黑停擺,箭頭沿鏈往下


分析:

Service A 的小問題沿相依鏈連鎖放大

採取行動:

  • 用斷路器阻斷連鎖
  • 各層服務設置逾時
  • 為失敗相依提供後援機制
  • 修正 Service A 的根因
AWS 監控與疑難排解

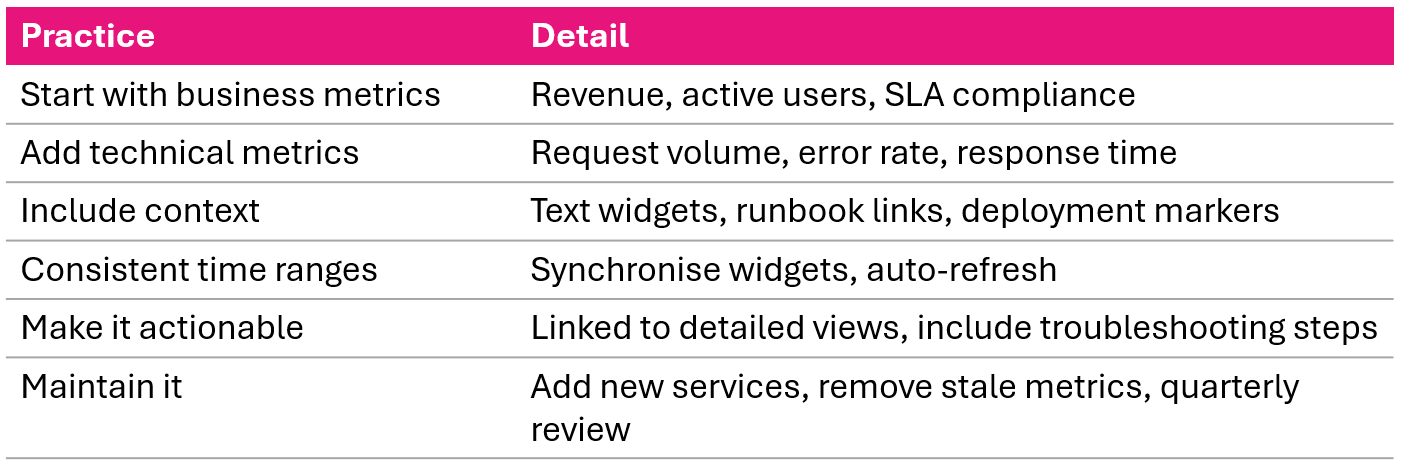
儀表板最佳實務


應用健康監控儀表板的六項建議做法

AWS 監控與疑難排解

影片重點與課程完成

  • 以資訊層級與四個黃金指標來設計
  • 在同一視圖結合 CloudWatch 指標、X-Ray 追蹤與日誌
  • 七步事件流程:辨識 → 界定 → 關聯 → 向下鑽研 → 根因 → 修復 → 驗證

你現在可以:

  • 以 CloudWatch 指標、日誌與儀表板監控
  • 使用 SNS 與 SQS 設定警報與通知
  • 以 X-Ray 實作分散式追蹤
  • 建立應用程式健康儀表板以提升營運卓越
AWS 監控與疑難排解

應用程式健全狀態儀表板

AWS 監控與疑難排解

Preparing Video For Download...