集成方法

用 Python 練習機器學習面試題

Lisa Stuart

Data Scientist

集成學習技術

  • Bootstrap Aggregation(Bagging)
  • Boosting(提升法)
  • 模型堆疊(Stacking)
用 Python 練習機器學習面試題

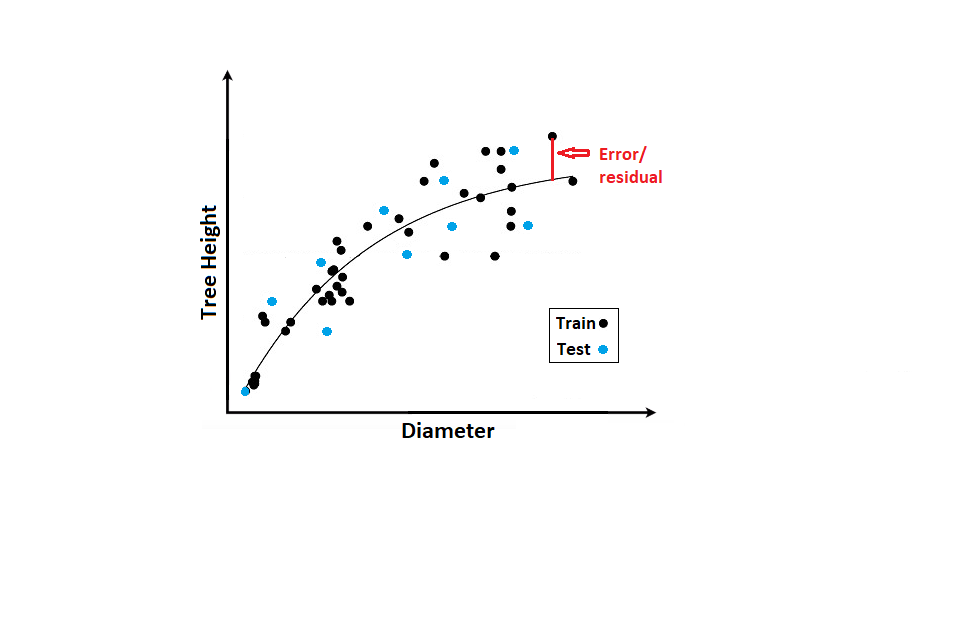
誤差衡量

用 Python 練習機器學習面試題

淺樹(短樹)

用 Python 練習機器學習面試題

深樹(高樹)

用 Python 練習機器學習面試題

寬樹(胖樹)

用 Python 練習機器學習面試題

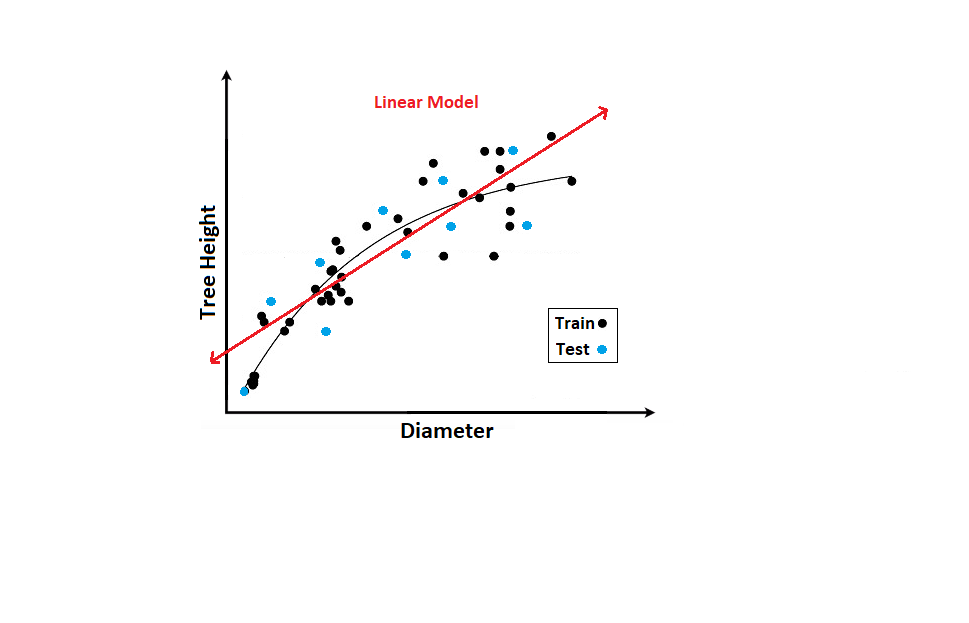
線性模型

用 Python 練習機器學習面試題

偏差(Bias)

線性關係假設(不正確)

  • 高偏差
  • 欠擬合
  • 泛化差
  • 提高複雜度可降低偏差
用 Python 練習機器學習面試題

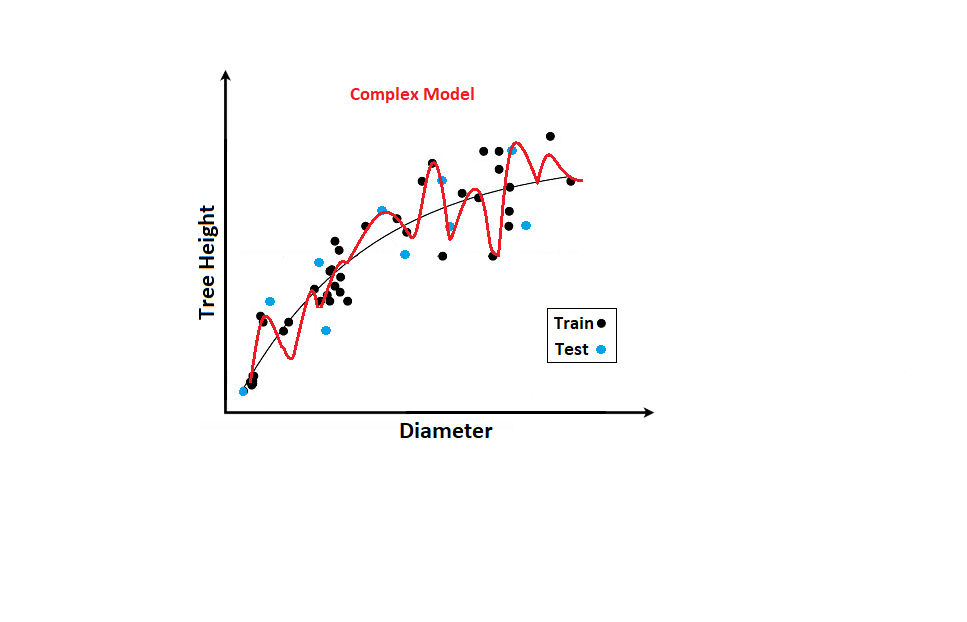
複雜模型

用 Python 練習機器學習面試題

變異(Variance)

高複雜度模型:

  • 高變異
  • 過擬合
  • 泛化差
用 Python 練習機器學習面試題

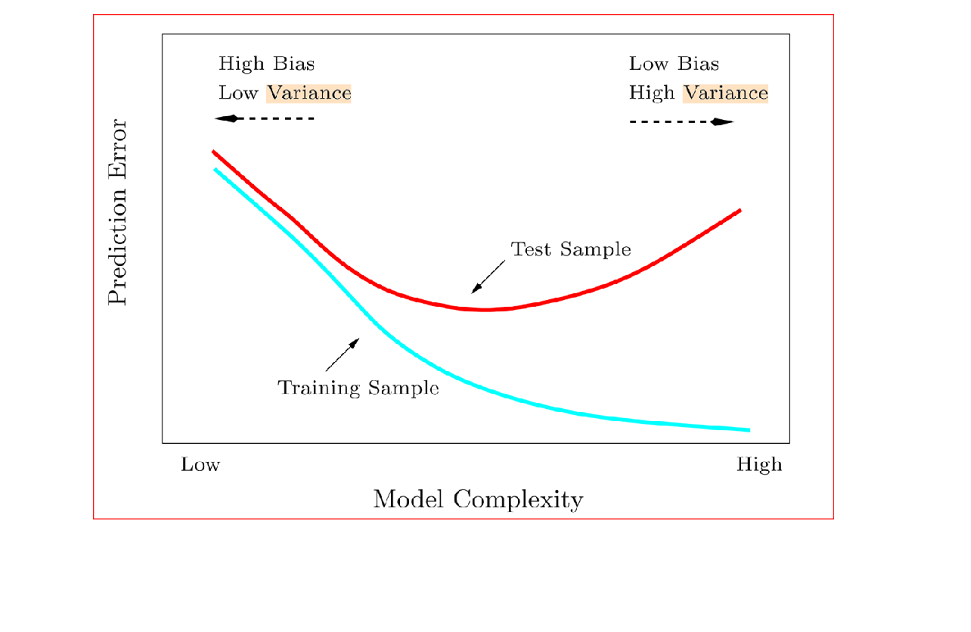
偏差—變異權衡

1 來源:Trevor Hastie、Robert Tibshirani、Jerome Friedman 著《Elements of Statistical Learning》
用 Python 練習機器學習面試題

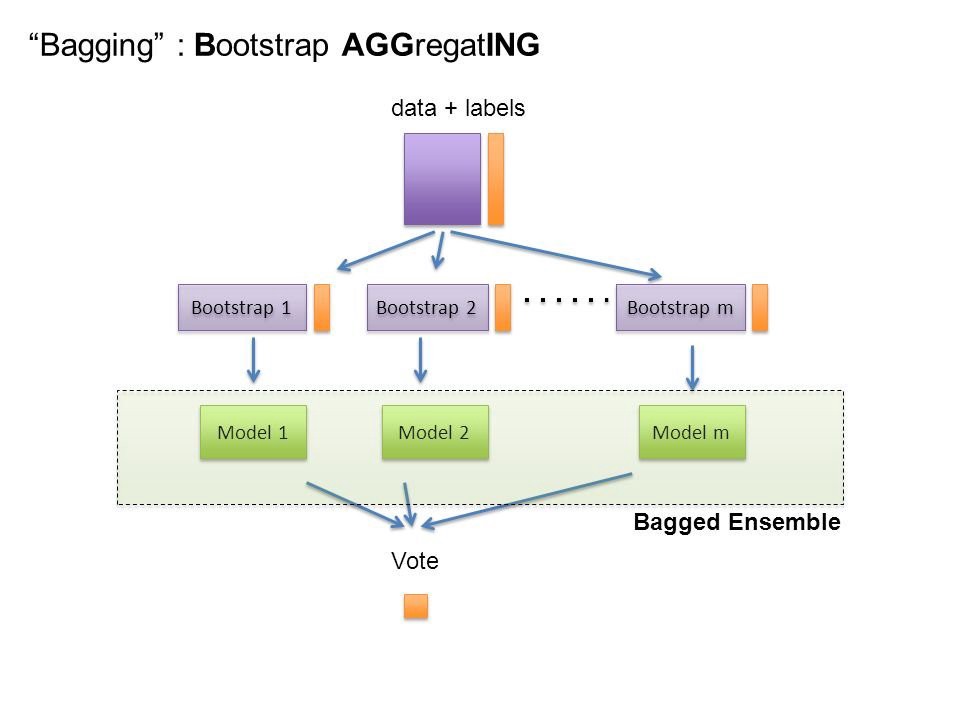
Bagging(自助聚合)

  • 自助抽樣樣本(Bootstrapped samples)
    • 子集以放回抽樣產生
    • 同一列資料可能被選中多次
  • 每個樣本各建一個模型
  • 對輸出取平均
  • 降低變異

1 https://medium.com/@rrfd/boosting-bagging-and-stacking-ensemble-methods-with-sklearn-and-mlens-a455c0c982de
用 Python 練習機器學習面試題

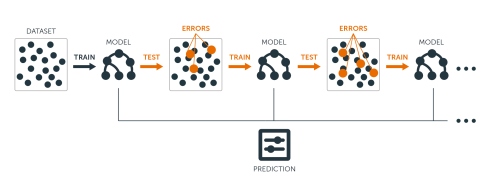
Boosting(提升法)

  • 多個模型依序訓練
  • 對錯誤預測給較大權重
  • 降低偏差

1 https://blog.bigml.com/2017/03/14/introduction-to-boosted-trees/
用 Python 練習機器學習面試題

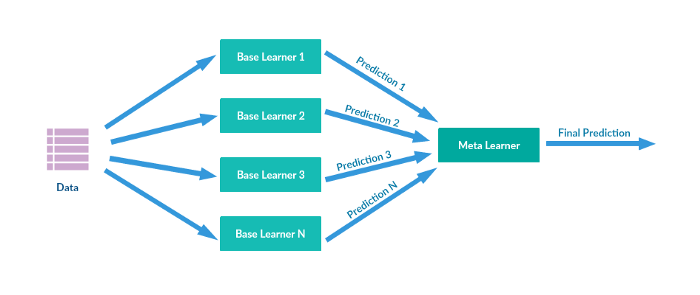
模型堆疊(Stacking)

  • 模型 1 的預測
  • 模型 2 的預測…
  • 模型 N 的預測
  • 堆疊以獲得更高準確度的最終模型
    • 以基礎模型(模型 N)的預測作為第二層模型的輸入

1 http://supunsetunga.blogspot.com/
用 Python 練習機器學習面試題

Vecstack 套件

# import modules
from sklearn.ensemble import BaggingClassifier
from sklearn.ensemble import AdaBoostClassifier
from xgboost import XGBClassifier
from vecstack import stacking

# Create list: stacked_models
stacked_models = [BaggingClassifier(n_estimators=25, random_state=123), AdaBoostClassifier(n_estimators=25, random_state=123)]

# Stack the models: stack_train, stack_test
stack_train, stack_test = stacking(stacked_models, X_train, y_train, X_test, regression=False, mode='oof_pred_bag', 
                                   needs_proba=False, metric=accuracy_score, n_folds=4, stratified=True, shuffle=True, random_state=0, verbose=2)

# Initialize and fit 2nd level model
final_model = XGBClassifier(random_state=123, n_jobs=-1, learning_rate=0.1, n_estimators=10, max_depth=3)
final_model_fit = final_model.fit(stack_train, y_train)

# Predict: stacked_pred
stacked_pred = final_model.predict(stack_test)

# Final prediction score
print('Final prediction score: [%.8f]' % accuracy_score(y_test, stacked_pred))
1 https://towardsdatascience.com/automate-stacking-in-python-fc3e7834772e
用 Python 練習機器學習面試題

集成相關函式

演算法 函式
自助聚合(Bagging) sklearn.ensemble.BaggingClassifier()
提升法(Boosting) sklearn.ensemble.AdaBoostClassifier()
XGBoost xgboost.XGBClassifier()
用 Python 練習機器學習面試題

Bagging vs Boosting

技術 偏差 變異
Bootstrap aggregation(Bagging) 增加 降低
Boosting 降低 增加
用 Python 練習機器學習面試題

集成技術重點:單選題

以下關於機器學習三大集成技術的敘述,哪一項是正確的? 請選出正確的敘述:

  • Boosting 方法會降低模型變異。
  • Boosting 方法會提升分類器的預測能力。
  • 自助聚合(bagging)會降低模型偏差。
  • 模型堆疊會將個別模型的預測結合,形成更高準確度的模型。
用 Python 練習機器學習面試題

集成技術重點:解答

以下關於機器學習三大集成技術的敘述,哪一項是正確的? 正確答案是:

  • 模型堆疊會將個別模型的預測結合,形成更高準確度的模型。(由多個個別模型的預測建立的最終模型,幾乎總能優於單一模型。)
用 Python 練習機器學習面試題

集成技術重點:錯誤選項說明

以下關於機器學習三大集成技術的敘述,哪一項是正確的?

  • Boosting 方法會降低模型變異。(Boosting 主要降低偏差,同時可能提升變異,以取得較佳泛化的平衡。)
  • Boosting 方法會提升分類器的預測能力。(Boosting 降低偏差,但是否提升預測能力不一定。)
  • 自助聚合(bagging)會降低模型偏差。(Bagging 是降低變異。)
用 Python 練習機器學習面試題

一起來練習吧!

用 Python 練習機器學習面試題

Preparing Video For Download...