檢定力與樣本數

R 中的 A/B 測試

Lauryn Burleigh

Data Scientist

檢定力定義
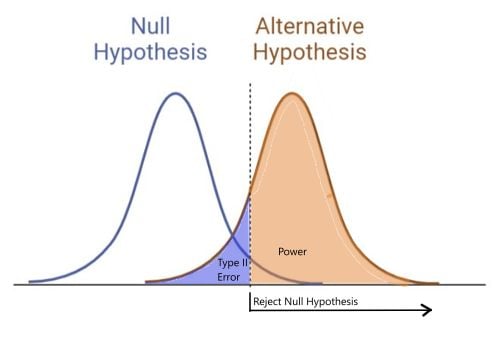
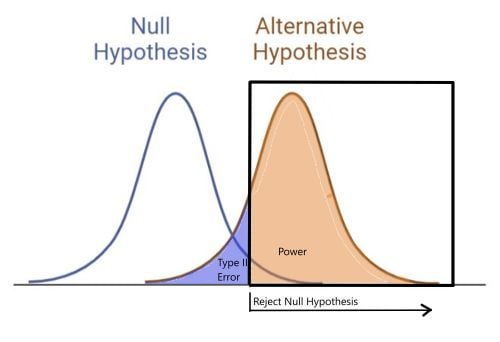
  • 在虛無假設為「錯」時拒絕它的機率
  • 不犯第二類錯誤(未拒絕應該拒絕的虛無)
  • 理想:第二類錯誤小、檢定力大

左為虛無假設常態分布,右為對立假設分布,部分重疊。虛線水平線標示分布重疊處的 p 值。對立假設下該線左側為第二類錯誤,右側為檢定力。

R 中的 A/B 測試

檢定力的好處

檢定的實用性

  • 在該拒絕時拒絕虛無假設

左為虛無假設常態分布,右為對立假設分布,部分重疊。虛線水平線標示分布重疊處的 p 值。對立假設下該線左側為第二類錯誤,右側為檢定力。

檢定力

  • 決定所需樣本數
  • 檢查結果是否可信
R 中的 A/B 測試

樣本數

  • 預估效應量
  • 預估檢定力(常用 0.8)
  • Alpha(常用 0.05)

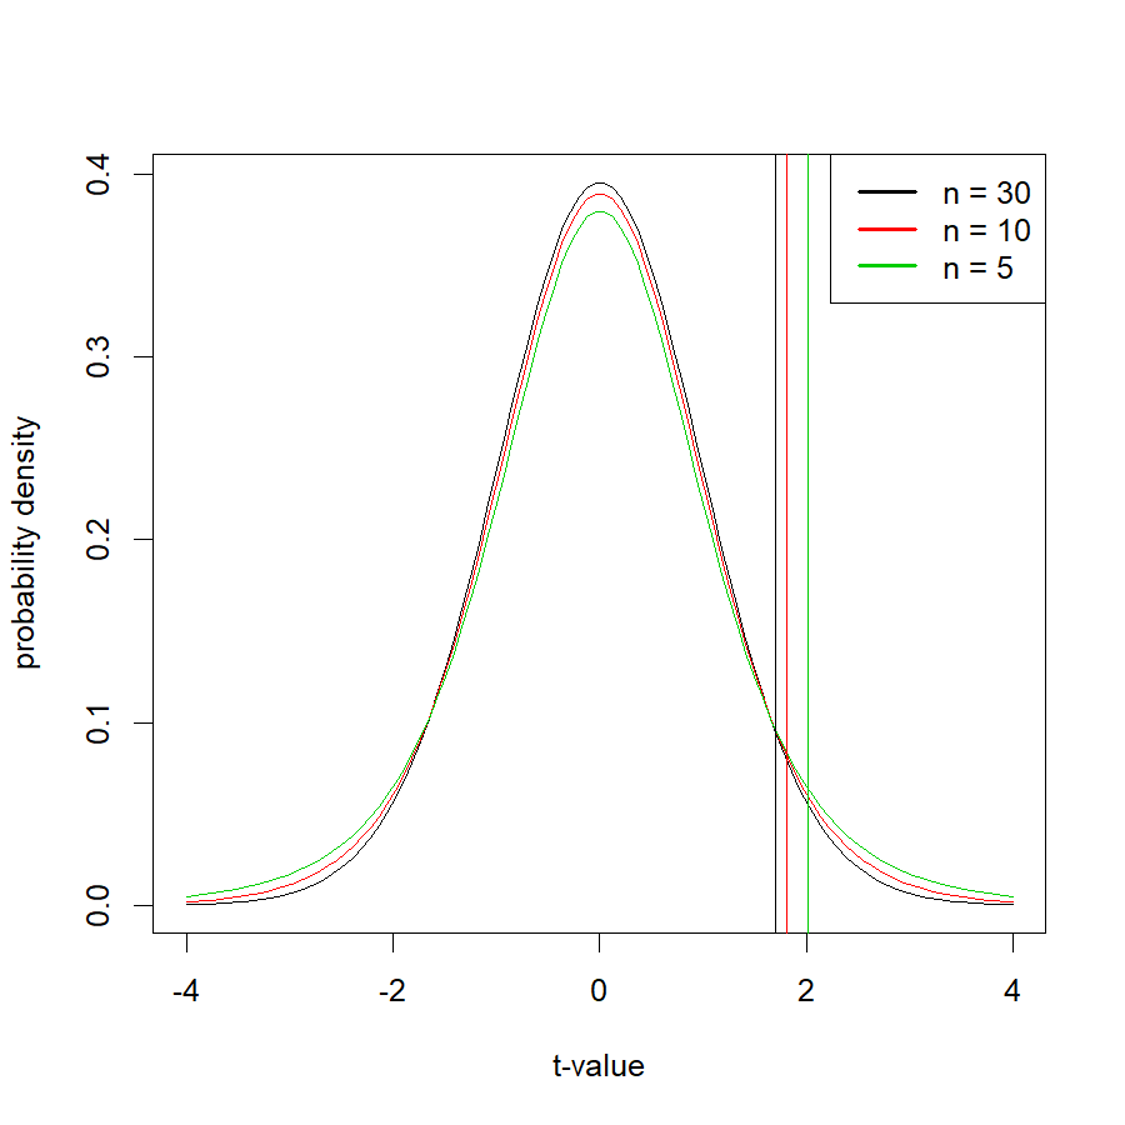
不同樣本數的重疊分布;較小樣本數的 t 值分布較寬,表示要達顯著需更大的 t 值。

library(pwr)
pwr.t.test(d = .8, power = 0.8,

sig.level = 0.05,
type = "one.sample",
alternative = "two.sided")
     One-sample t test power calculation 
              n = 14.30276
              d = 0.8
      sig.level = 0.05
          power = 0.8
    alternative = two.sided
R 中的 A/B 測試

效應量

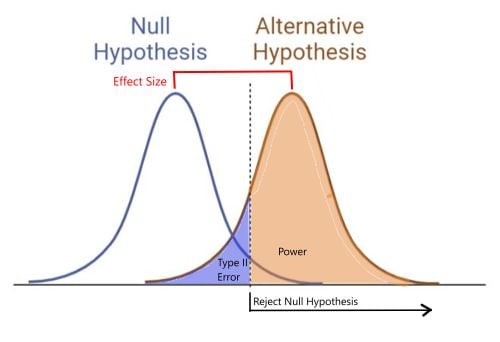
  • 預期的效應大小
  • 控制組平均-實驗組平均

左為虛無假設常態分布,右為對立假設分布,部分重疊。虛線水平線標示分布重疊處的 p 值。紅色標示兩峰間距,代表效應量。

分析前

求效應量依據:

  • 背景資訊
  • 初步資料


分析後

求效應量依據:

  • 全部資料集
R 中的 A/B 測試

檢定的檢定力分析

檢定力越高=正確拒絕虛無假設的機率越高

三要素:

  • 樣本數
  • 效應量
  • Alpha
library(pwr)
pwr.t.test(n = 20, sig.level = 0.045, 
           d = .81, type = "one.sample")
     One-sample t test power calculation 
              n = 20
              d = 0.81
      sig.level = 0.045
          power = 0.9223189
    alternative = two.sided
R 中的 A/B 測試

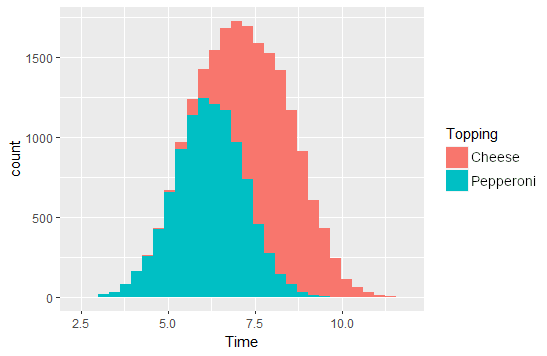
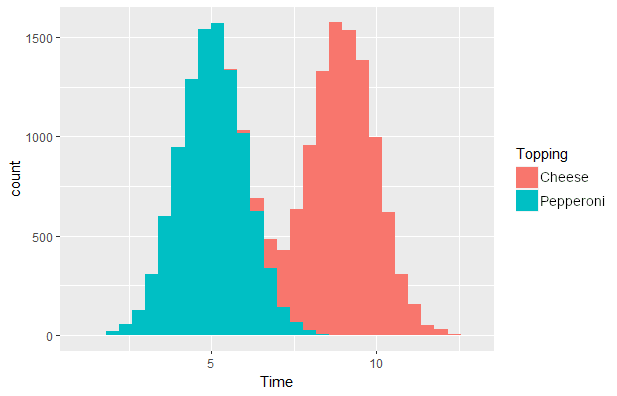
披薩分布

分布相近

無顯著差異

兩個長條圖:Pepperoni(粉紅)與 Cheese(藍色)。x 軸為各取值,y 軸為出現次數,兩者峰值彼此接近。

分布不同

可能有顯著差異

兩個長條圖:Pepperoni(粉紅)與 Cheese(藍色)。x 軸為各取值,y 軸為出現次數,兩者峰值分離。

R 中的 A/B 測試

披薩假設

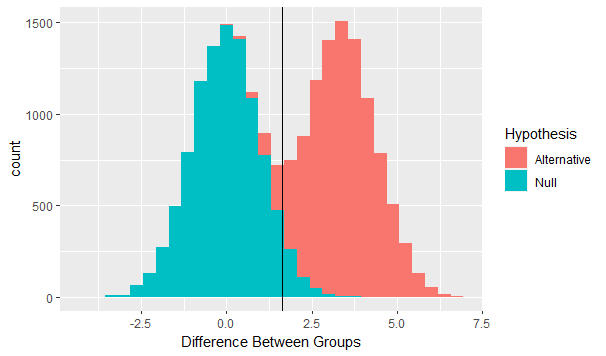
虛無假設分布(粉紅,平均差 0)與對立假設分布(藍色,平均差 3.5),臨界拒絕值以 1.64 的垂直線標示。

  • 相近:落在拒絕值左側
  • 不同:落在拒絕值右側
library(ggplot2)
ggplot(HypDists, 
       aes(x = Time, fill = Hypothesis)) + 
  geom_histogram() + 
  xlab("Difference Between Groups") + 
  geom_vline(xintercept = 1.64)
R 中的 A/B 測試

披薩的檢定力

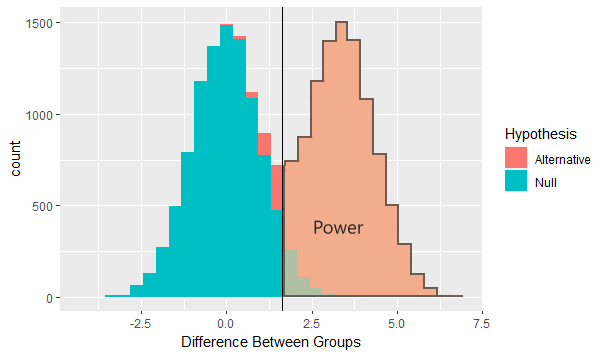
虛無假設分布(粉紅,平均差 0)與對立假設分布(藍色,平均差 3.5),臨界拒絕值以 1.64 的垂直線標示。

  • 相近:落在拒絕值左側
  • 不同:落在拒絕值右側
  • 檢定力:不會錯誤判為相同配料分布的機率(第二類錯誤)
library(ggplot2)
ggplot(HypDists, 
       aes(x = Time, fill = Hypothesis)) + 
  geom_histogram() + 
  xlab("Difference Between Groups") + 
  geom_vline(xintercept = 1.64)
R 中的 A/B 測試

一起來練習吧!

R 中的 A/B 測試

Preparing Video For Download...