選擇演算法

使用 PySpark 進行特徵工程

John Hogue

Lead Data Scientist, General Mills

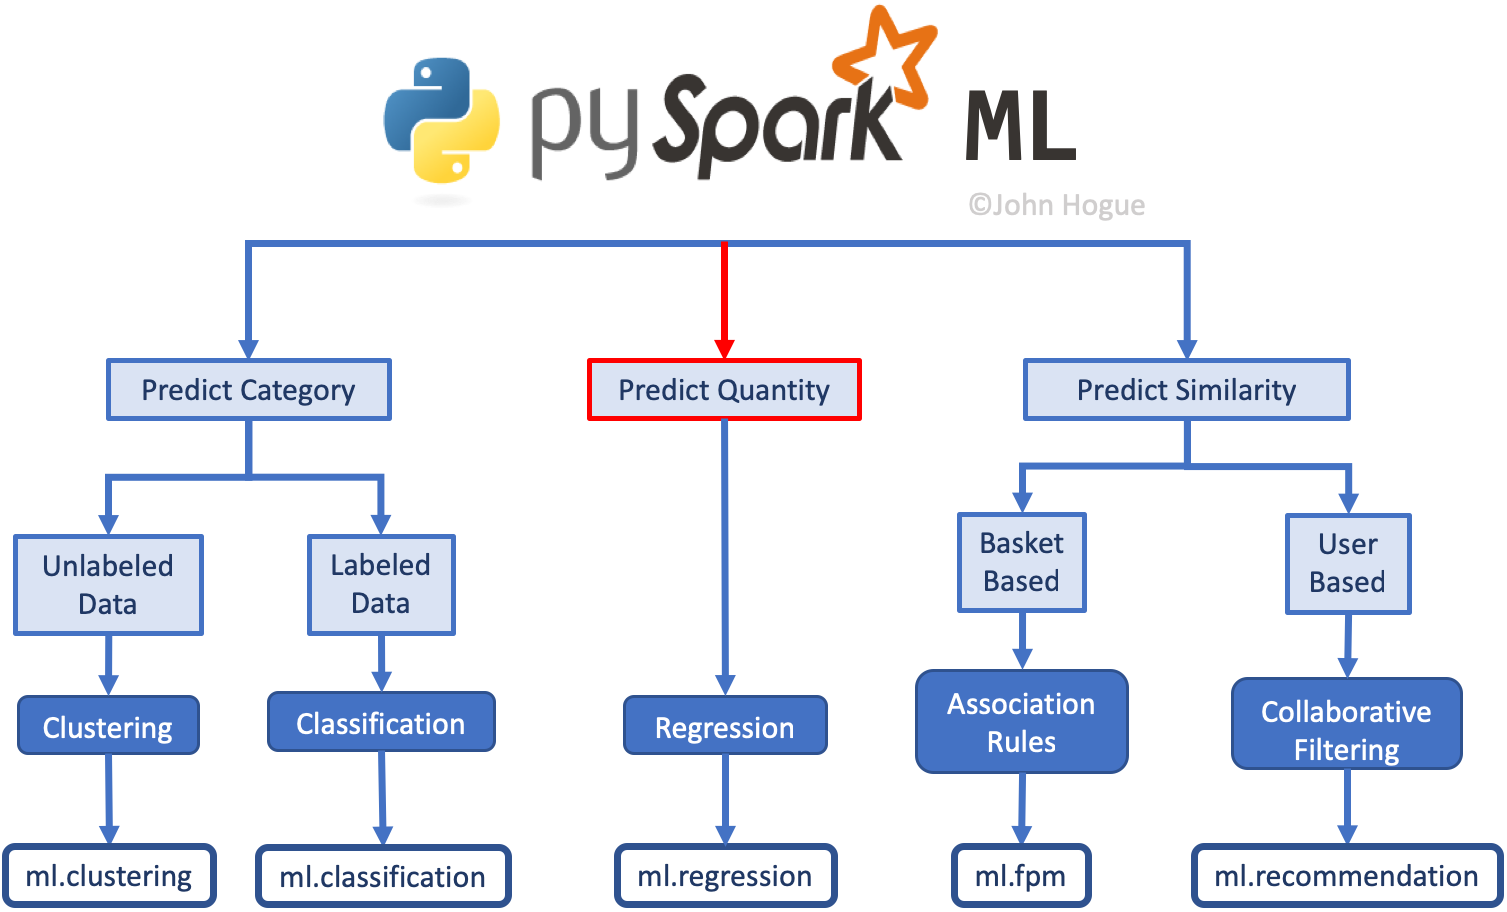
Spark ML 全景

機器學習流程圖

使用 PySpark 進行特徵工程

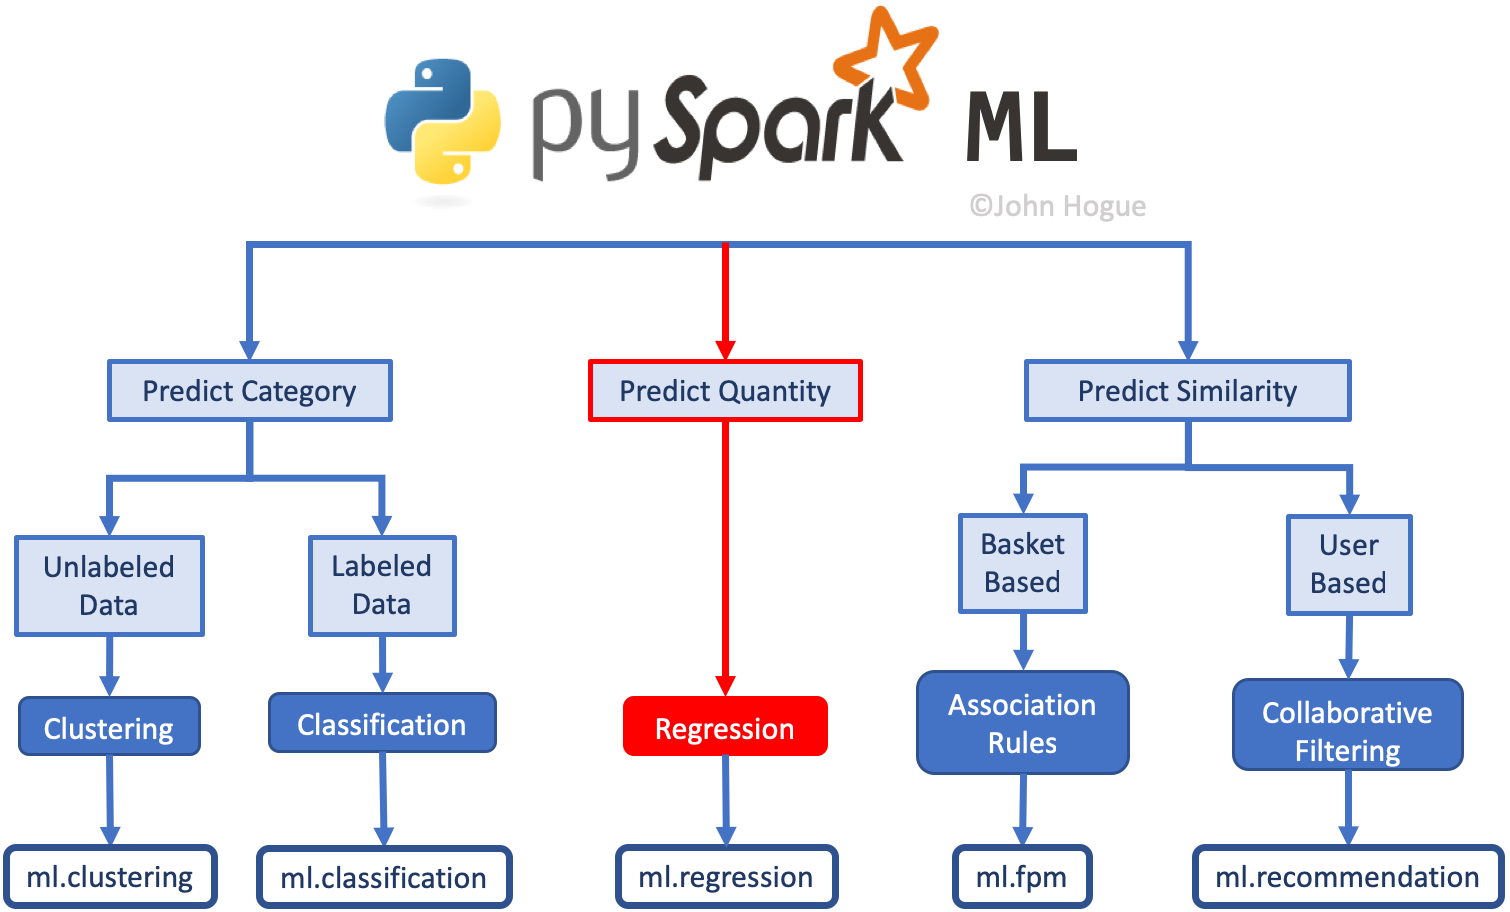
Spark ML 全景

機器學習流程圖

使用 PySpark 進行特徵工程

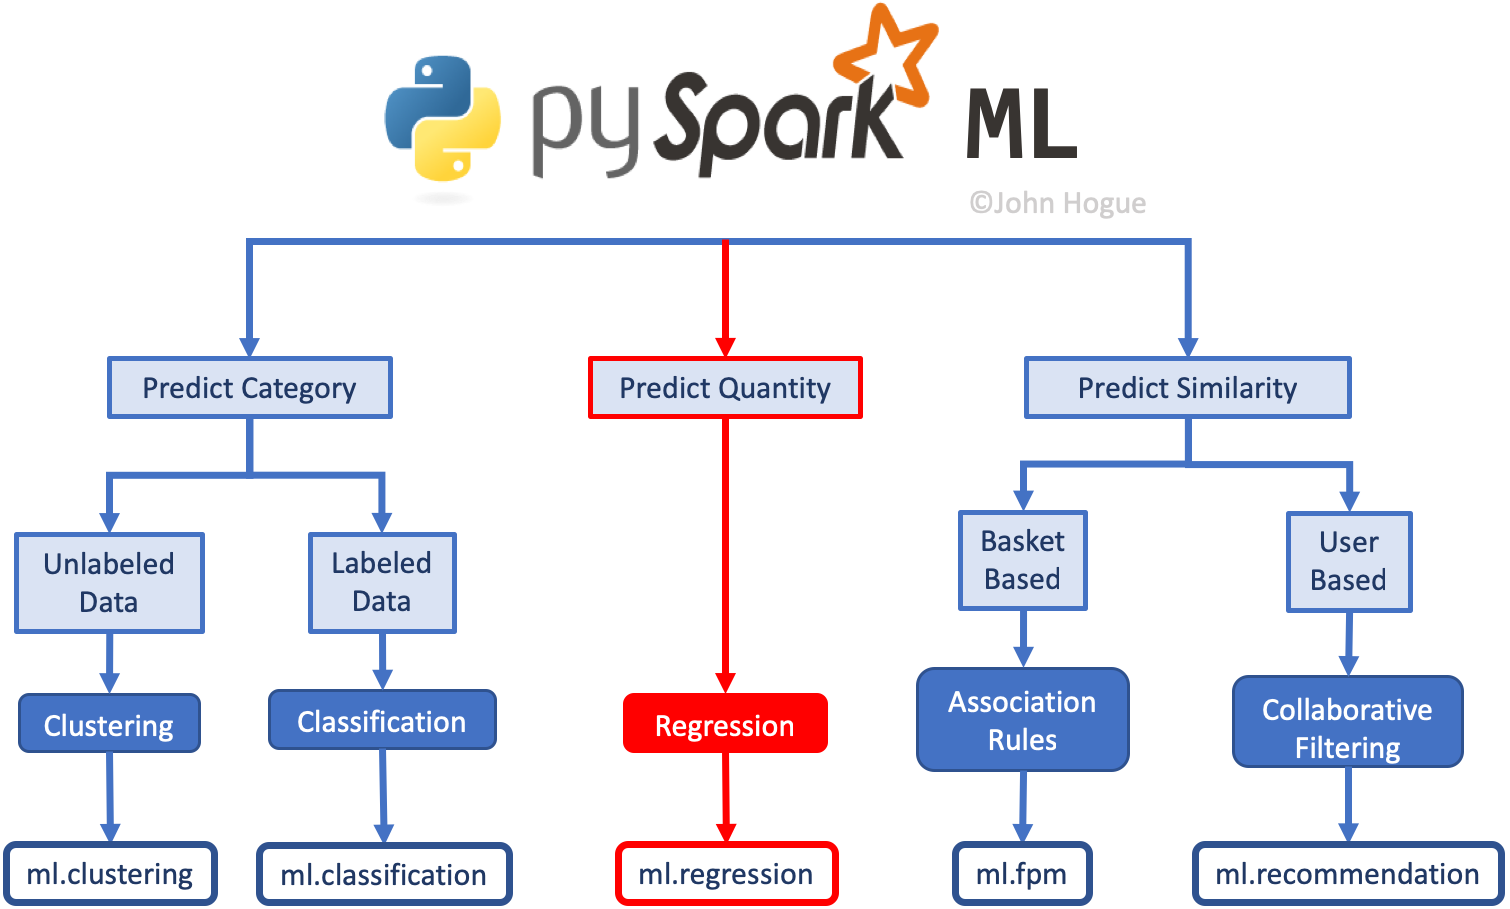
Spark ML 全景

機器學習流程圖

使用 PySpark 進行特徵工程

Spark ML 全景

機器學習流程圖

使用 PySpark 進行特徵工程

PySpark 迴歸方法

ml.regression 中的方法:

  • GeneralizedLinearRegression
  • IsotonicRegression
  • LinearRegression


  • DecisionTreeRegression
  • GBTRegression
  • RandomForestRegression
使用 PySpark 進行特徵工程

PySpark 迴歸方法

ml.regression 中的方法:

  • GeneralizedLinearRegression
  • IsotonicRegression
  • LinearRegression


  • DecisionTreeRegression
  • GBTRegression
  • RandomForestRegression
使用 PySpark 進行特徵工程

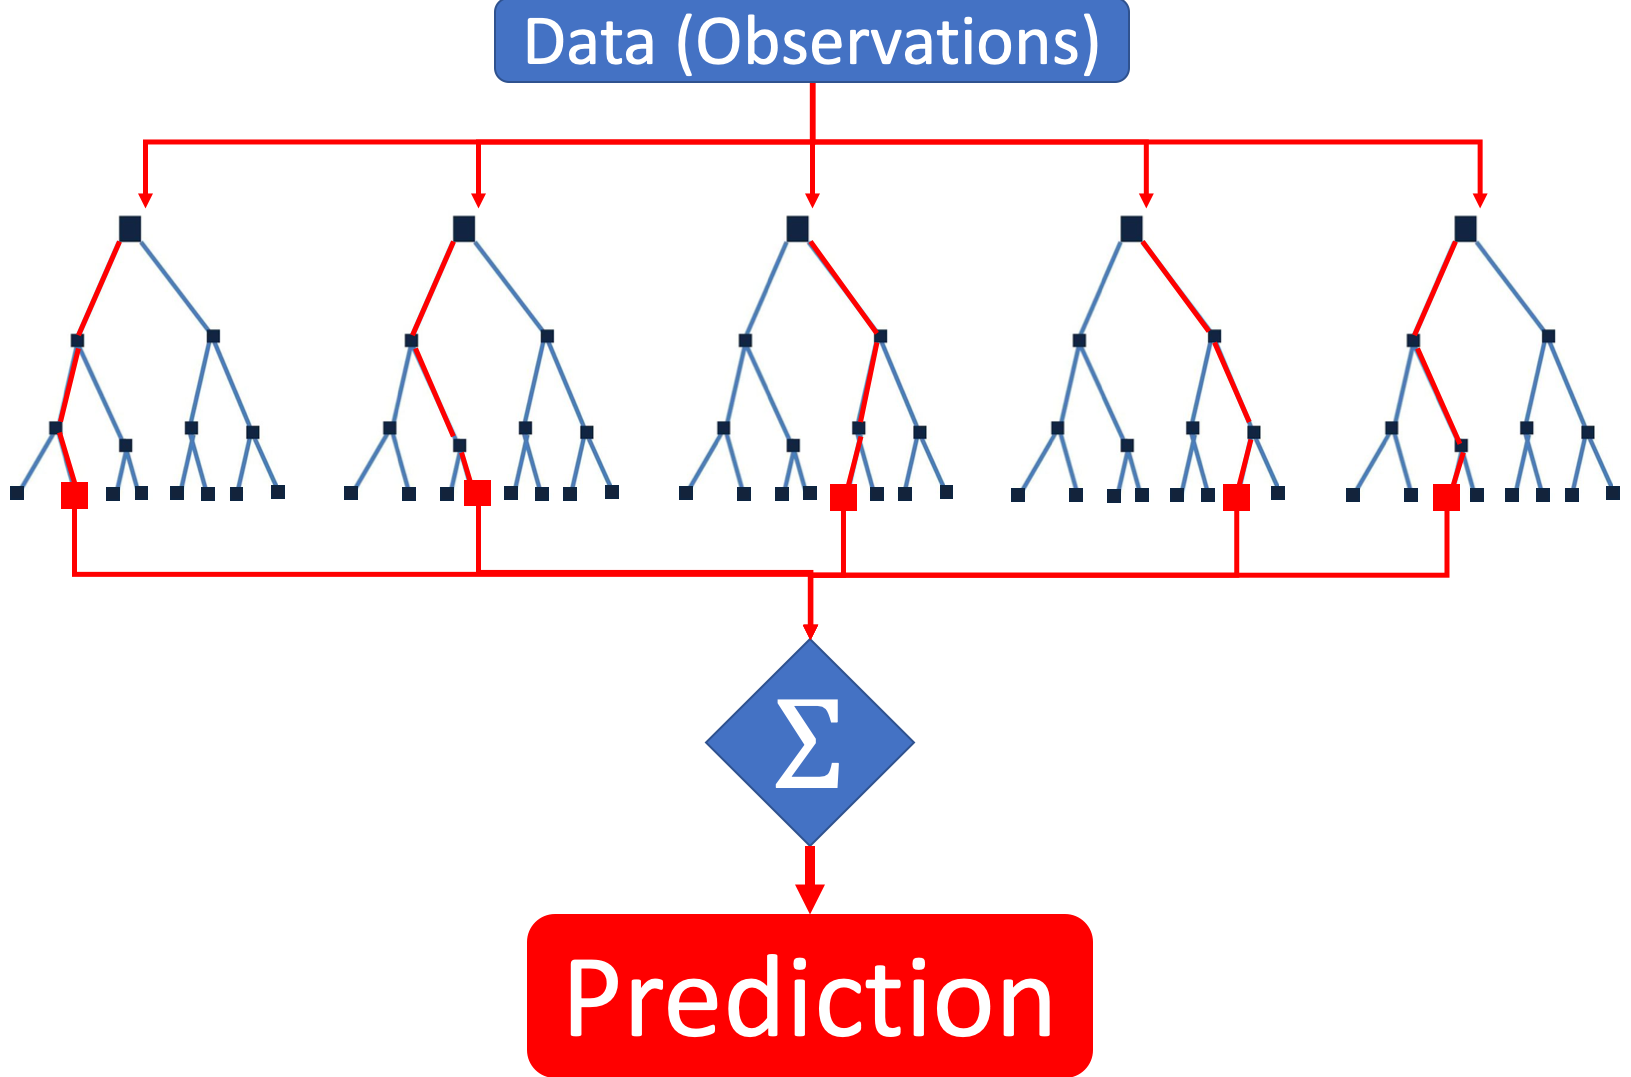
隨機森林迴歸示意圖

使用 PySpark 進行特徵工程

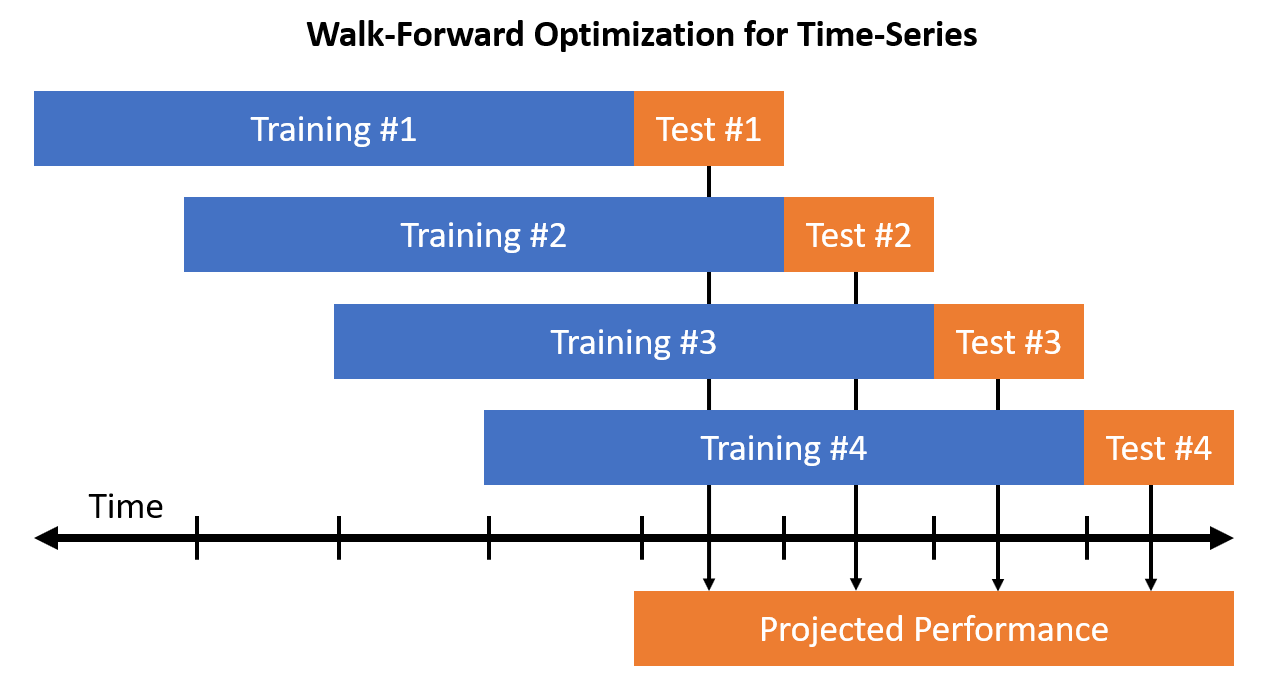
時間序列的訓練/測試切分

使用 PySpark 進行特徵工程

時間序列的訓練/測試切分

# Create variables for max and min dates in our dataset
max_date = df.agg({'OFFMKTDATE': 'max'}).collect()[0][0]
min_date = df.agg({'OFFMKTDATE': 'min'}).collect()[0][0]
# Find how many days our data spans
from pyspark.sql.functions import datediff
range_in_days = datediff(max_date, min_date)
# Find the date to split the dataset on
from pyspark.sql.functions import date_add
split_in_days = round(range_in_days * 0.8)
split_date = date_add(min_date, split_in_days)
# Split the data into 80% train, 20% test
train_df = df.where(df['OFFMKTDATE'] < split_date) 
test_df = df.where(df['OFFMKTDATE'] >= split_date)\
  .where(df['LISTDATE'] >= split_date)
使用 PySpark 進行特徵工程

一起來練習吧!

使用 PySpark 進行特徵工程

Preparing Video For Download...