DataFrame.join(

    other,      # Other DataFrame to merge

    on=None,    # The keys to join on

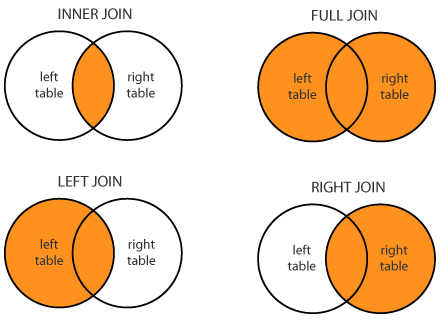
    how=None)   # Type of join to perform (default is 'inner')
PySpark Join 範例
# Inspect dataframe head
hdf.show(2)
+----------+--------------------+
|        dt|                  nm|
+----------+--------------------+
|2012-01-02|        New Year Day|
|2012-01-16|Martin Luther Kin...|
+----------+--------------------+
only showing top 2 rows
# Specify join conditon
cond = [df['OFFMARKETDATE'] == hdf['dt']]

# Join two hdf onto df
df = df.join(hdf, on=cond, 'left')

# How many sales occurred on bank holidays?
df.where(~df['nm'].isNull()).count()
0
SparkSQL Join
對你的 DataFrame 使用 SQL
# Register the dataframe as a temp table
df.createOrReplaceTempView("df")
hdf.createOrReplaceTempView("hdf")
# Write a SQL Statement
sql_df = spark.sql("""
                      SELECT
                        *
                      FROM df
                      LEFT JOIN hdf
                      ON df.OFFMARKETDATE = hdf.dt
                   """)