使用 PySpark 進行特徵工程
John Hogue
Lead Data Scientist, General Mills
df.describe(['LISTPRICE']).show()
+-------+------------------+
|summary|         LISTPRICE|
+-------+------------------+
|  count|              5000|
|   mean|        263419.365|
| stddev|143944.10818036905|
|    min|            100000|
|    max|             99999|
+-------+------------------+
pyspark.sql.functions.mean(col)
pyspark.sql.functions.skewness(col)
pyspark.sql.functions.min(col)
cov(col1, col2)
corr(col1, col2)
mean(col)
df.agg({'SALESCLOSEPRICE': 'mean'}).collect()
[Row(avg(SALESCLOSEPRICE)=262804.4668)]
df.cov('SALESCLOSEPRICE', 'YEARBUILT')
1281910.3840634783
使用 Seaborn 等標準函式庫繪圖前,需先將 PySpark DataFrame 轉成 Pandas
WARNING: 將 PySpark DataFrame 取樣後再轉成 Pandas!
sample(withReplacement, fraction, seed=None)
withReplacement
fraction
seed
# 取樣 50% 的 PySpark DataFrame 並計算列數
df.sample(False, 0.5, 42).count()
2504
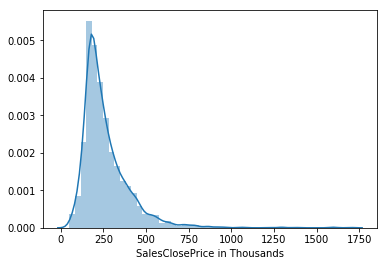
Seaborn distplot()
distplot()
seaborn.distplot(a)
a
# 匯入你喜歡的視覺化函式庫
import seaborn as sns

# 取樣資料框
sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)

# 轉為 Pandas DataFrame
pandas_df = sample_df.toPandas()

# 繪圖
sns.distplot(pandas_df)
# 匯入你喜歡的視覺化函式庫 import seaborn as sns
# 取樣資料框 sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)
# 轉為 Pandas DataFrame pandas_df = sample_df.toPandas()
# 繪圖 sns.distplot(pandas_df)
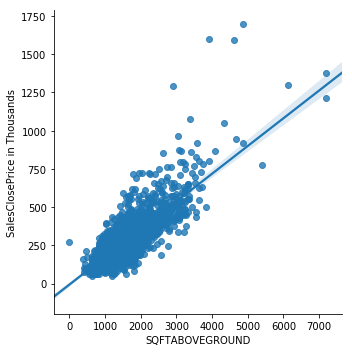
Seaborn lmplot()
lmplot()
seaborn.lmplot(x, y, data)
x
y
data
# 匯入你喜歡的視覺化函式庫
import seaborn as sns

# 選擇欄位
s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND'])
# 取樣資料框
s_df = s_df.sample(False, 0.5, 42)

# 轉為 Pandas DataFrame
pandas_df = s_df.toPandas()

# 繪圖
sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)
# 選擇欄位 s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND']) # 取樣資料框 s_df = s_df.sample(False, 0.5, 42)
# 轉為 Pandas DataFrame pandas_df = s_df.toPandas()
# 繪圖 sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)