使用 PySpark 進行特徵工程
John Hogue
Lead Data Scientist, General Mills
資料蒐集
資料儲存規則
異質資料整併
刻意留白
完全隨機遺漏
隨機遺漏
非隨機遺漏
何時刪除含遺漏值的列?
isNull()
df.where(df['ROOF'].isNull()).count()
765
# Import library
import seaborn as sns

# subset the dataframe
sub_df = df.select(['ROOMAREA1'])

# sample the dataframe
sample_df = sub_df.sample(False, .5, 4)

# Convert to Pandas DataFrame
pandas_df = sample_df.toPandas()

# Plot it
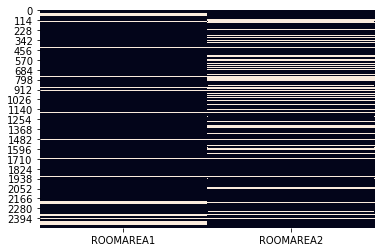
sns.heatmap(data=pandas_df.isnull())
# Import library import seaborn as sns
# subset the dataframe sub_df = df.select(['ROOMAREA1'])
# sample the dataframe sample_df = sub_df.sample(False, .5, 4)
# Convert to Pandas DataFrame pandas_df = sample_df.toPandas()
# Plot it sns.heatmap(data=pandas_df.isnull())
替補遺漏值的流程
規則式
統計式
模型式
** fillna(value, subset=None)
fillna(value, subset=None)
value
subset
# 以 0 替換遺漏值
df.fillna(0, subset=['DAYSONMARKET'])
# 以該欄的平均數替換
col_mean = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
df.fillna(col_mean, subset=['DAYSONMARKET'])