調整資料

使用 PySpark 進行特徵工程

John Hogue

Lead Data Scientist, General Mills

為何要轉換資料?

轉換

使用 PySpark 進行特徵工程

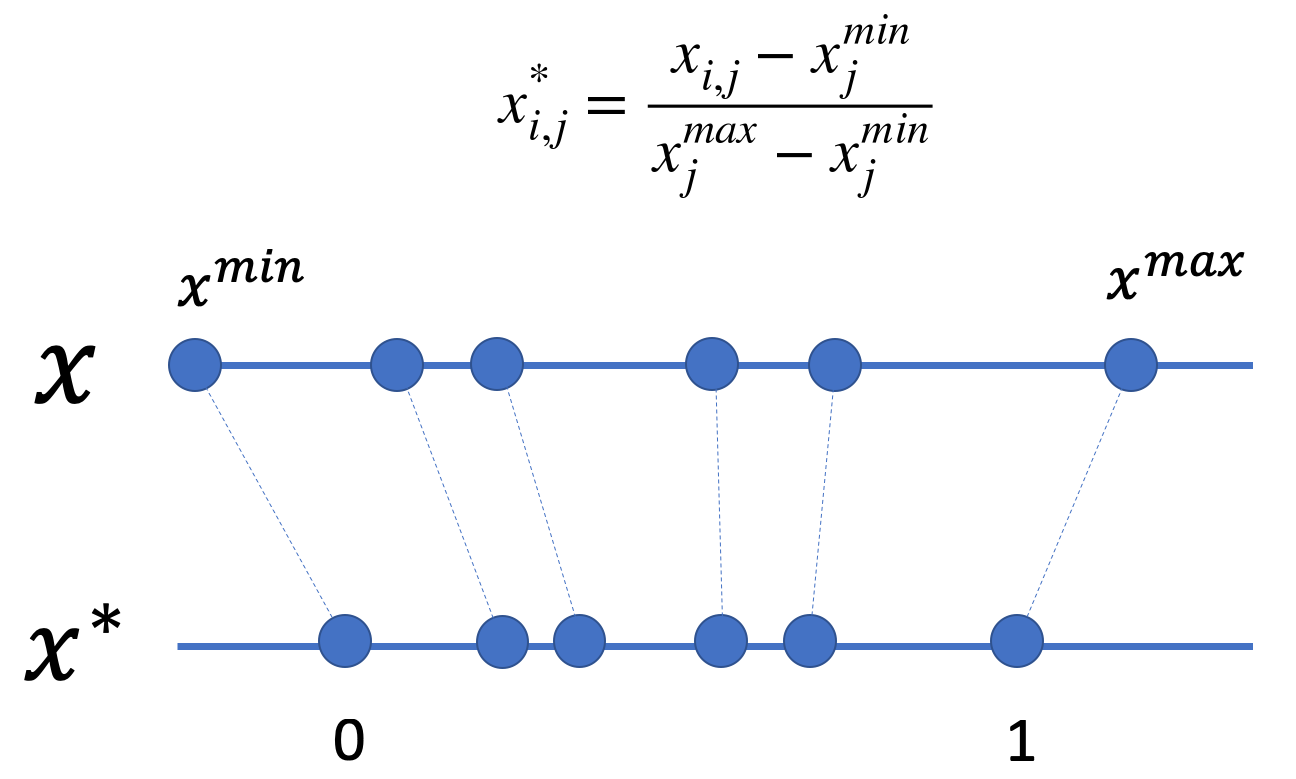
什麼是 MinMax 縮放

最小最大縮放

使用 PySpark 進行特徵工程

MinMax 縮放

# define min and max values and collect them
max_days = df.agg({'DAYSONMARKET': 'max'}).collect()[0][0]
min_days = df.agg({'DAYSONMARKET': 'min'}).collect()[0][0]

# create a new column based off the scaled data df = df.withColumn("scaled_days", (df['DAYSONMARKET'] - min_days) / (max_days - min_days))
df[['scaled_days']].show(5)
+--------------------+
|         scaled_days|
+--------------------+
|0.044444444444444446|
|0.017777777777777778|
| 0.12444444444444444|
| 0.08444444444444445|
| 0.09333333333333334|
+--------------------+
only showing top 5 rows
使用 PySpark 進行特徵工程

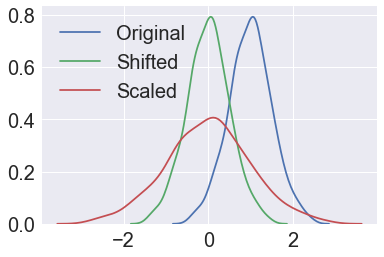
什麼是標準化?

將資料轉為標準常態分布

  • z = (x - μ)/ σ
  • 平均 μ 為 0
  • 標準差 σ 為 1

標準化

使用 PySpark 進行特徵工程

標準化

mean_days = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
stddev_days = df.agg({'DAYSONMARKET': 'stddev'}).collect()[0][0]

# Create a new column with the scaled data df = df.withColumn("ztrans_days", (df['DAYSONMARKET'] - mean_days) / stddev_days)
df.agg({'ztrans_days': 'mean'}).collect()
[Row(avg(ztrans_days)=-3.6568525985103407e-16)]
df.agg({'ztrans_days': 'stddev'}).collect()
[Row(stddev(ztrans_days)=1.0000000000000009)]
使用 PySpark 進行特徵工程

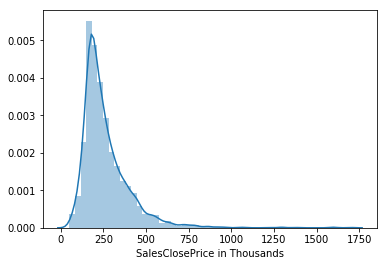
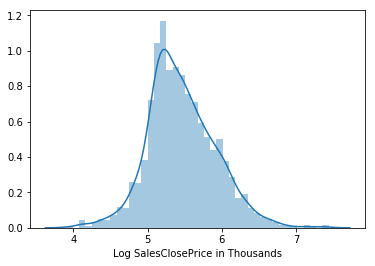
什麼是對數縮放

未縮放分布

原始分布圖

對數縮放分布

對數縮放分布圖

使用 PySpark 進行特徵工程

對數縮放

# import the log function
from pyspark.sql.functions import log
# Recalculate log of SALESCLOSEPRICE
df = df.withColumn('log_SalesClosePrice', log(df['SALESCLOSEPRICE']))
使用 PySpark 進行特徵工程

一起來練習吧!

使用 PySpark 進行特徵工程

Preparing Video For Download...