正確訓練模型

R 中的監督式學習:回歸

Nina Zumel and John Mount

Win-Vector, LLC

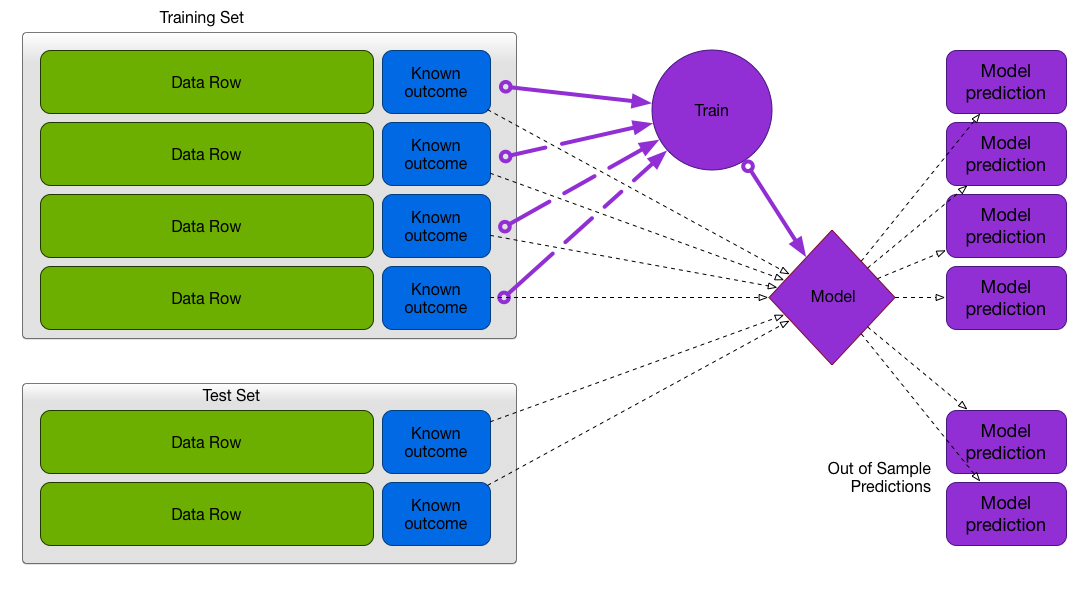
模型在訓練資料上常遠優於未來資料。
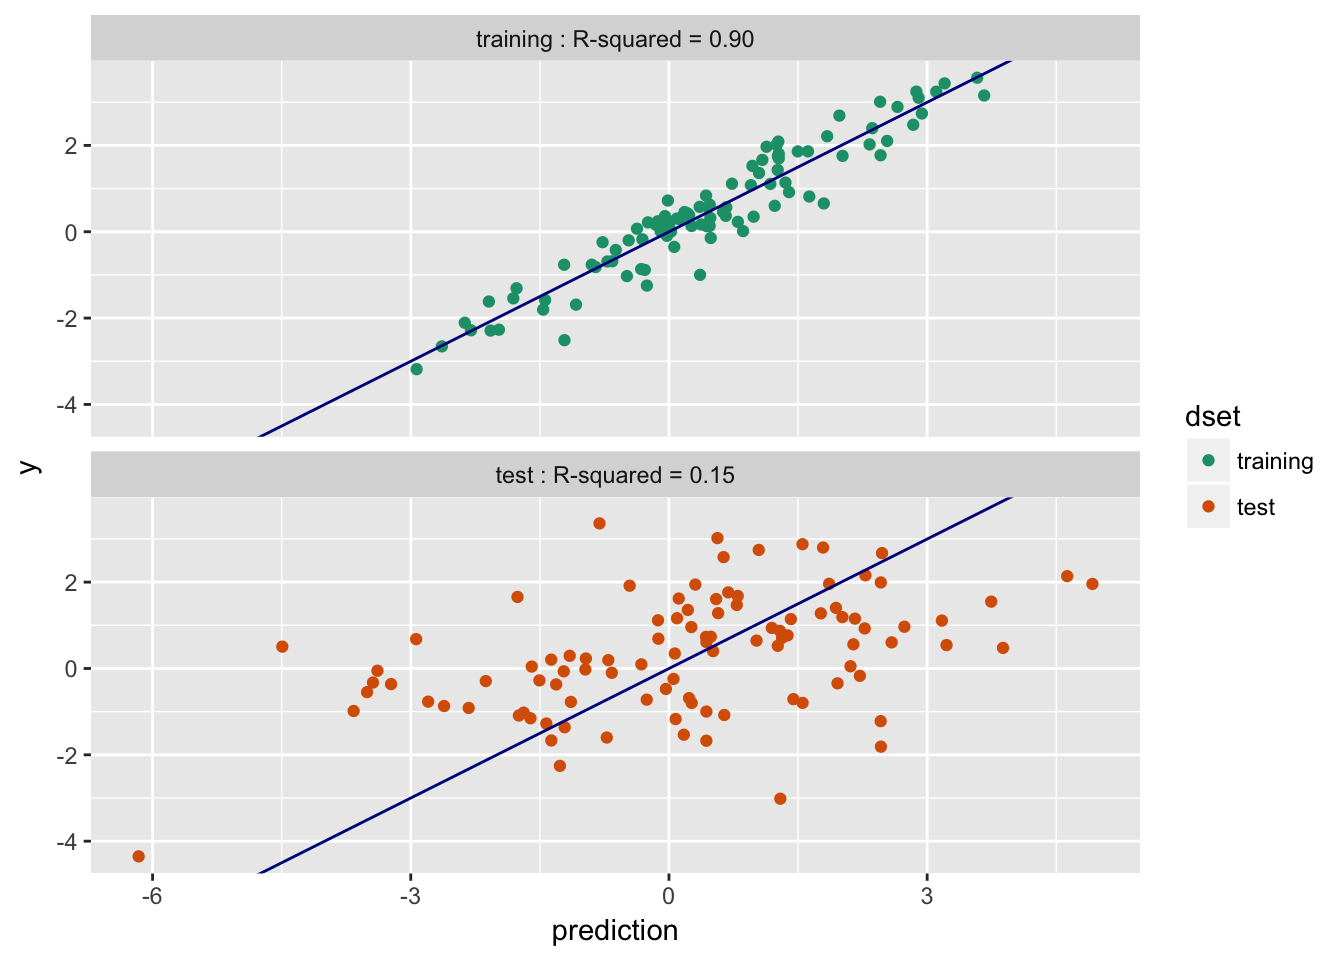
  • 訓練 $R^2$: 0.9;測試 $R^2$: 0.15 —— 過度擬合
R 中的監督式學習:回歸

訓練/測試切分

當資料充足時的建議方法

R 中的監督式學習:回歸

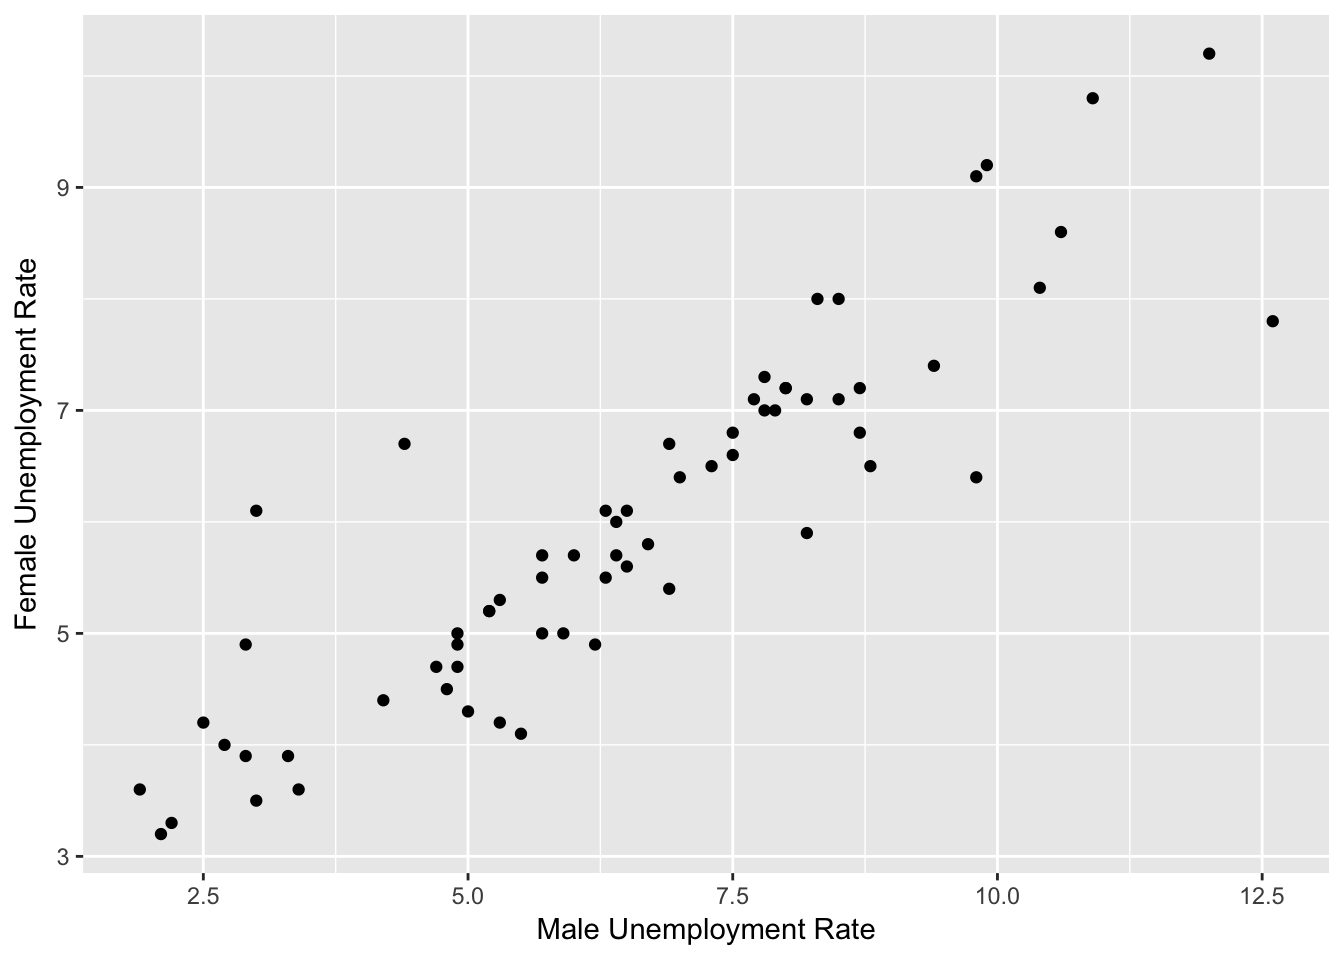
範例:女性失業率模型

  • 訓練 66 列,測試 30 列
R 中的監督式學習:回歸

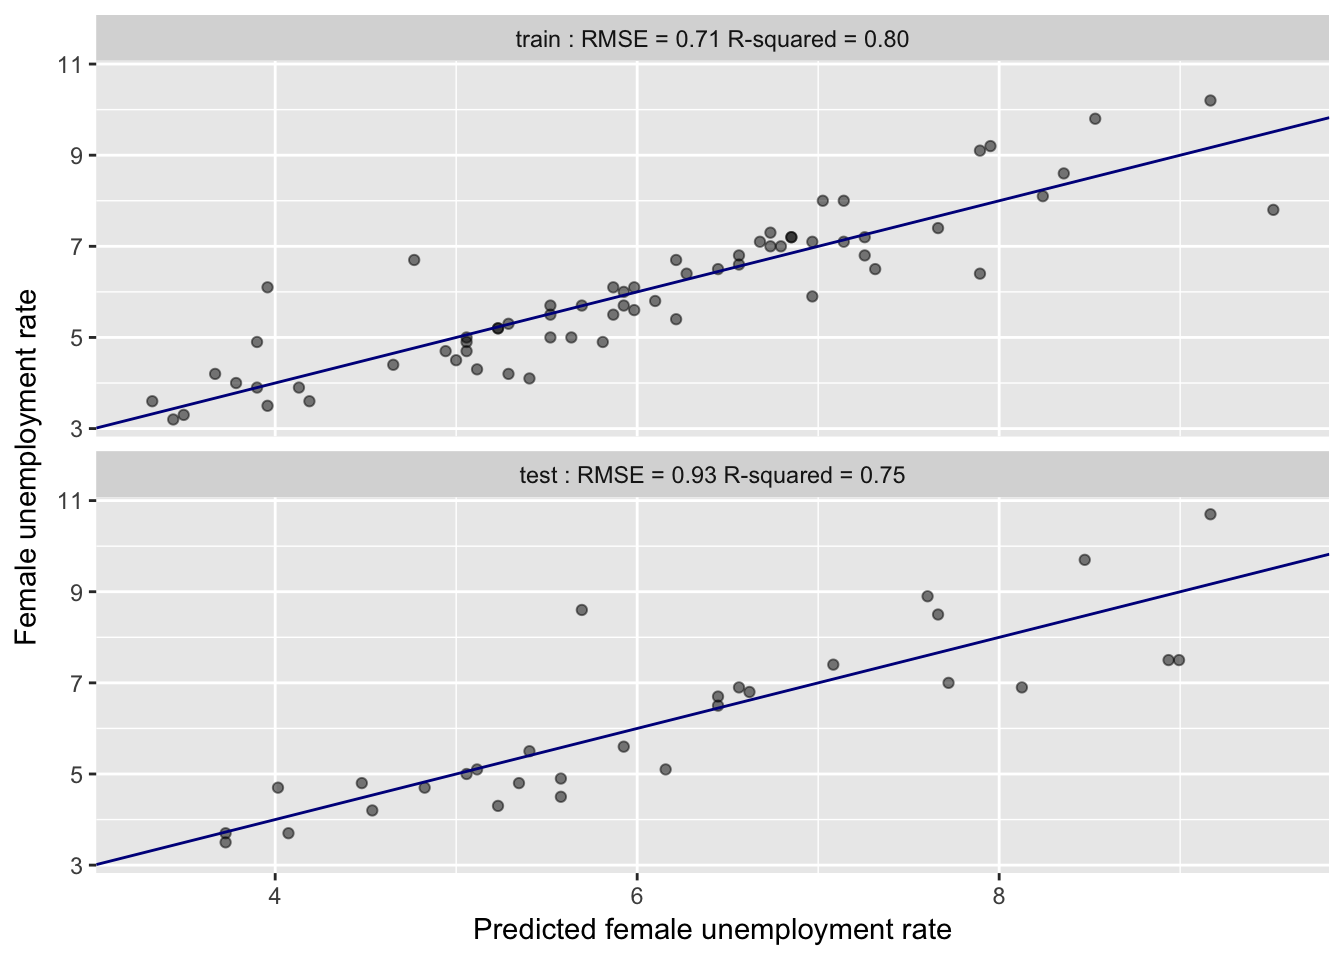
模型表現:訓練 vs. 測試

  • 訓練:RMSE 0.71,$R^2$ 0.8
  • 測試:RMSE 0.93,$R^2$ 0.75
R 中的監督式學習:回歸

交叉驗證

當資料不足以切出測試集時較佳

R 中的監督式學習:回歸

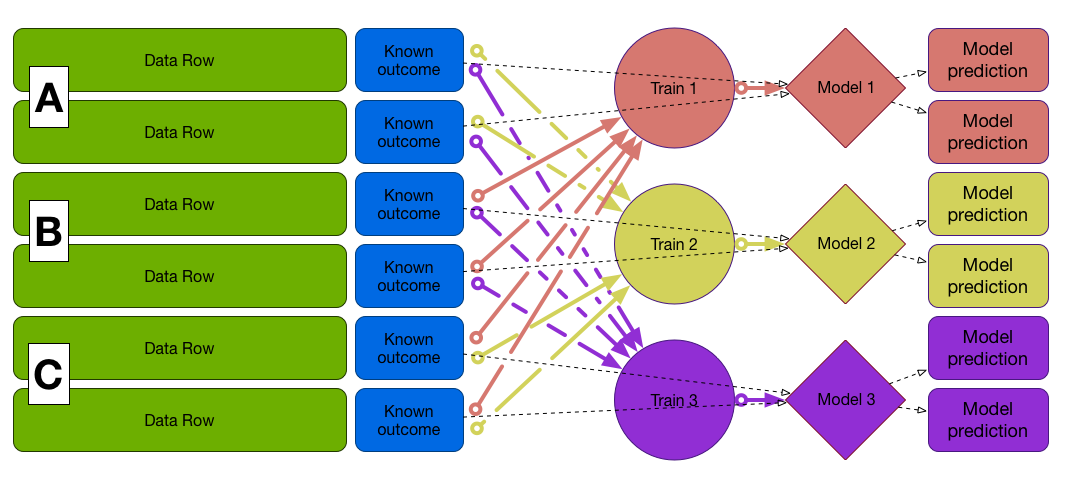
交叉驗證

R 中的監督式學習:回歸

交叉驗證

R 中的監督式學習:回歸

交叉驗證

R 中的監督式學習:回歸

建立交叉驗證規劃

library(vtreat)
splitPlan <- kWayCrossValidation(nRows, nSplits, NULL, NULL)
  • nRows:訓練資料的列數
  • nSplits:交叉驗證的折數(分割數)
    • 例如,nfolds = 3 代表 3 折交叉驗證
  • 其餘 2 個引數此處不需要
R 中的監督式學習:回歸

建立交叉驗證規劃

library(vtreat)
splitPlan <- kWayCrossValidation(10, 3, NULL, NULL)

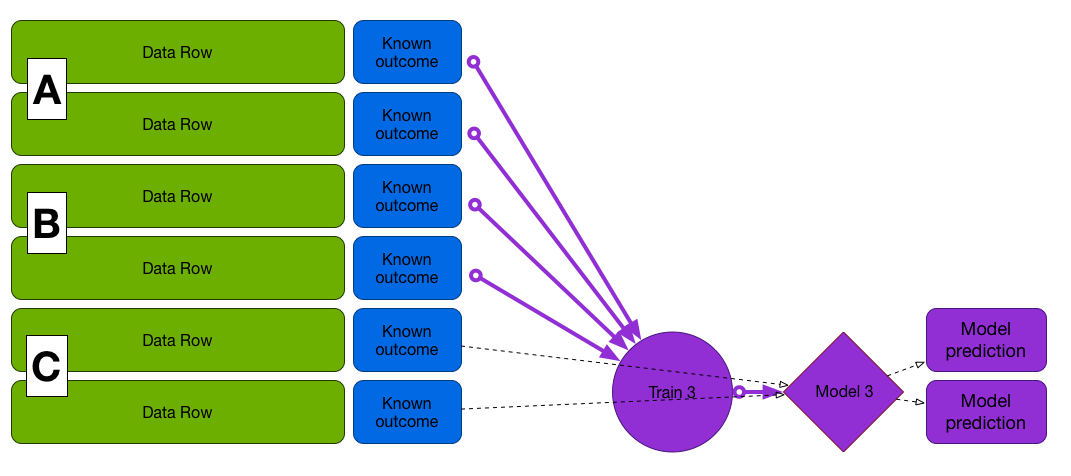
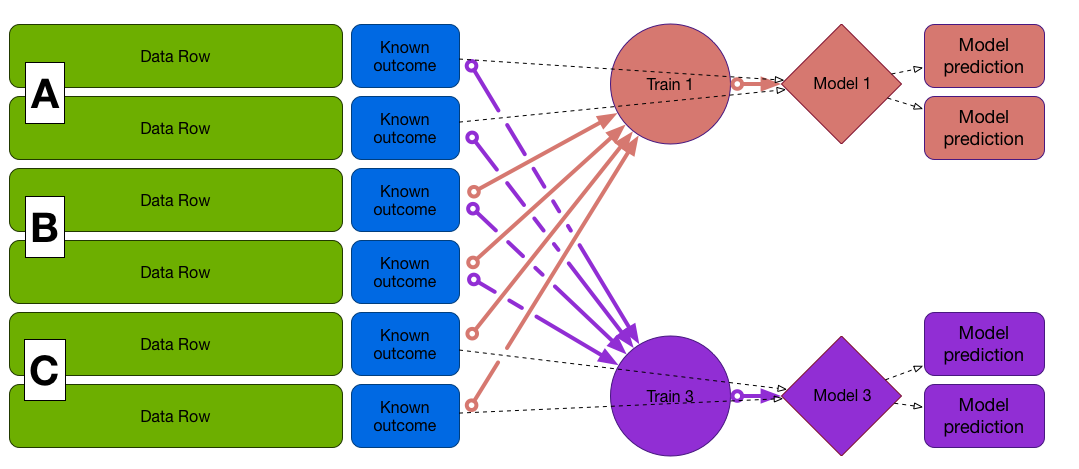
第一折(A 與 B 訓練,C 測試)

splitPlan[[1]]
$train
1  2  4  5  7  9 10
$app
3 6 8

用 A 與 B 訓練,在 C 測試,依此類推…

split <- splitPlan[[1]]
model <- lm(fmla, data = df[split$train,])
df$pred.cv[split$app] <- predict(model, newdata = df[split$app,])
R 中的監督式學習:回歸

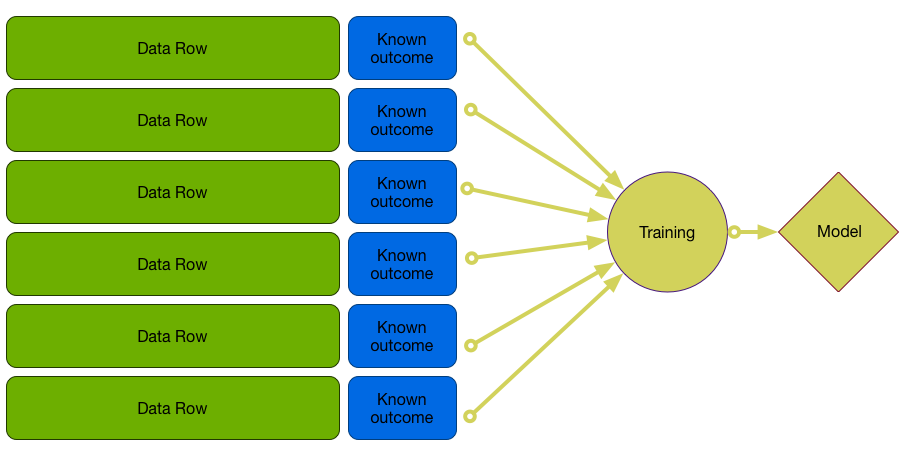
最終模型

R 中的監督式學習:回歸

範例:失業率模型

測度類型 RMSE $R^2$
train 0.7082675 0.8029275
test 0.9349416 0.7451896
cross-validation 0.8175714 0.7635331
R 中的監督式學習:回歸

一起來練習吧!

R 中的監督式學習:回歸

Preparing Video For Download...