R 中的監督式學習:回歸
Nina Zumel and John Mount
Win-Vector, LLC
對常態分佈:
model <- lm(log(y) ~ x, data = train)
logpred <- predict(model, data = test)
pred <- exp(logpred)
$log(a) + log(b) = log(ab)$
$log(a) - log(b) = log(a/b)$
降低乘法誤差會降低相對誤差。
RMS 相對誤差 = $\sqrt{ \overline{ (\frac{pred-y}{y})^2 }}$
modIncome <- lm(Income ~ AFQT + Educ, data = train)
AFQT
Educ
Income
test %>%
+     mutate(pred = predict(modIncome, newdata = test),
+            err = pred - Income) %>%
+     summarize(rmse = sqrt(mean(err^2)),
+               rms.relerr = sqrt(mean((err/Income)^2)))
modLogIncome <- lm(log(Income) ~ AFQT + Educ, data = train)
test %>%
+     mutate(predlog = predict(modLogIncome, newdata = test),
+            pred = exp(predlog),
+            err = pred - Income) %>%
+     summarize(rmse = sqrt(mean(err^2)),
+               rms.relerr = sqrt(mean((err/Income)^2)))
log(Income) 模型:RMS 相對誤差較小,RMSE 較大
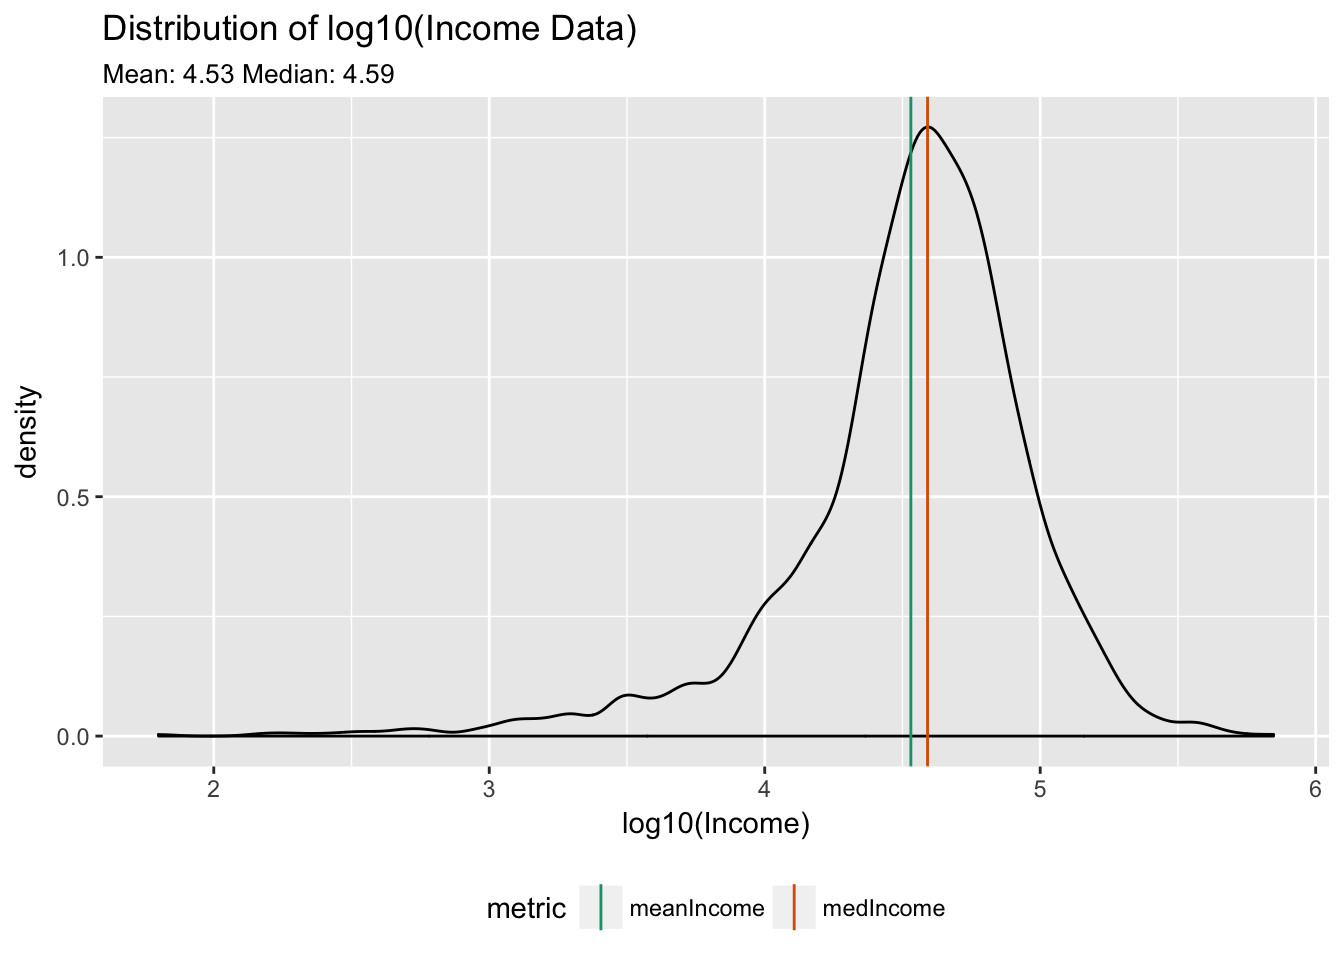
log(Income)