監督式學習的管線
在 Python 設計機器學習工作流程

Dr. Chris Anagnostopoulos
Honorary Associate Professor
有標籤的資料
- 特徵變數(簡寫:
X) - 標籤或類別(簡寫:
y)
credit_scoring.head(4)
  checking_status  duration  ...  foreign_worker class
0            '<0'         6  ...             yes  good
1      '0<=X<200'        48  ...             yes   bad
2   'no checking'        12  ...             yes  good
3            '<0'        42  ...             yes  good
特徵工程
- 多數分類器需要數值特徵
- 需將字串欄位轉成數字
使用 sklearn.preprocessing 的 LabelEncoder 前處理:
le = LabelEncoder()
le.fit_transform(credit_scoring['checking_status'])[:4]
array([1, 0, 3, 1])
模型擬合
.fit(features, labels).predict(features)
features, labels = credit_scoring.drop('class', 1), credit_scoring['class']model_nb = GaussianNB() model_nb.fit(features, labels) model_nb.predict(features.head(5))
['good' 'bad' 'good' 'bad' 'good']
前 5 筆樣本的準確率為 60%。
模型選擇
.fit()會最佳化該模型的參數- 其他模型呢?
AdaBoostClassifier 在前 5 筆資料上勝過 GaussianNB:
model_ab = AdaBoostClassifier()
model_ab.fit(features, labels)
model_ab.predict(features.head(5))
numpy.array(labels[0:5])
['good' 'bad' 'good' 'good' 'bad']
['good' 'bad' 'good' 'good' 'bad']
效能評估
樣本越大,$\Rightarrow$ 準確率估計越可靠:
from sklearn.metrics import accuracy_score
accuracy_score(labels, model_nb.predict(features)) # naive bayes
0.706
accuracy_score(labels, model_ab.predict(features)) # adaboost
0.802
這樣算哪裡不對?
過度擬合與資料切分
過度擬合(Overfitting):模型在訓練資料上一定比在未看過的資料上表現更好。
用 X_train, y_train 訓練,用 X_test, y_test 評估準確率:
from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)GaussianNB().fit(X_train, y_train).predict(X_test)
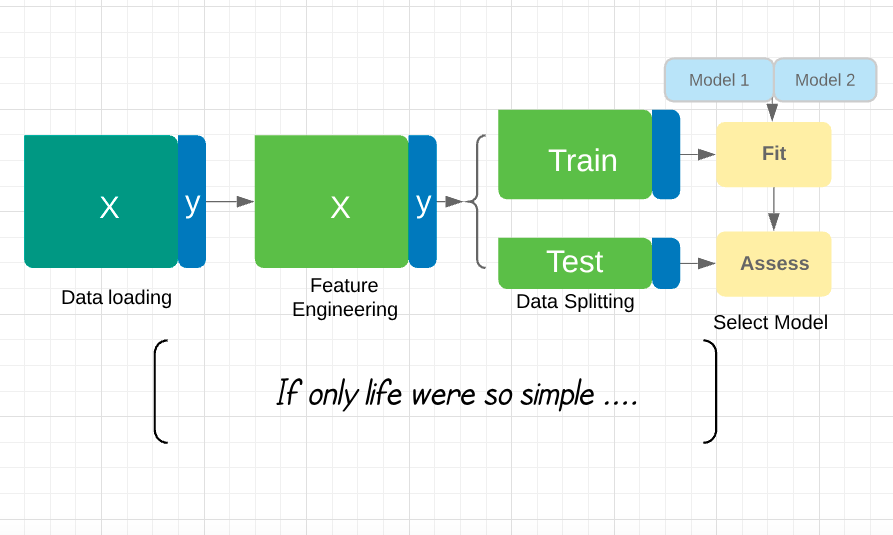
本課會學到什麼?
- 可擴充的管線調參方法。
- 結合領域專家,確保預測具備實務意義。
- 確保模型隨時間持續表現良好。
- 當標籤不足時如何擬合模型。
你能避免房貸風暴嗎?
在 Python 設計機器學習工作流程

