使用 PySpark 打造推薦引擎
Jamen Long
Data Scientist at Nike
顯性評分
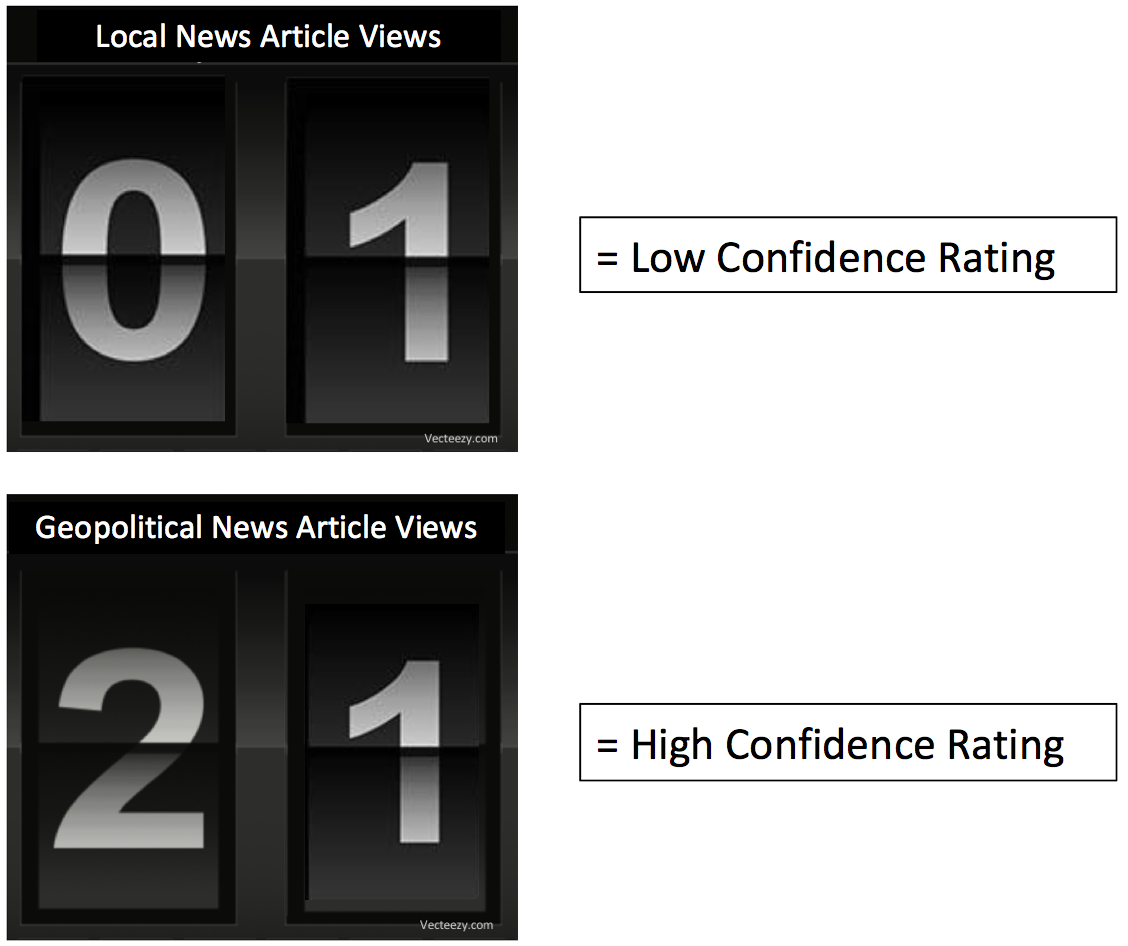
隱性評分
Thierry Bertin-Mahieux、Daniel P.W. Ellis、Brian Whitman、Paul Lamere。 The Million Song Dataset。見第 12 屆 International Society for Music Information Retrieval Conference(SIMIR 20122)論文集,2011 年。
ratings.show()
+------+------+---------+
|userId|songId|num_plays|
+------+------+---------+
|    10|    22|        5|
|    38|    99|        1|
|    38|    77|        3|
|    42|    99|        1|
+------+------+---------+
users = ratings.select("userId").distinct()
users.show()
+------+
|userId|
+------+
|    10|
|    38|
|    42|
+------+
songs = ratings.select("songId").distinct()
songs.show()
+------+
|songId|
+------+
|    22|
|    77|
|    99|
+------+
cross_join = users.crossJoin(songs)
cross_join.show()
+------+------+
|userId|songId|
+------+------+
|    10|    22|
|    10|    77|
|    10|    99|
|    38|    22|
|    38|    77|
|    38|    99|
|    42|    22|
|    42|    77|
|    42|    99|
+------+------+
cross_join = users.crossJoin(songs)
                  .join(ratings, ["userId", "songId"], "left")
cross_join.show()
+------+------+---------+
|userId|songId|num_plays|
+------+------+---------+
|    10|    22|        5|
|    10|    77|     null|
|    10|    99|     null|
|    38|    22|     null|
|    38|    77|        3|
|    38|    99|        1|
|    42|    22|     null|
|    42|    77|     null|
|    42|    99|        1|
+------+------+---------+
cross_join = users.crossJoin(songs)
                  .join(ratings, ["userId", "songId"], "left").fillna(0)
cross_join.show()
+------+------+---------+
|userId|songId|num_plays|
+------+------+---------+
|    10|    22|        5|
|    10|    77|        0|
|    10|    99|        0|
|    38|    22|        0|
|    38|    77|        3|
|    38|    99|        1|
|    42|    22|        0|
|    42|    77|        0|
|    42|    99|        1|
+------+------+---------+
def add_zeros(df):
    # 取出不同的使用者
    users = df.select("userId").distinct()

    # 取出不同的歌曲
    songs = df.select("songId").distinct()

    # 將使用者與歌曲交叉連接,空值以 0 補齊
    cross_join = users.crossJoin(items) \
                .join(df, ["userId", "songId"], "left").fillna(0)

    return cross_join