MovieLens 資料集簡介
使用 PySpark 打造推薦引擎

Jamen Long
Data Scientist at Nike
MovieLens 資料集
F. Maxwell Harper 與 Joseph A. Konstan。2015
The MovieLens Datasets: History and Context。
ACM Transitions on Interactive Intelligent Systems (TiiS) 5, 4, Article 19(2015 年 12 月),19 頁。
DOI=http://dx.doi.org/10.1145/2827872
MovieLens 摘要統計
F. Maxwell Harper 與 Joseph A. Konstan。2015
The MovieLens Datasets: History and Context。
ACM Transitions on Interactive Intelligent Systems (TiiS) 5, 4, Article 19(2015 年 12 月),19 頁。
DOI=http://dx.doi.org/10.1145/2827872
評分: 20,000,000+
使用者: 138,493
電影: 27,278
探索資料
df.show()
df.columns()
MovieLens 稀疏性
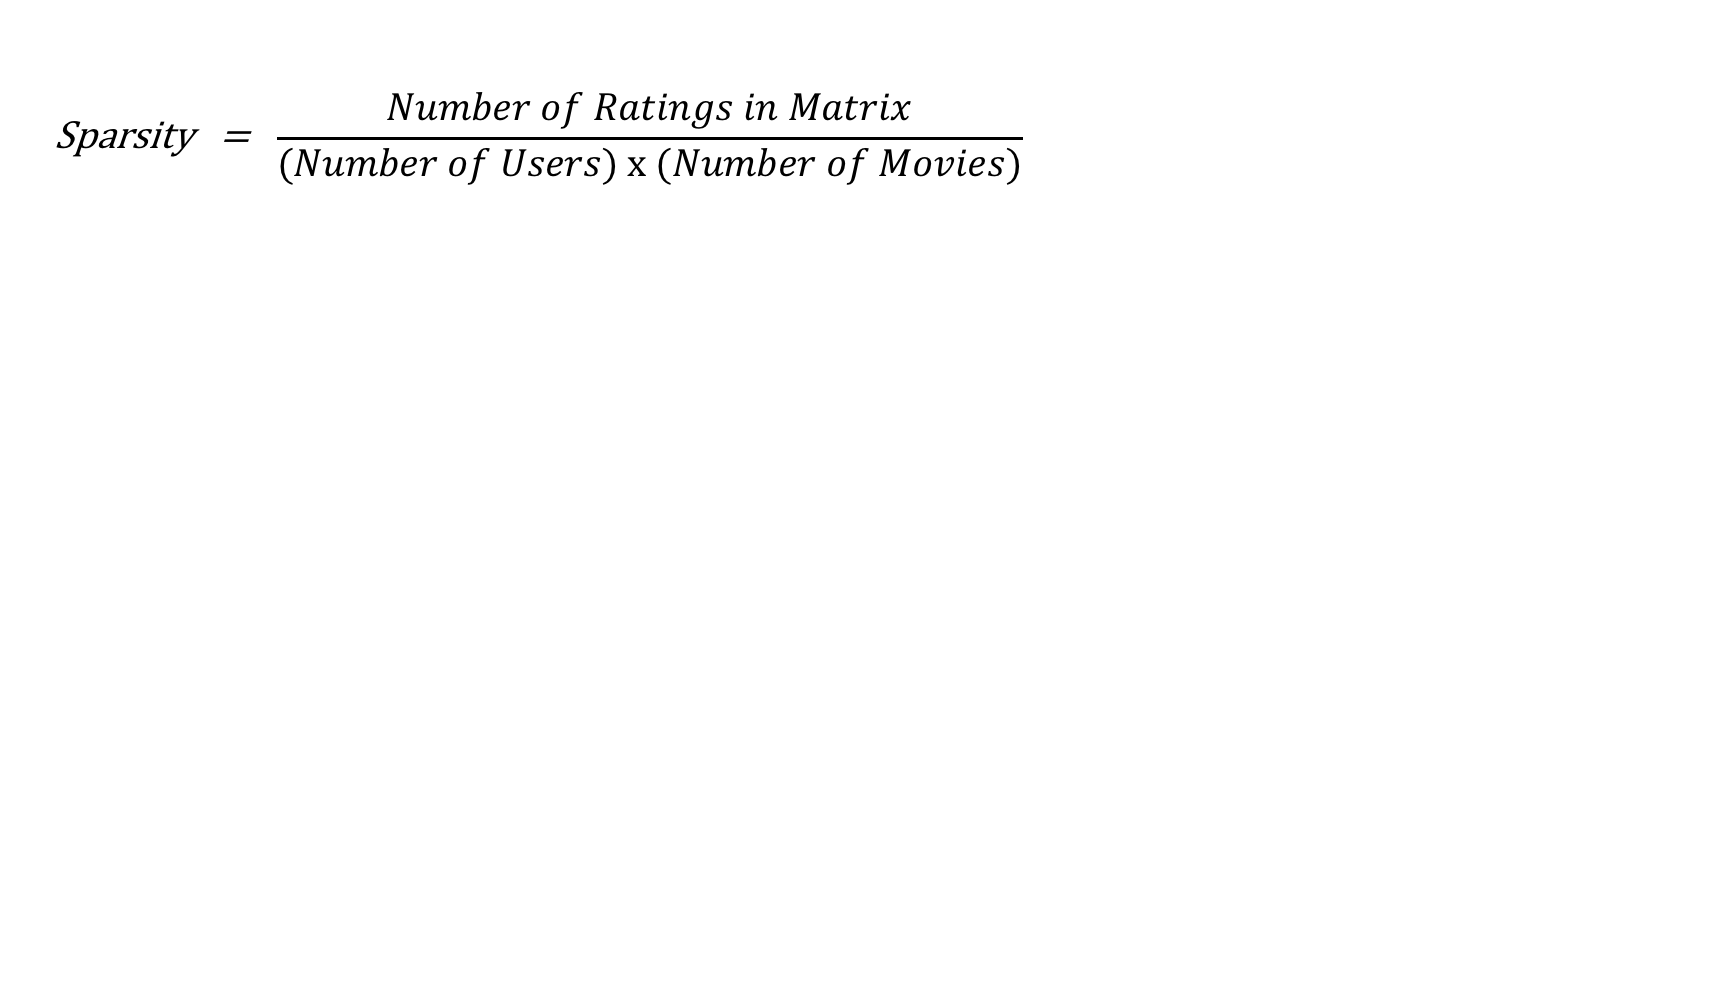
稀疏性:分子
# 矩陣中的評分數量
numerator = ratings.count()
稀疏性:使用者與電影
# 不重複的使用者與電影
users = ratings.select("userId").distinct().count()
movies = ratings.select("movieId").distinct().count()
稀疏性:分母
# 矩陣中的評分數量 numerator = ratings.count() # 不重複的使用者與電影 users = ratings.select("userId").distinct().count() movies = ratings.select("movieId").distinct().count()# 若無空白儲存格,矩陣可容納的評分數 denominator = users * movies
稀疏性
# 矩陣中的評分數量
numerator = ratings.count()

# 不重複的使用者與電影
users = ratings.select("userId").distinct().count()
movies = ratings.select("movieId").distinct().count()

# 若無空白儲存格,矩陣可容納的評分數
denominator = users * movies
# 計算稀疏性
sparsity = 1 - (numerator*1.0 / denominator)
print ("Sparsity: "), sparsity
Sparsity: .998
`.distinct()` 方法
ratings.select("userId").distinct().count()
671
GroupBy 方法
# 依 userId 分組
ratings.groupBy("userId")
GroupBy 方法
# 每位使用者的歌曲播放次數
ratings.groupBy("userId").count().show()
+------+-----+
|userId|count|
+------+-----+
|   148|   76|
|   243|   12|
|    31|  232|
|   137|   16|
|   251|   19|
|    85|  752|
|    65|  737|
|   255|    9|
|    53|  190|
|   133|  302|
|   296|   74|
|    78|  301|
|   108|  136|
|   155|    3|
|   193|  174|
|   101|    1|
+------+-----+
GroupBy 方法:min
from pyspark.sql.functions import min, max, avg

# 每位使用者的歌曲播放次數最小值
msd.groupBy("userId").count()
              .select(min("count")).show()
+----------+
|min(count)|
+----------+
|         1|
+----------+
GroupBy 方法:max
# 每位使用者的歌曲播放次數最大值
ratings.groupBy("userId").count()
              .select(max("count")).show()
+----------+
|max(count)|
+----------+
|      1162|
+----------+
GroupBy 方法:avg
# 每位使用者的歌曲播放次數平均值
ratings.groupBy("userId").count()
              .select(avg("count")).show()
+----------+
|avg(count)|
+----------+
| 233.34579|
+----------+
Filter 方法
# 移除少於 20 筆評分的使用者
ratings.groupBy("userId").count().filter(col("count") >= 20).show()
+------+-----+
|userId|count|
+------+-----+
|   148|   76|
|    31|  232|
|    85|  752|
|    65|  737|
|    53|  190|
|   133|  302|
|   296|   74|
|    78|  301|
|   108|  136|
|   193|  174|
+------+-----+
一起來練習吧!
使用 PySpark 打造推薦引擎

