衡量交叉驗證的效能

Tidyverse 的 Machine Learning

Dmitriy (Dima) Gorenshteyn

Lead Data Scientist, Memorial Sloan Kettering Cancer Center

效能衡量
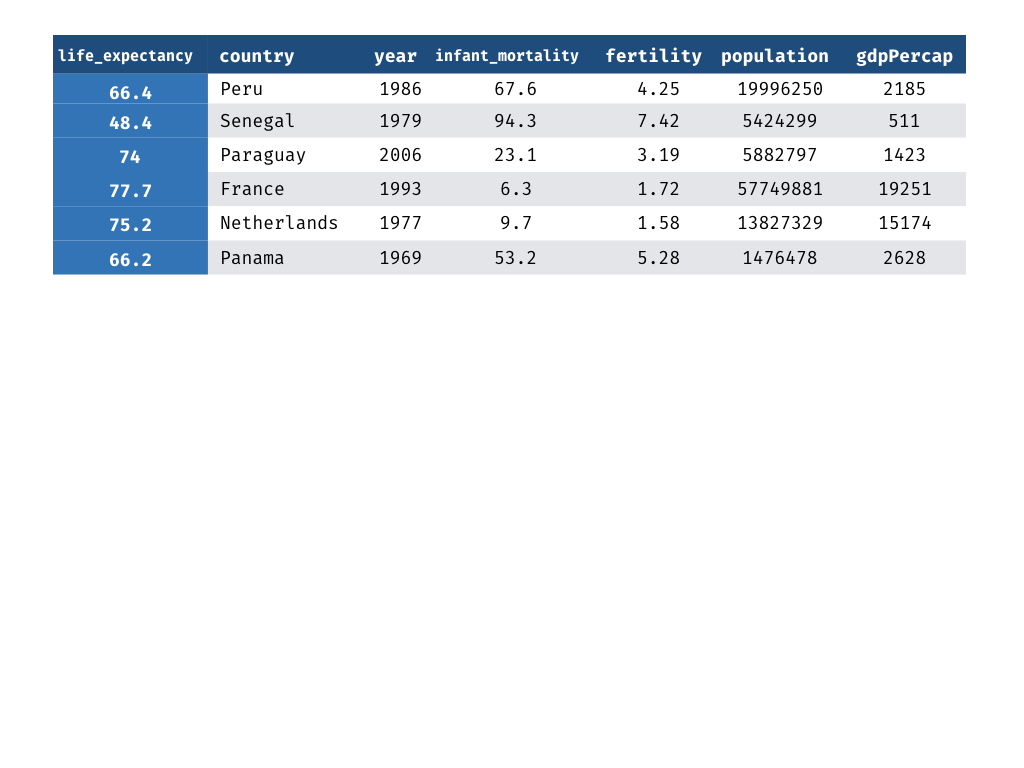
Tidyverse 的 Machine Learning

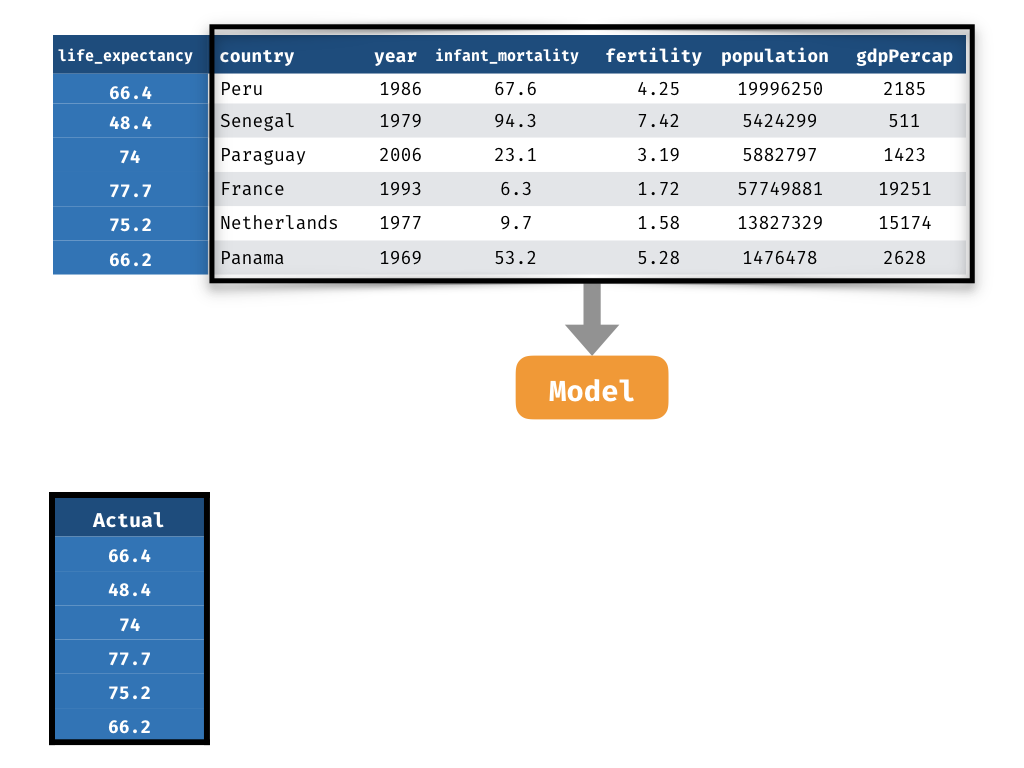
效能衡量-真值

Tidyverse 的 Machine Learning

效能衡量-真值

Tidyverse 的 Machine Learning

效能衡量-真值

Tidyverse 的 Machine Learning

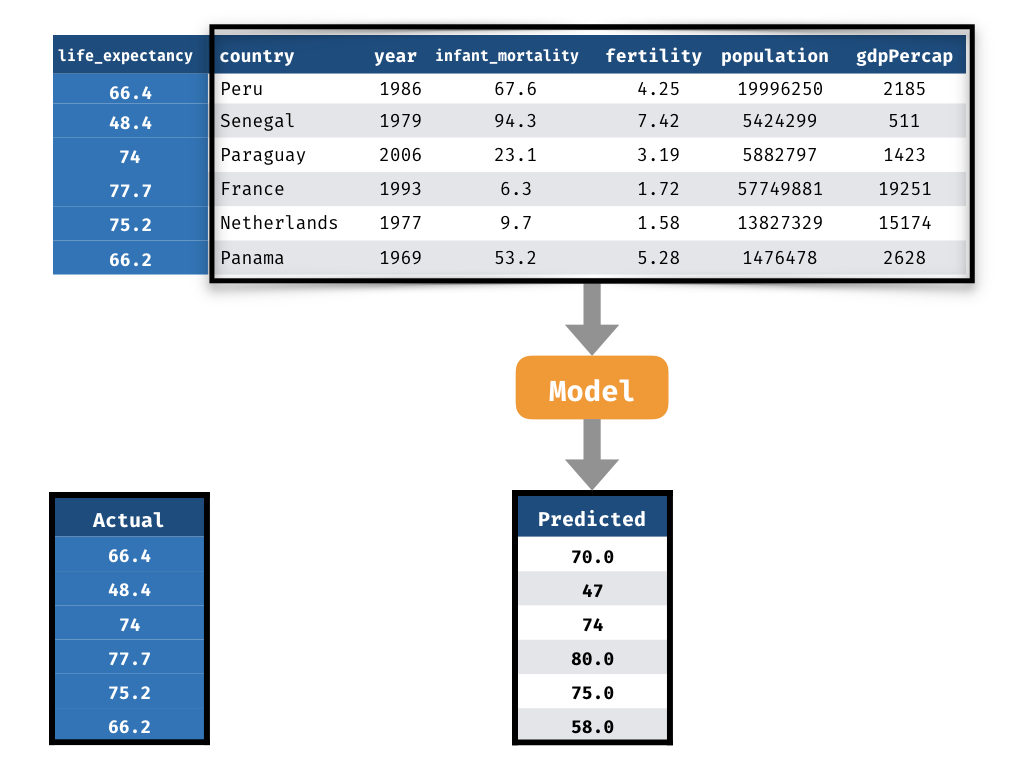
效能衡量-預測

Tidyverse 的 Machine Learning

效能衡量-預測

Tidyverse 的 Machine Learning

效能衡量-預測

Tidyverse 的 Machine Learning

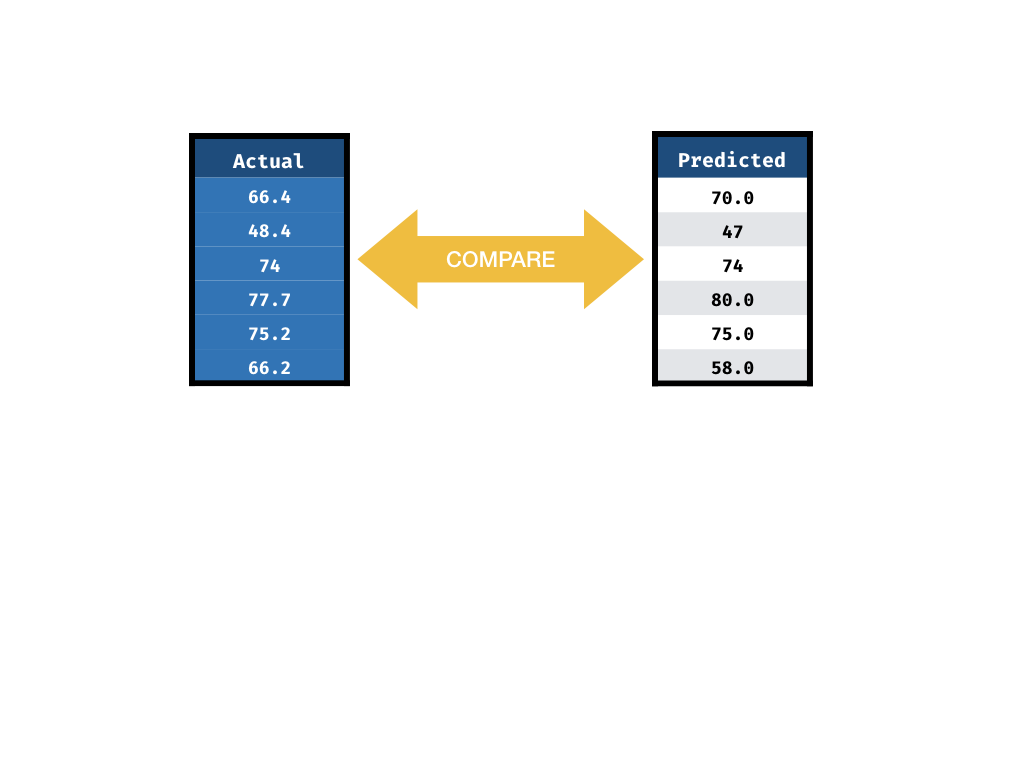
效能衡量

Tidyverse 的 Machine Learning

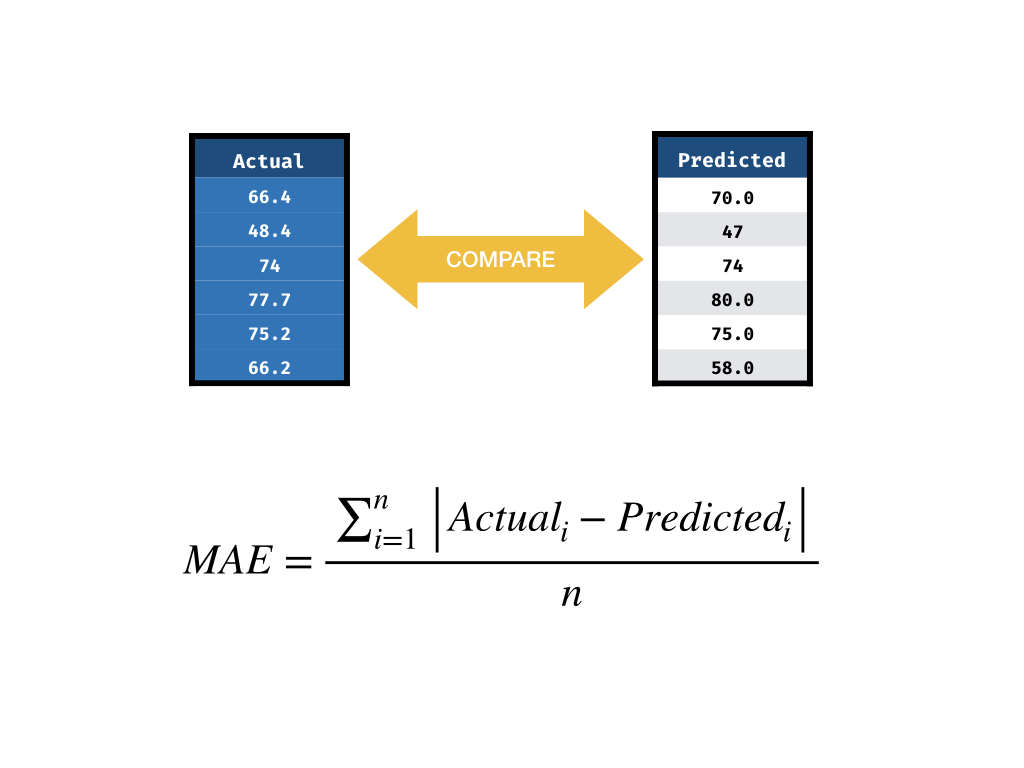
平均絕對誤差

Tidyverse 的 Machine Learning

效能衡量的要素

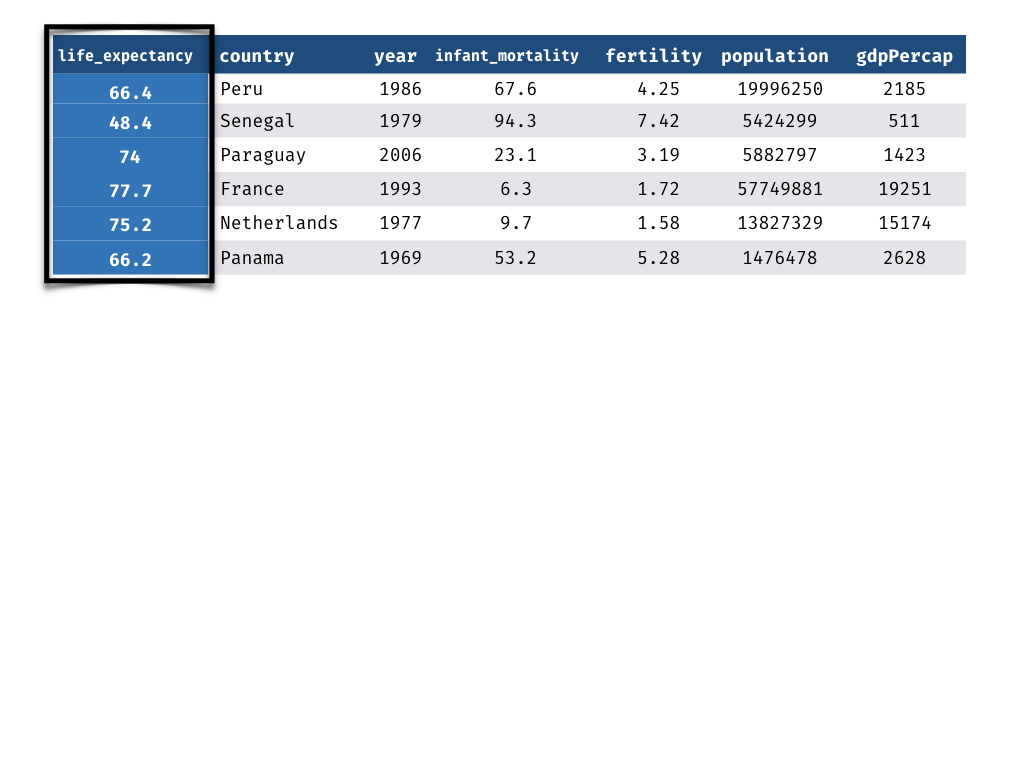
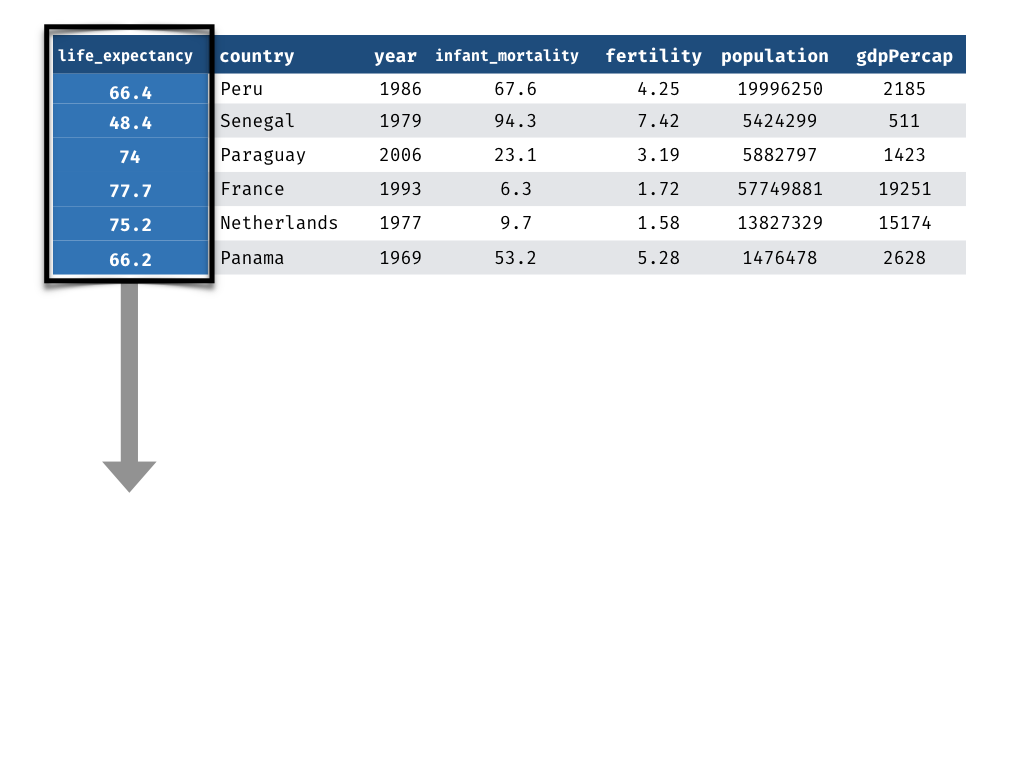
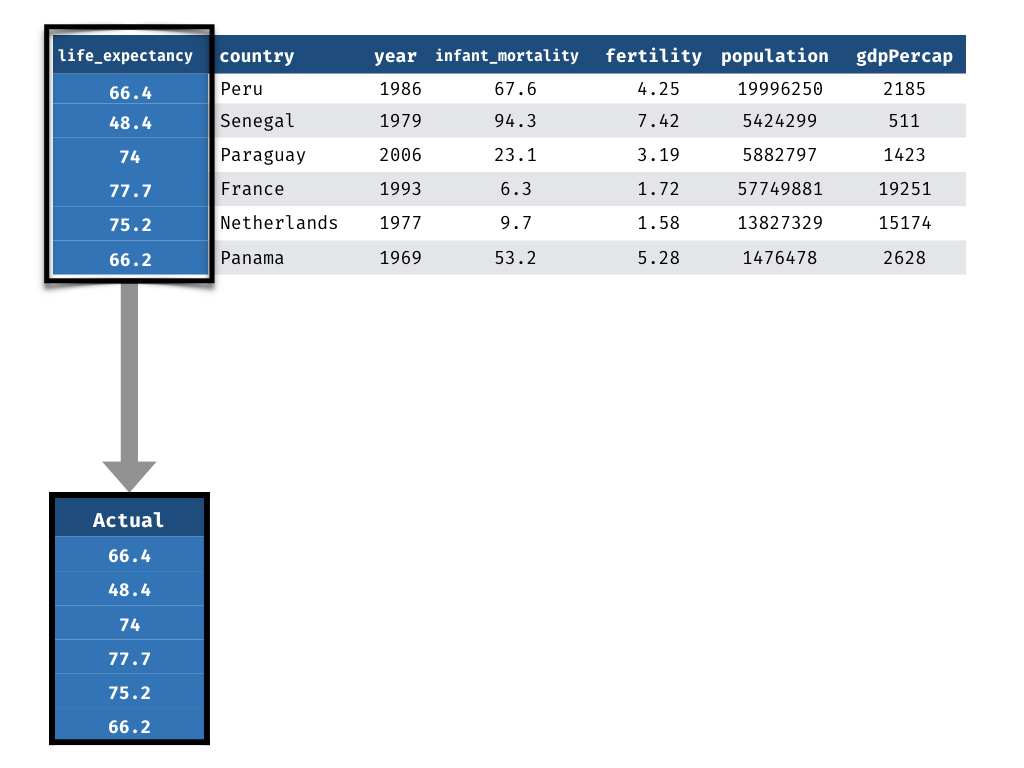
1) 真實的 life_expectancy
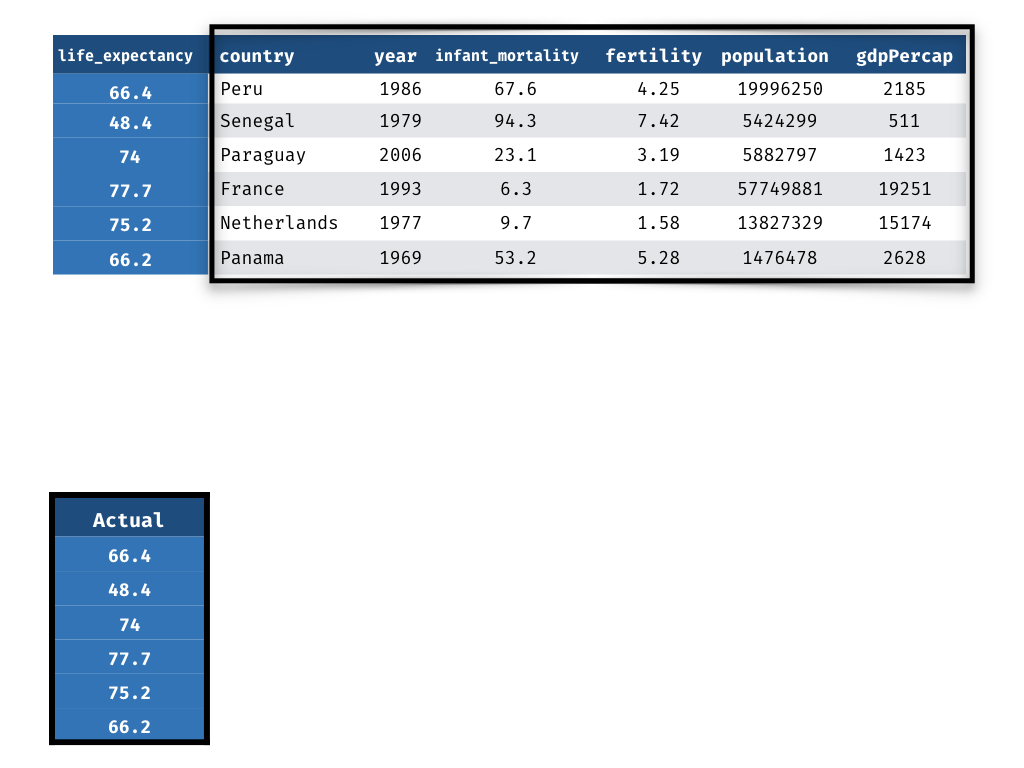
2) 預測的 life_expectancy
3) 用來比較 1) 與 2) 的指標

Tidyverse 的 Machine Learning

1) 取出真實值

cv_prep_lm <- cv_models_lm %>% 
  mutate(validate_actual = map(validate, ~.x$life_expectancy))
Tidyverse 的 Machine Learning

`predict()` 與 `map2()` 函式

predict(model, data)
map2(.x = model, .y = data, .f = ~predict(.x, .y))
Tidyverse 的 Machine Learning

2) 準備預測值

cv_prep_lm <- cv_eval_lm %>% 
  mutate(validate_actual = map(validate, ~.x$life_expectancy),
         validate_predicted = map2(model, validate, ~predict(.x, .y)))
Tidyverse 的 Machine Learning

3) 計算 MAE

library(Metrics)
cv_eval_lm <- cv_prep_lm %>% 
  mutate(validate_mae = map2_dbl(validate_actual, validate_predicted, 
                                ~mae(actual = .x, predicted = .y)))

cv_eval_lm
#  5-fold cross-validation 
# A tibble: 5 x 8
splits       id    train validate model validate_a. validate_p validate_mae
<S3: rsplit> Fold1 <tib. <tib.   <S3.   <dbl.       <dbl.       1.47
<S3: rsplit> Fold2 <tib. <tib.   <S3.   <dbl.       <dbl.       1.51
<S3: rsplit> Fold3 <tib. <tib.   <S3.   <dbl.       <dbl.       1.44
<S3: rsplit> Fold4 <tib. <tib.   <S3.   <dbl.       <dbl.       1.48
<S3: rsplit> Fold5 <tib. <tib.   <S3.   <dbl.       <dbl.       1.68
Tidyverse 的 Machine Learning

一起來練習吧!

Tidyverse 的 Machine Learning

Preparing Video For Download...