R 的網頁爬蟲
Timo Grossenbacher
Instructor
//div/p[@class = "blue"]
div > p.blue
class
special
a
div
html %>%
    html_elements(xpath = '//p')
# CSS selector equivalent: p
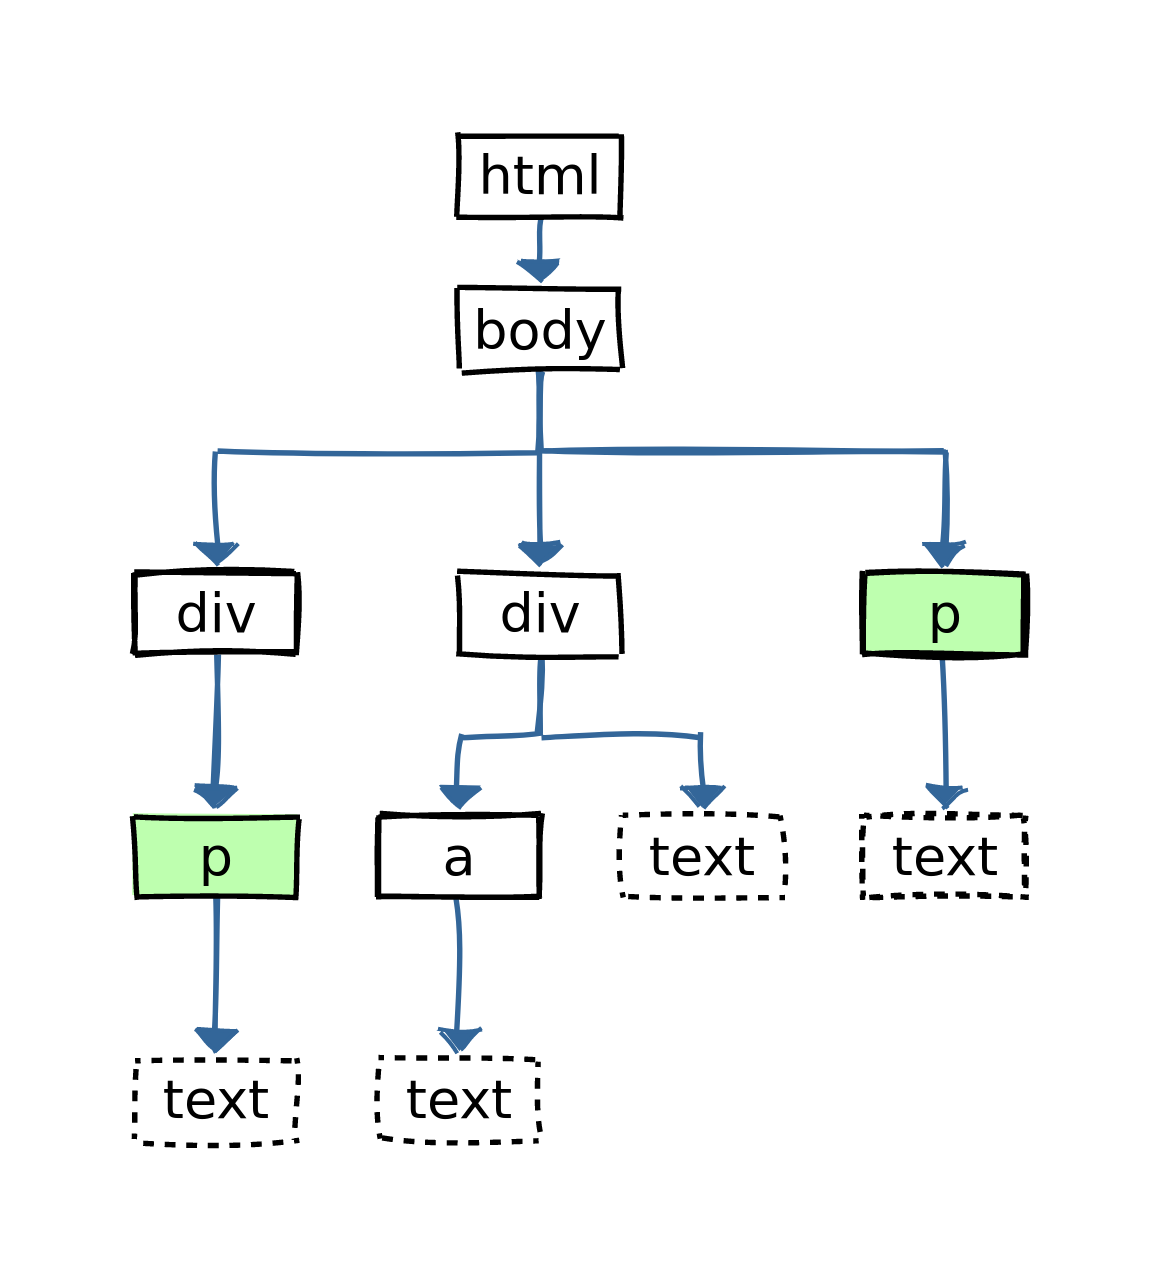
html %>%
    html_elements(xpath = '//body//p')
# CSS selector equivalent: body p
html %>%
    html_elements(xpath = '/html/body//p')
# CSS selector equivalent: html > body p
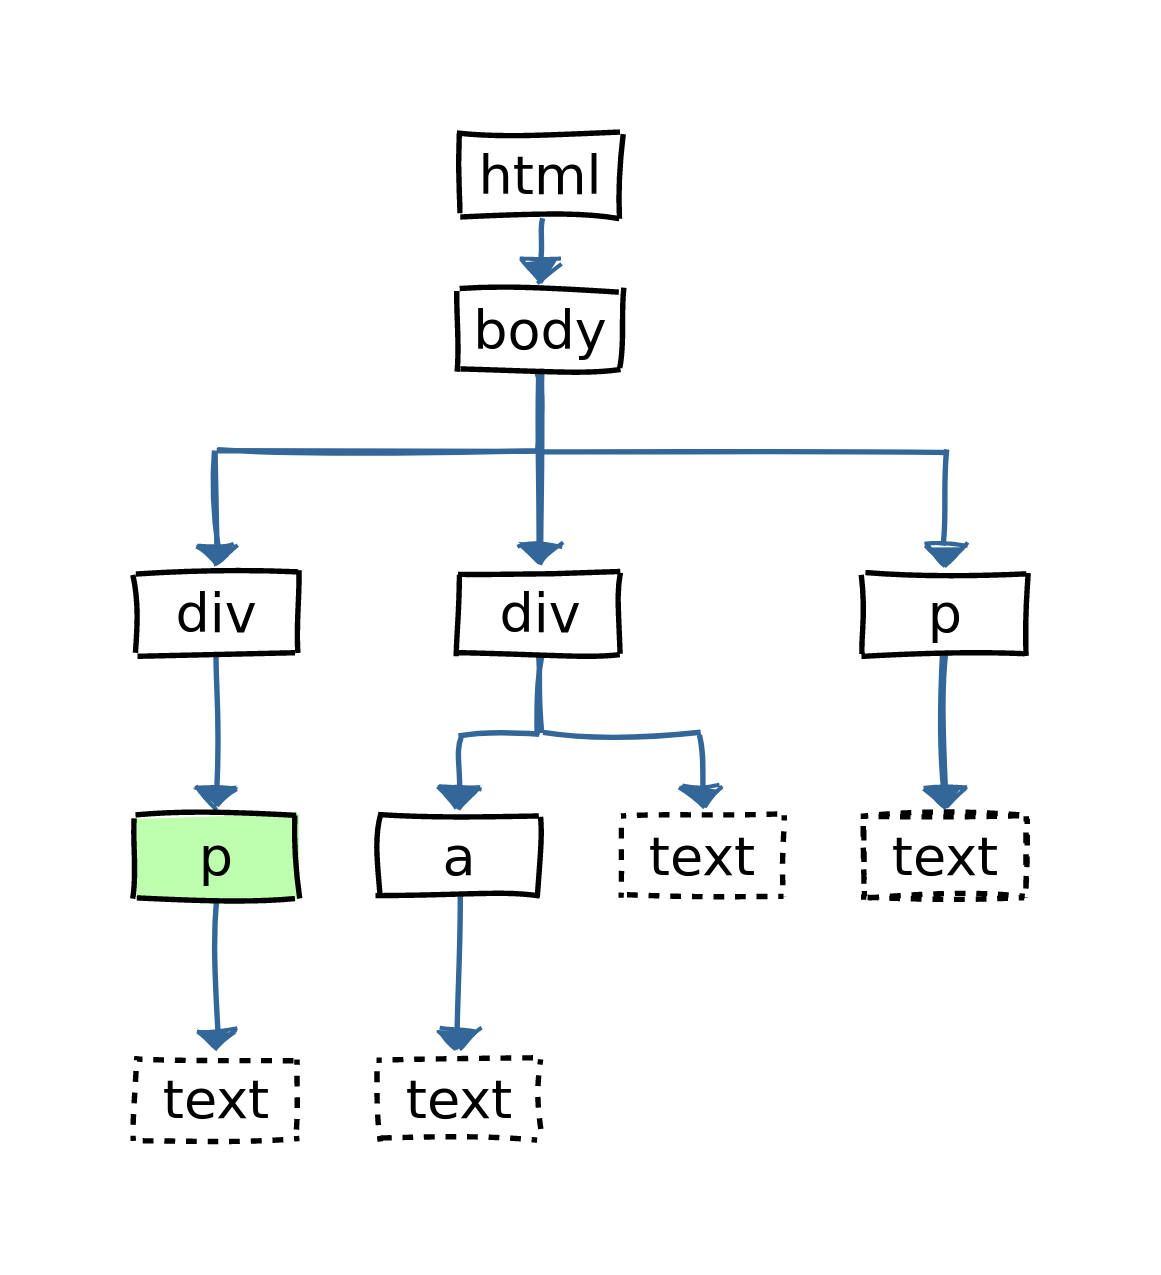
html %>%
    html_elements(xpath = '//div/p')
# CSS selector equivalent: div > p
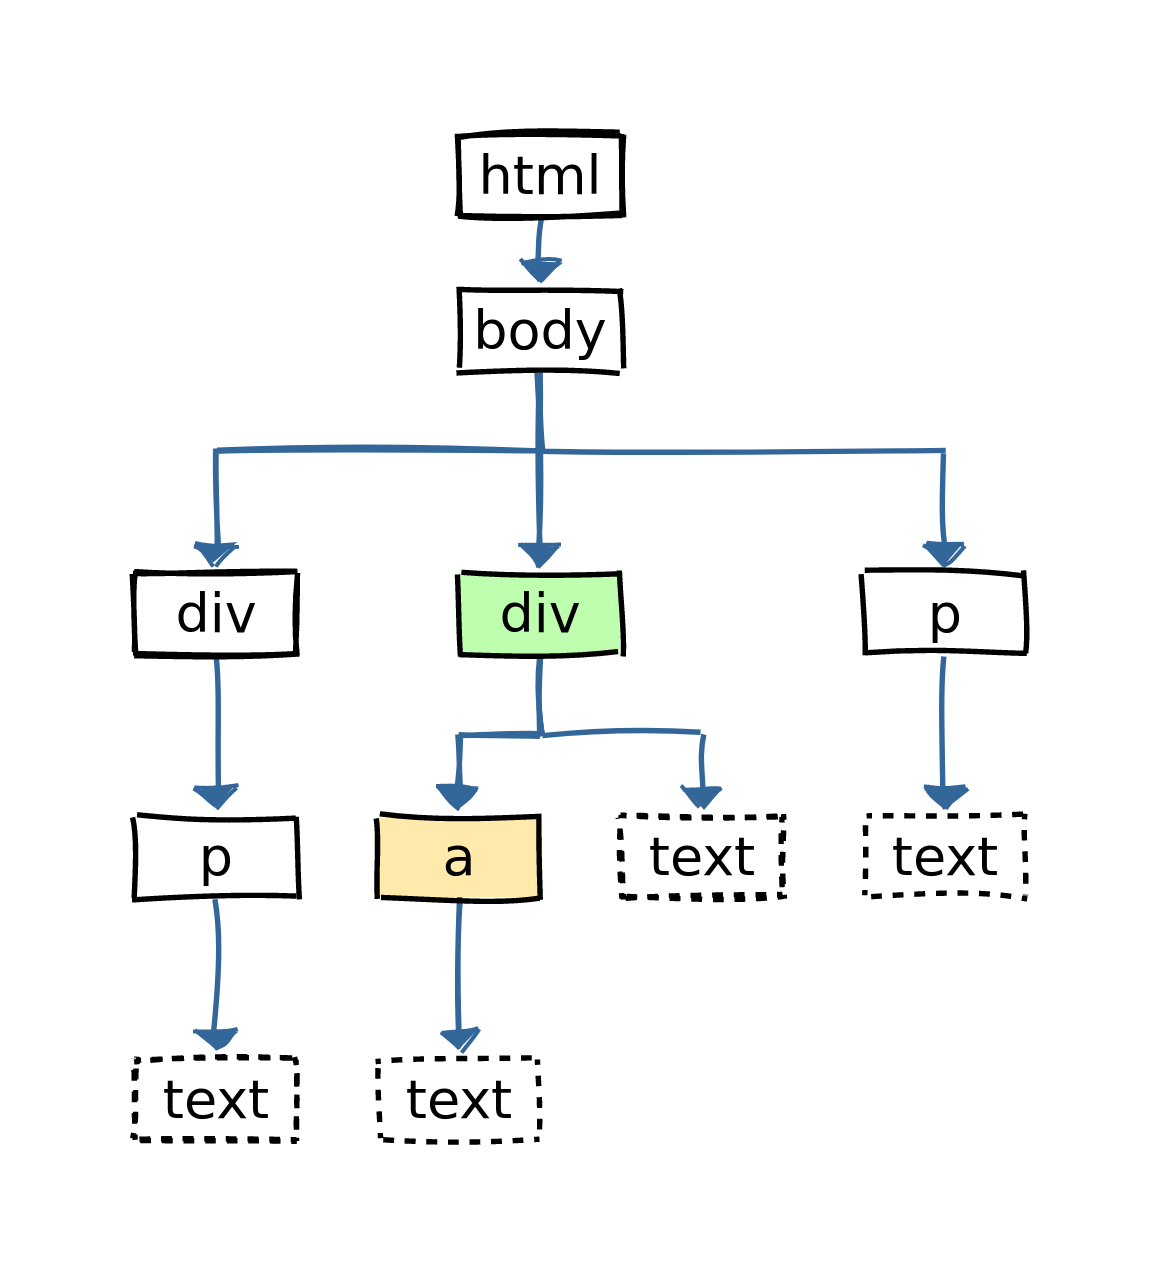
html %>%
    html_elements(xpath = '//div[a]')
# CSS selector equivalent: none
/
//
span
[...]
//span/a[@class = "external"]
span > a.external
//*[@id = "special"]//div
#special div
*#special div