使用 8-bit Adam 的混合精度訓練

使用 PyTorch 高效訓練 AI 模型

Dennis Lee

Data Engineer, Amazon

提升訓練效率的最佳化器
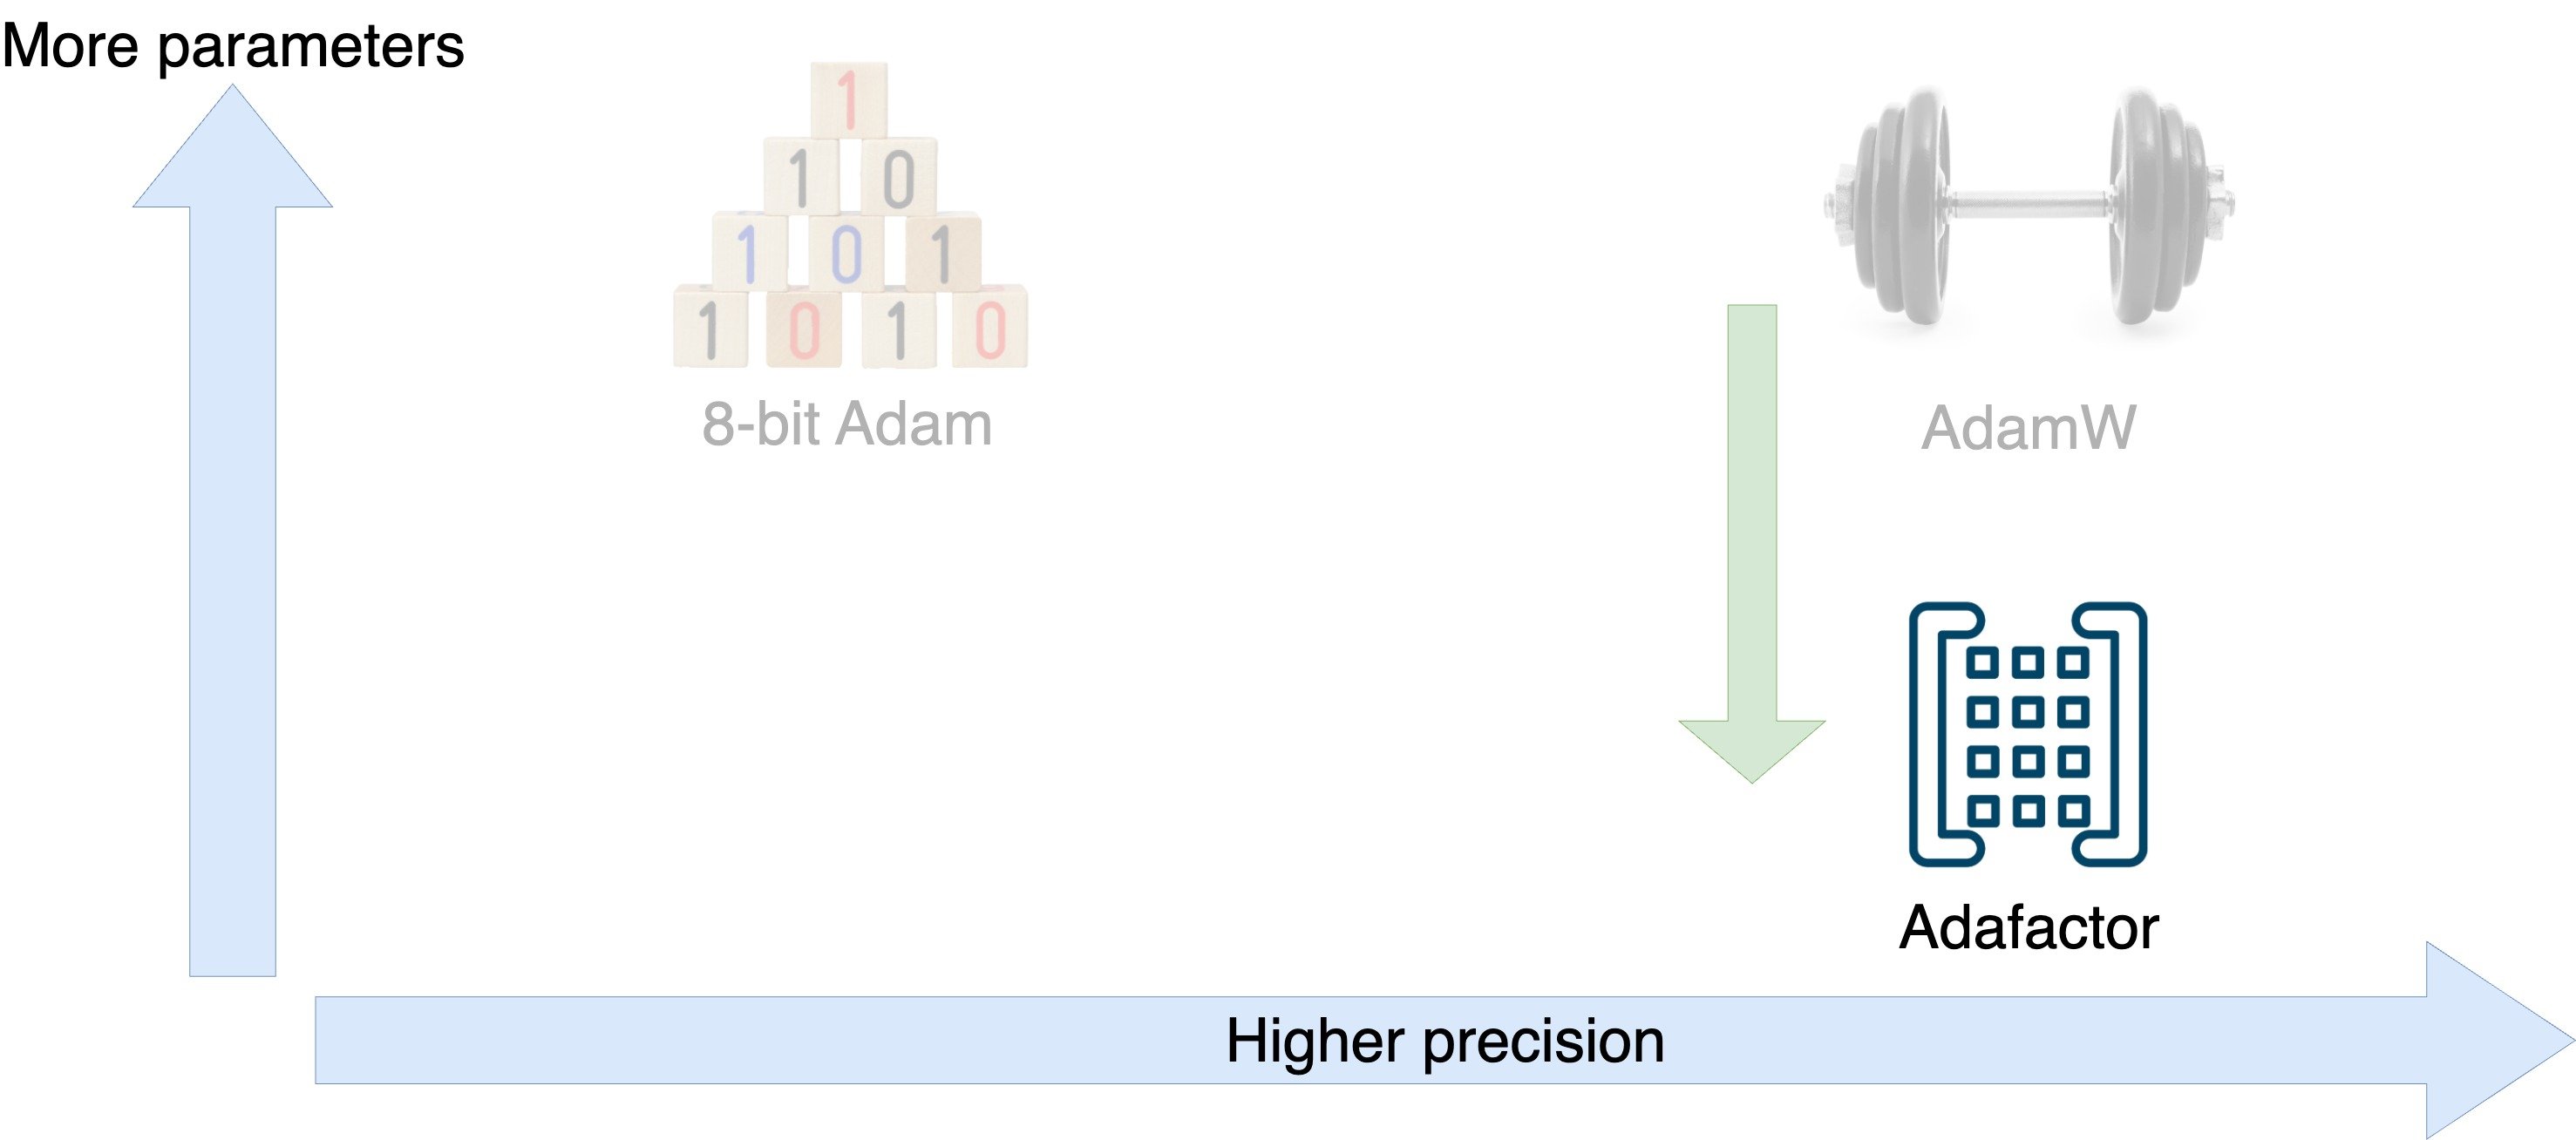
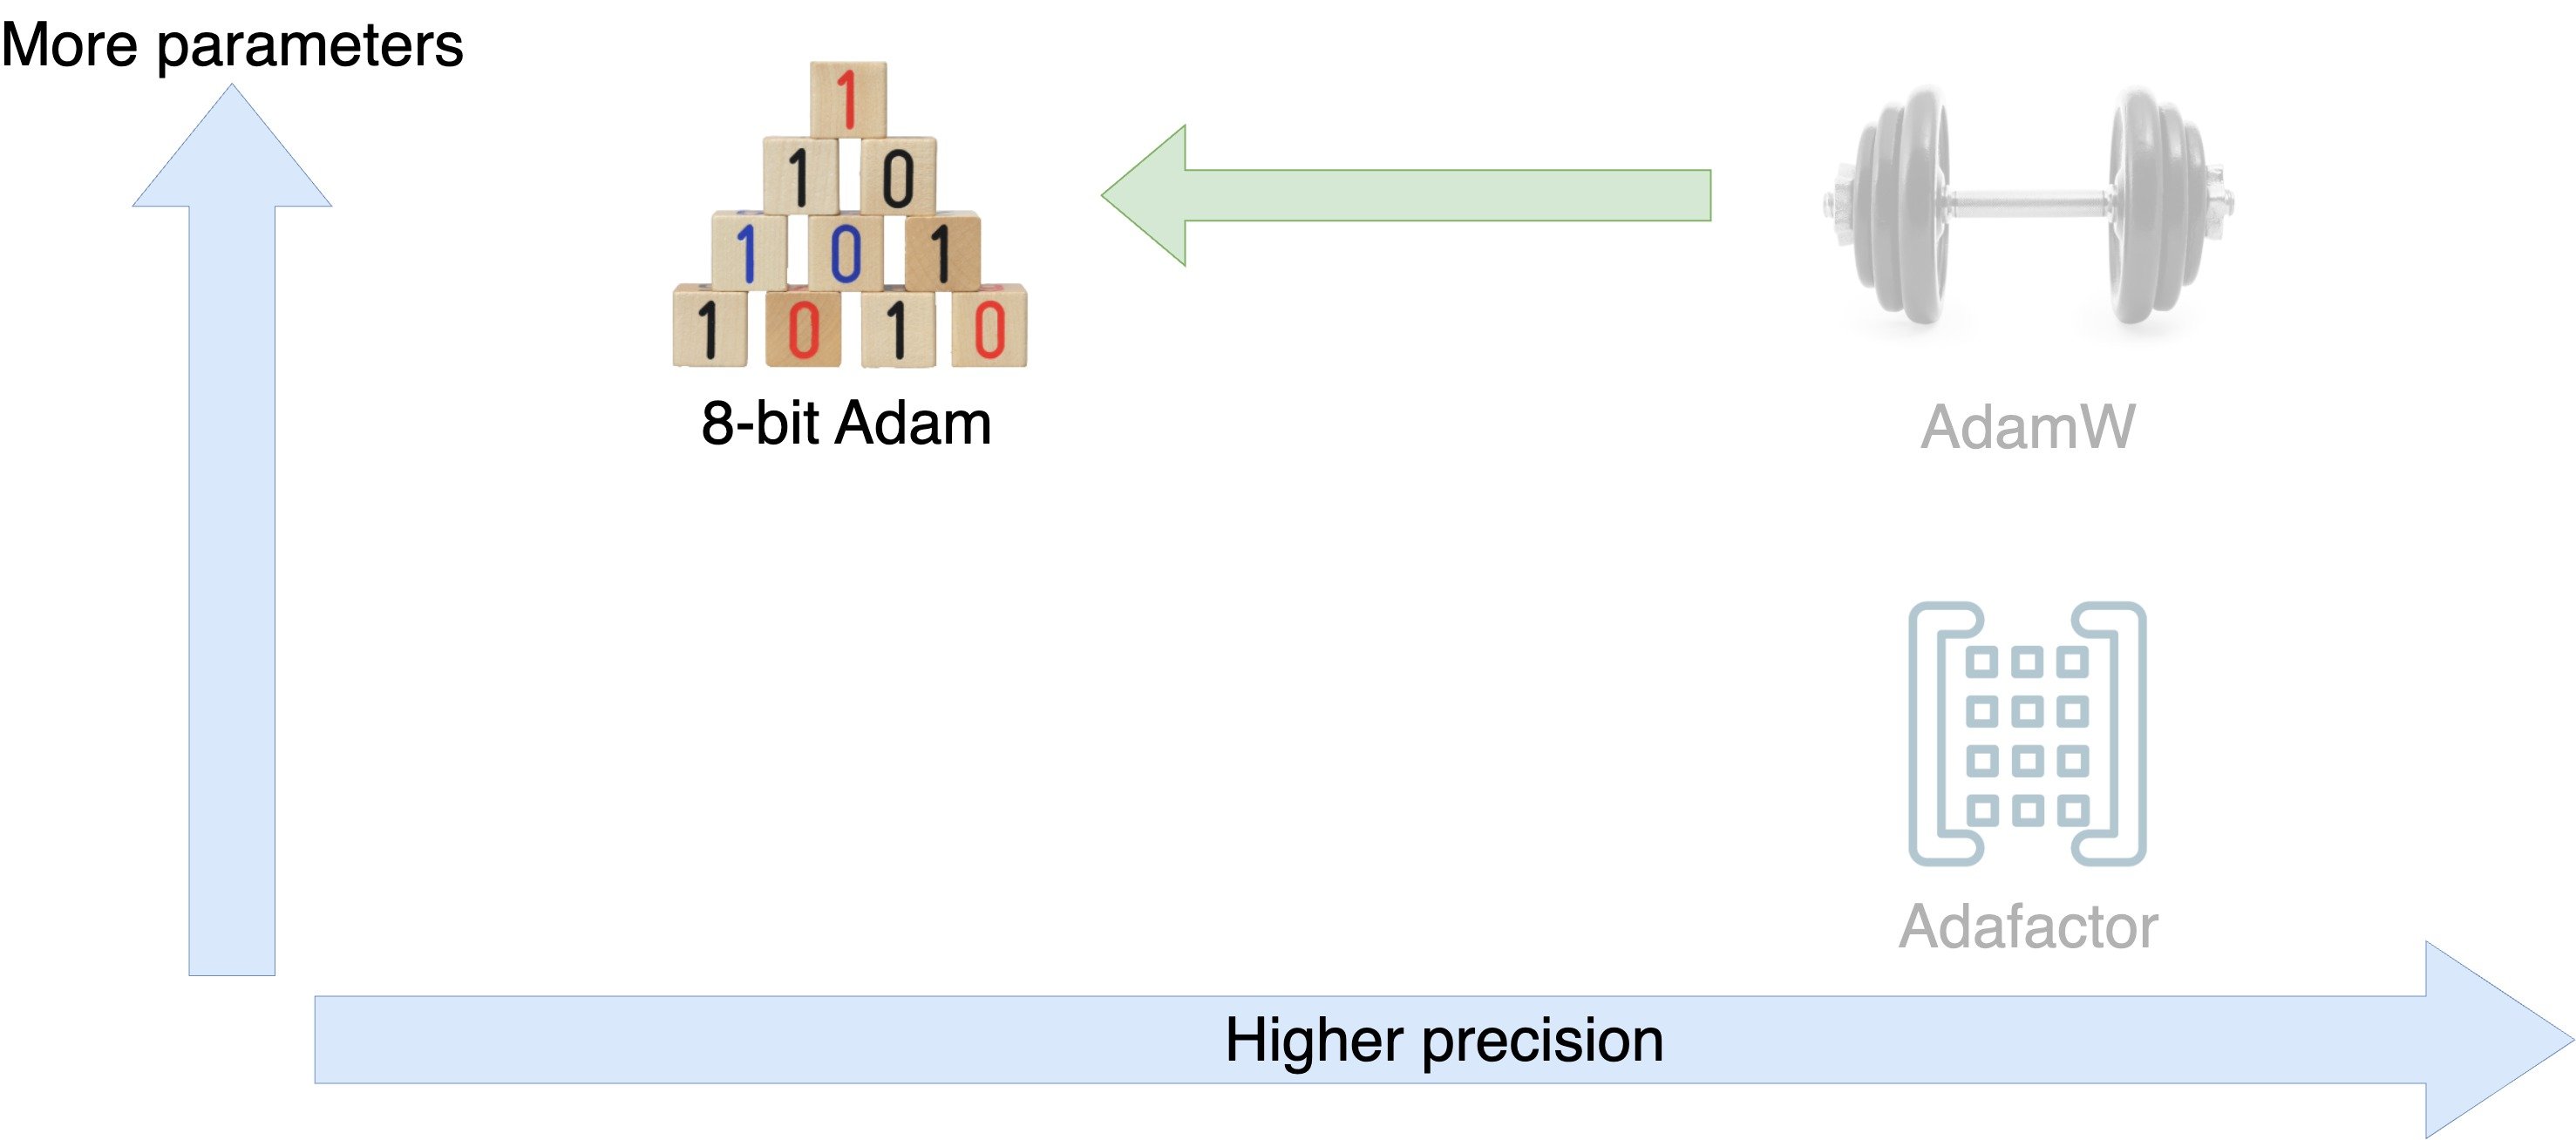
圖示:AdamW、Adafactor 與 8-bit Adam 在參數數量與精度間的取捨。

使用 PyTorch 高效訓練 AI 模型

提升訓練效率的最佳化器

圖示:AdamW、Adafactor 與 8-bit Adam 在參數數量與精度間的取捨。

使用 PyTorch 高效訓練 AI 模型

8-bit Adam 怎麼運作?

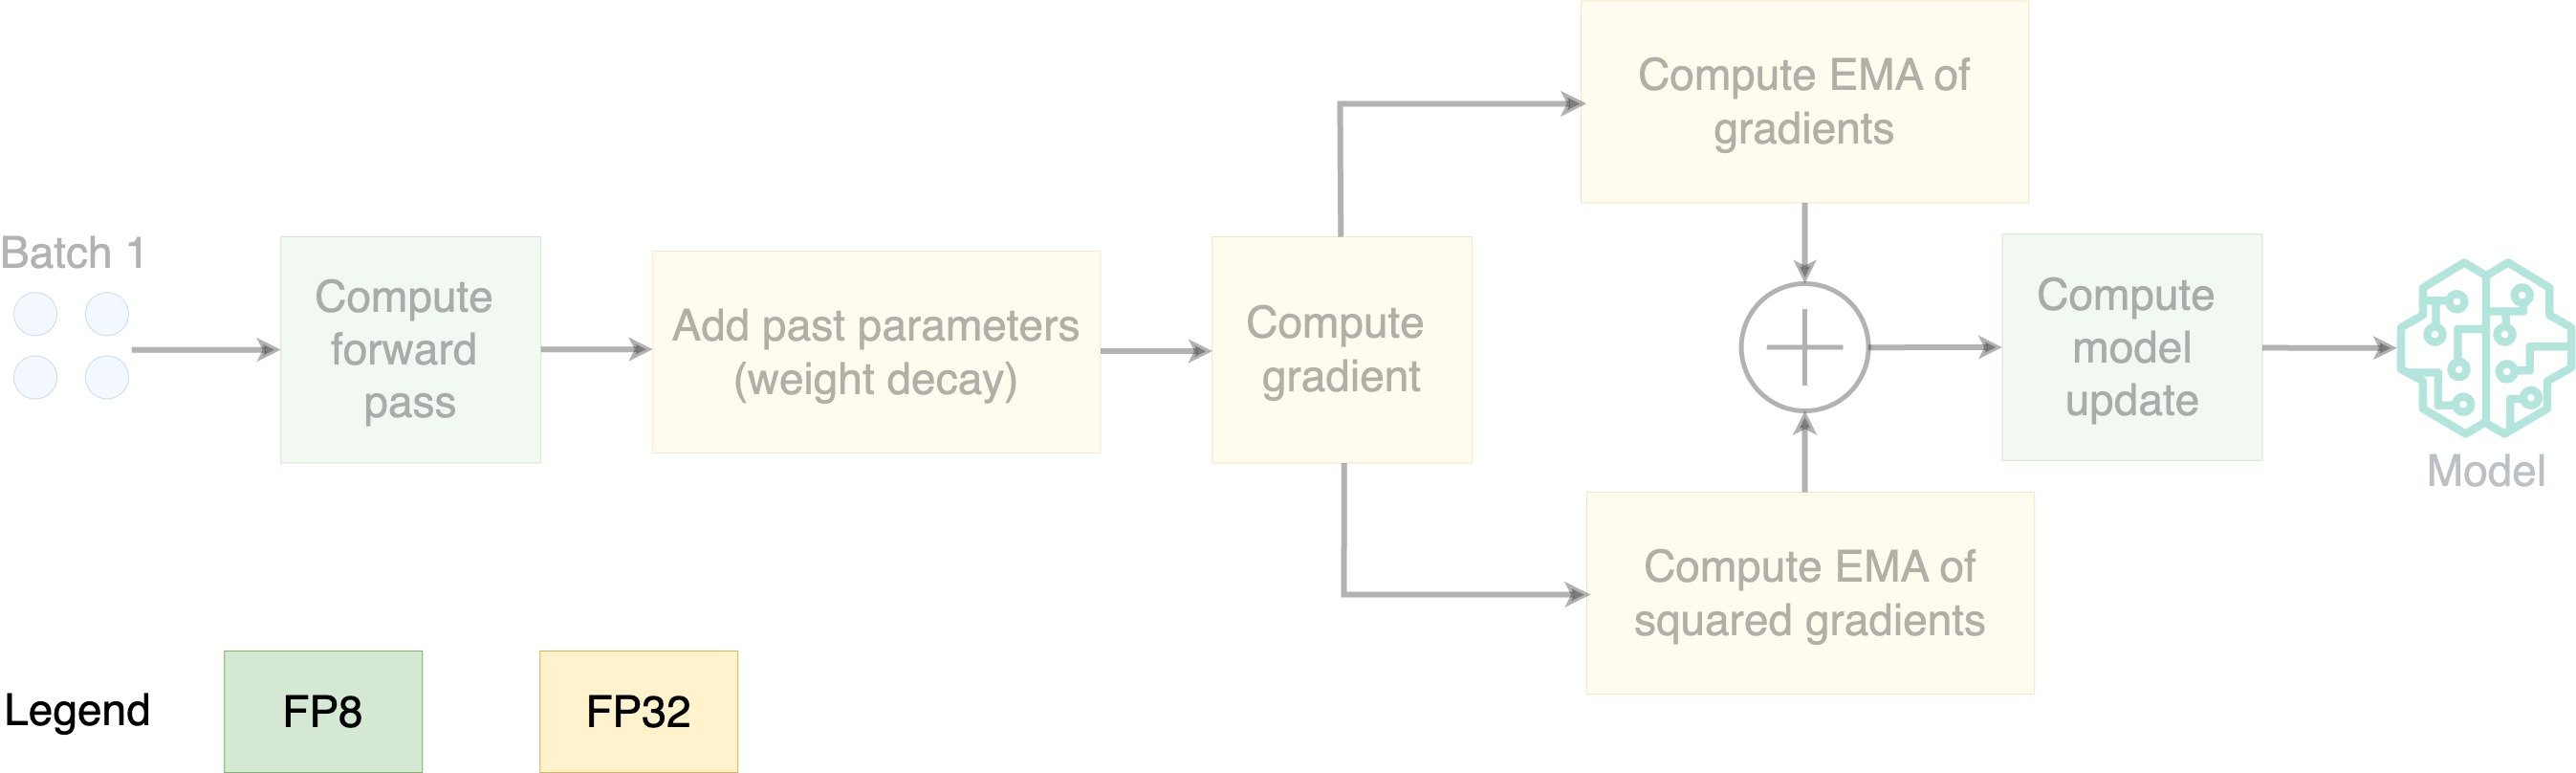
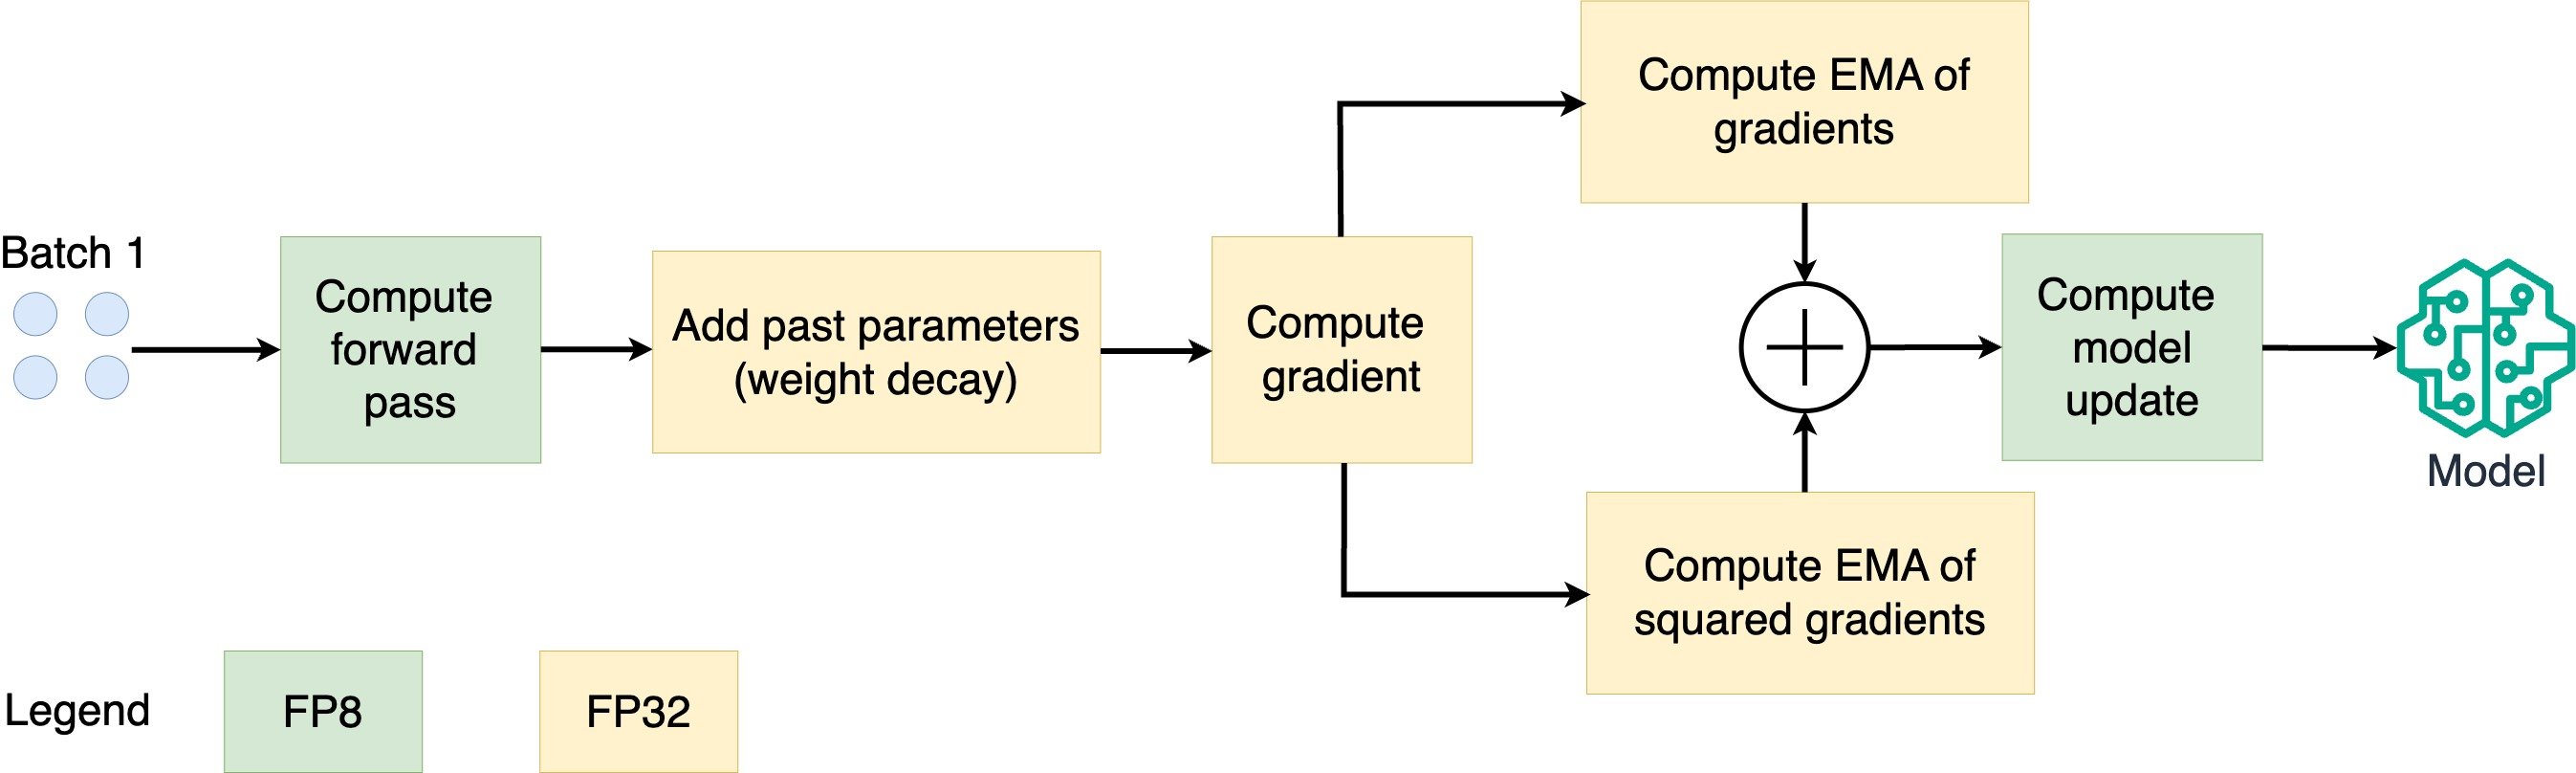
8-bit Adam 的步驟圖示。

  • 參數存於 FP8;以 FP32 最佳化
使用 PyTorch 高效訓練 AI 模型

8-bit Adam 怎麼運作?

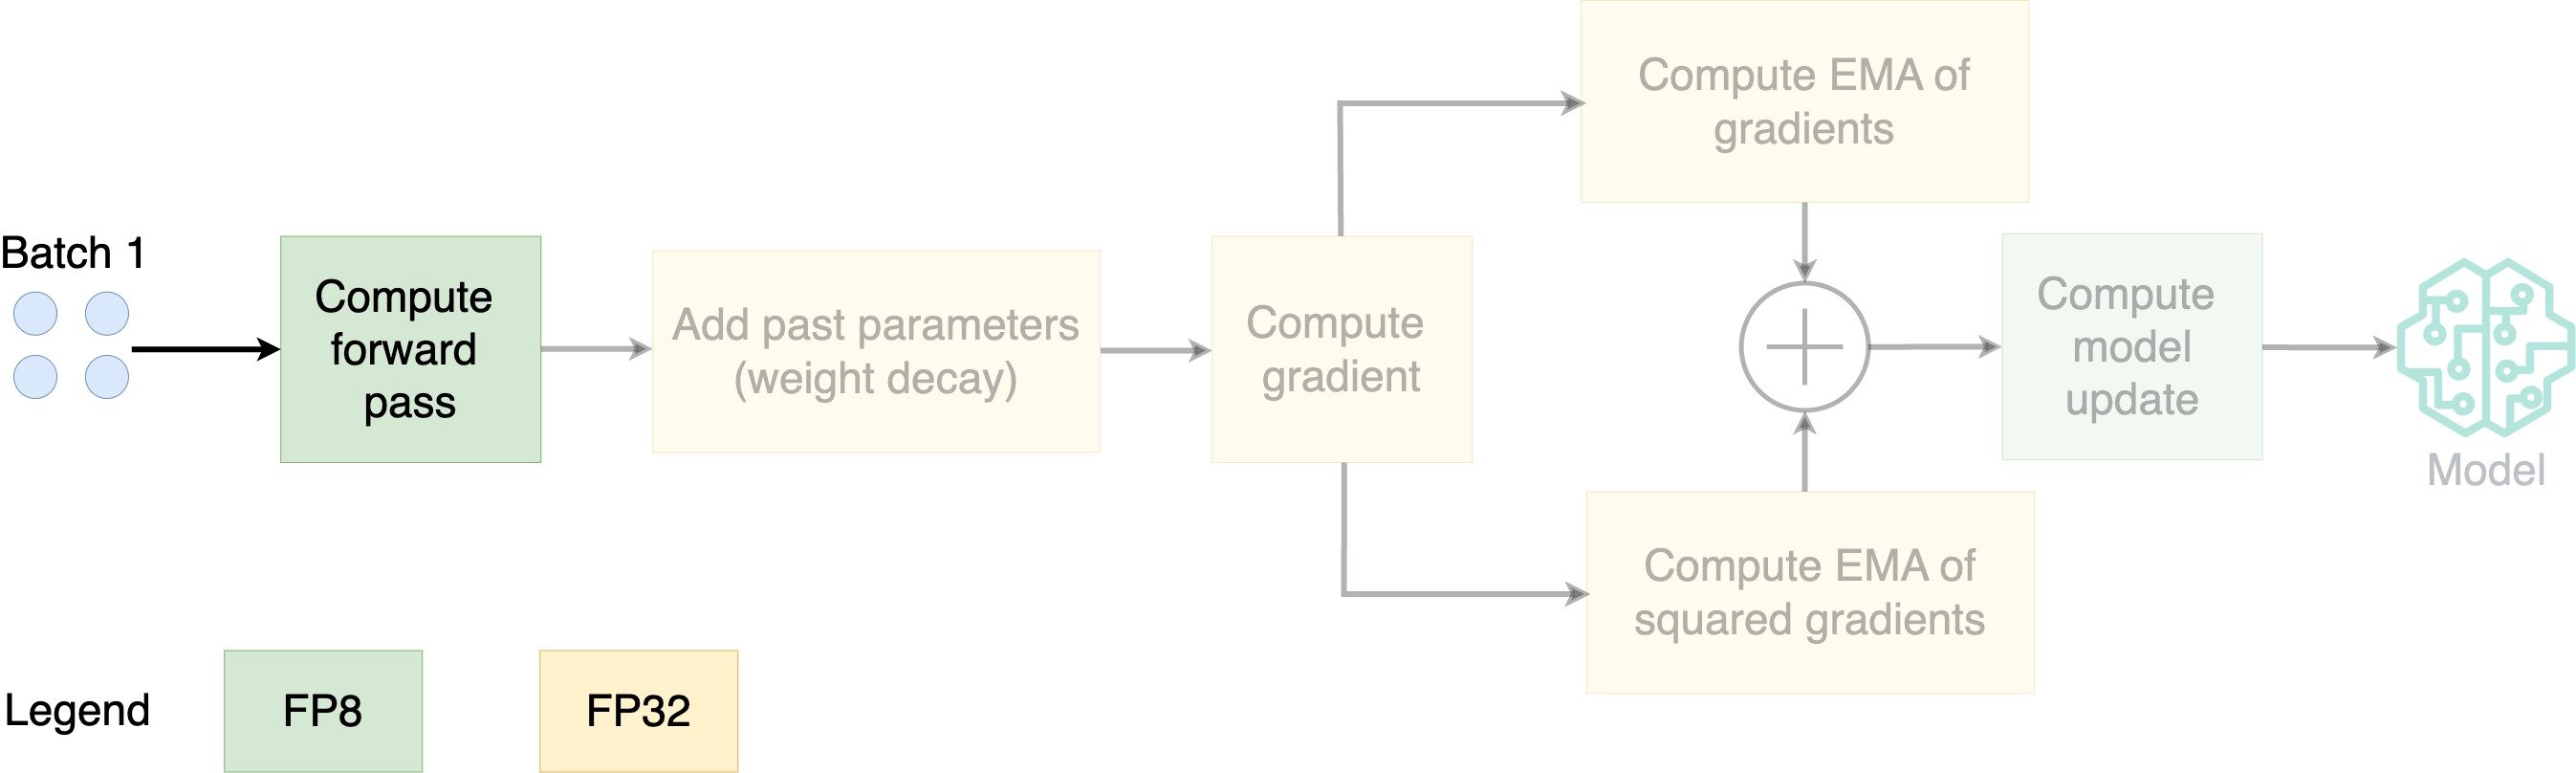
8-bit Adam 的步驟圖示。

  • 參數存於 FP8;以 FP32 最佳化
使用 PyTorch 高效訓練 AI 模型

8-bit Adam 怎麼運作?

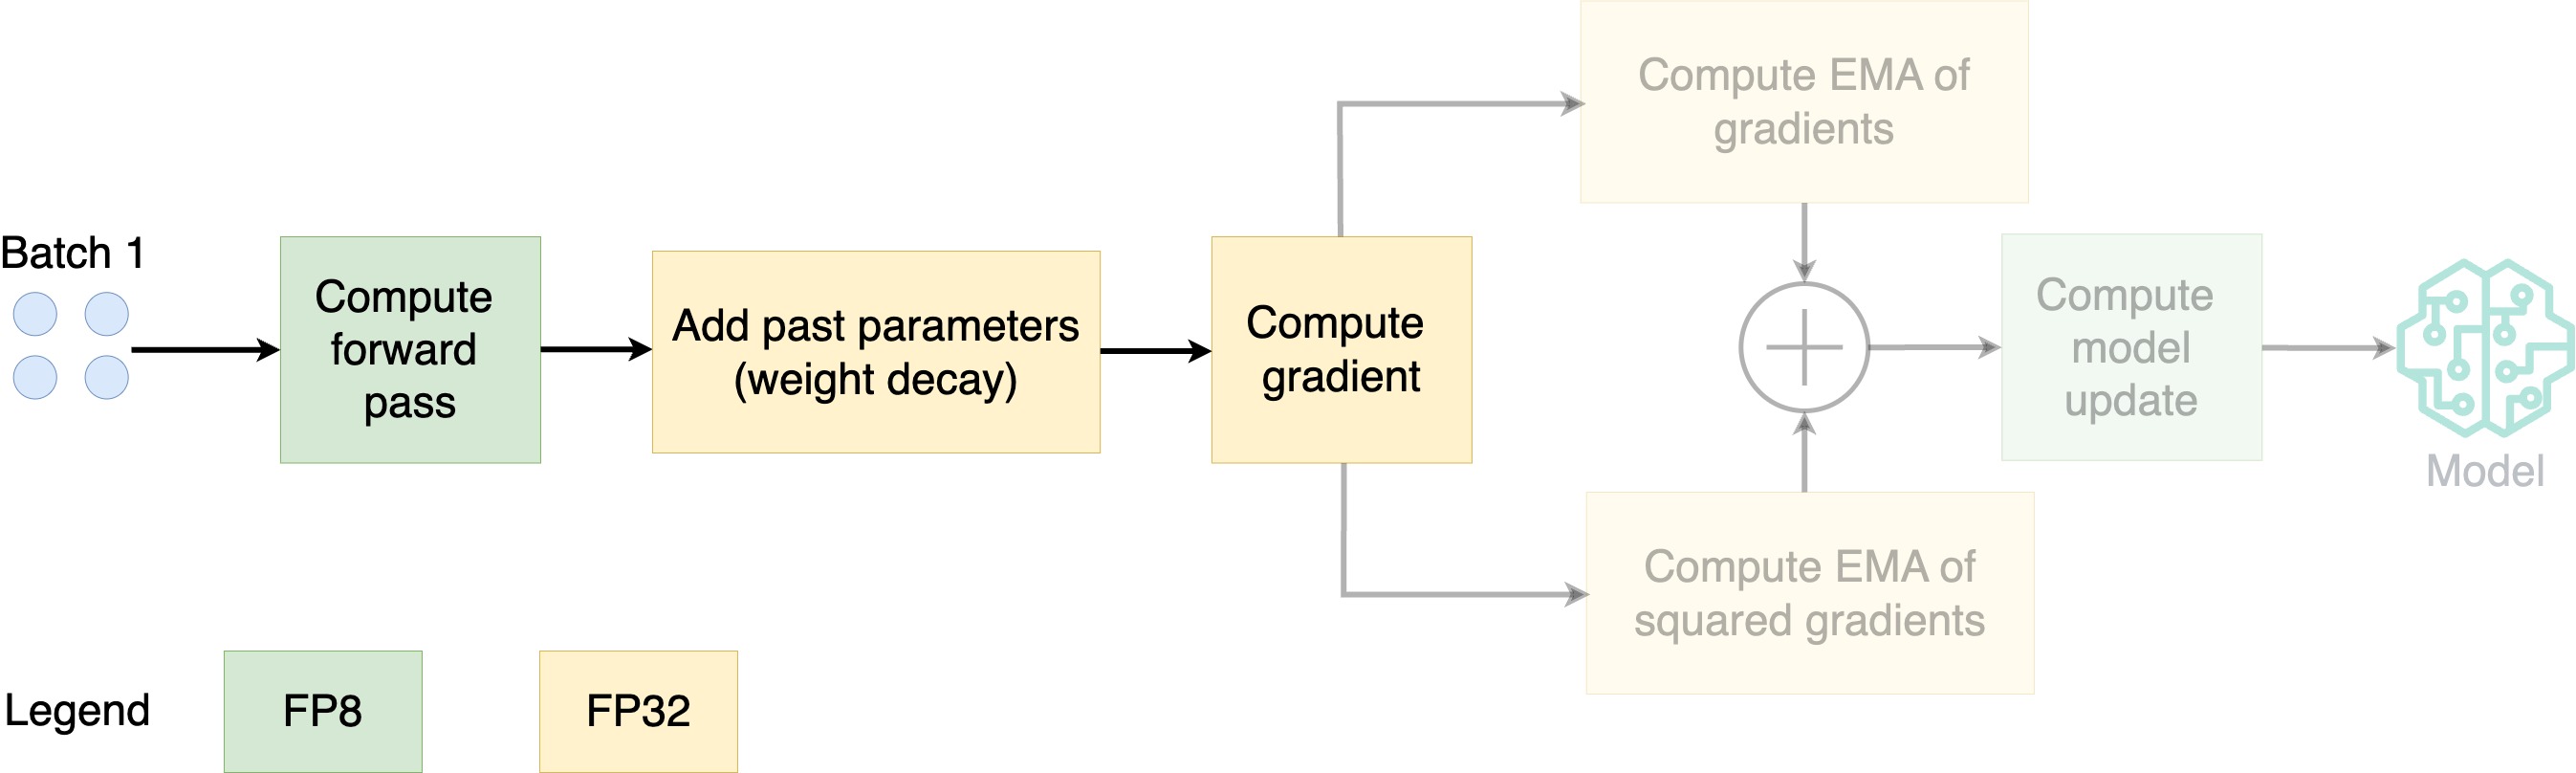
8-bit Adam 的步驟圖示。

  • 參數存於 FP8;以 FP32 最佳化
使用 PyTorch 高效訓練 AI 模型

8-bit Adam 怎麼運作?

8-bit Adam 的步驟圖示。

  • 參數存於 FP8;以 FP32 最佳化
  • EMA:指數移動平均
  • 計算梯度與平方梯度的 EMA
使用 PyTorch 高效訓練 AI 模型

8-bit Adam 怎麼運作?

8-bit Adam 的步驟圖示。

  • 參數存於 FP8;以 FP32 最佳化
  • EMA:指數移動平均
  • 計算梯度與平方梯度的 EMA
使用 PyTorch 高效訓練 AI 模型

8-bit Adam 如何省記憶體?

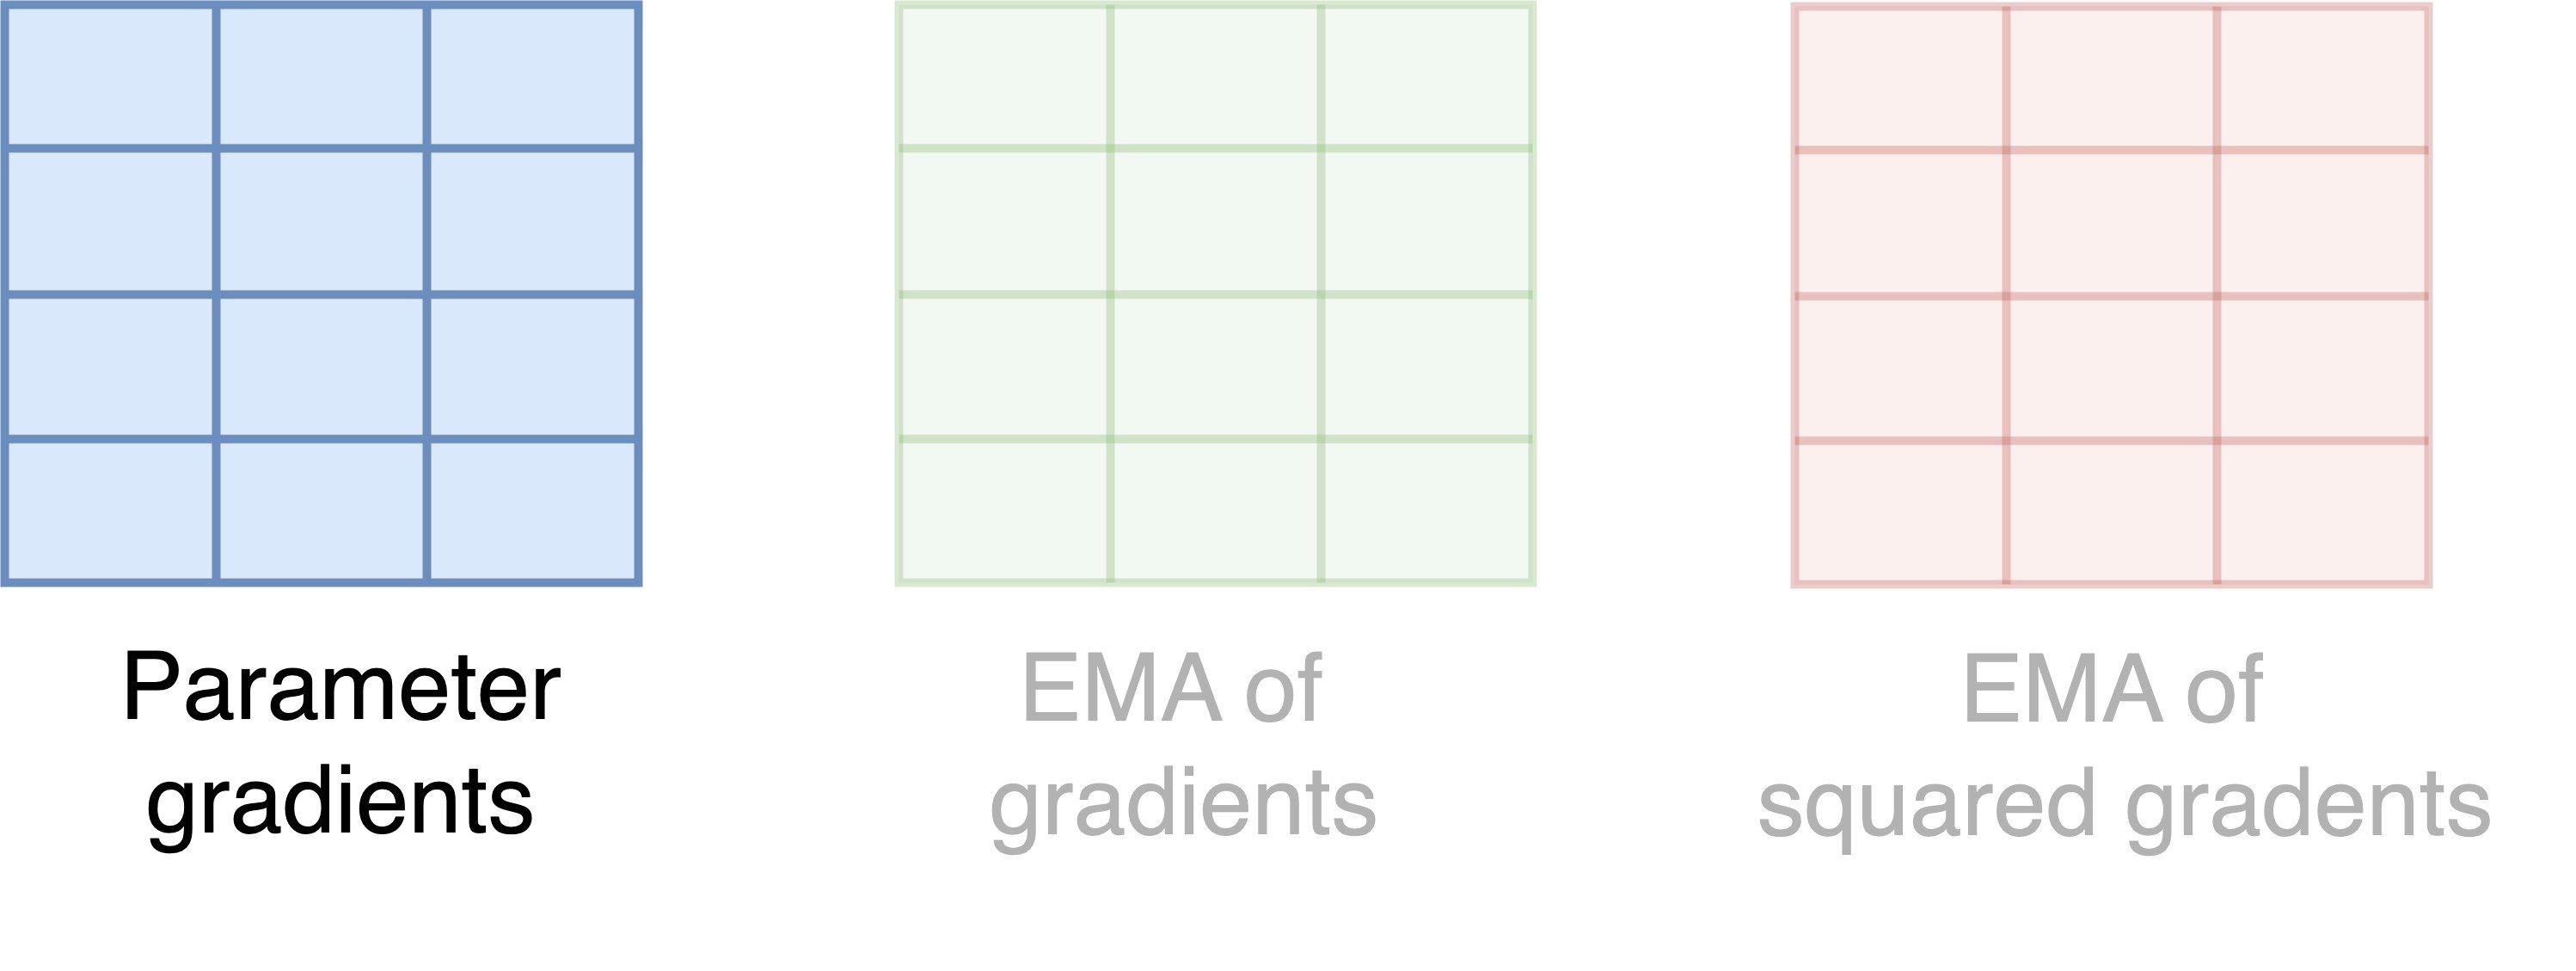
示意圖:參數梯度、梯度 EMA、平方梯度 EMA。

使用 PyTorch 高效訓練 AI 模型

8-bit Adam 如何省記憶體?

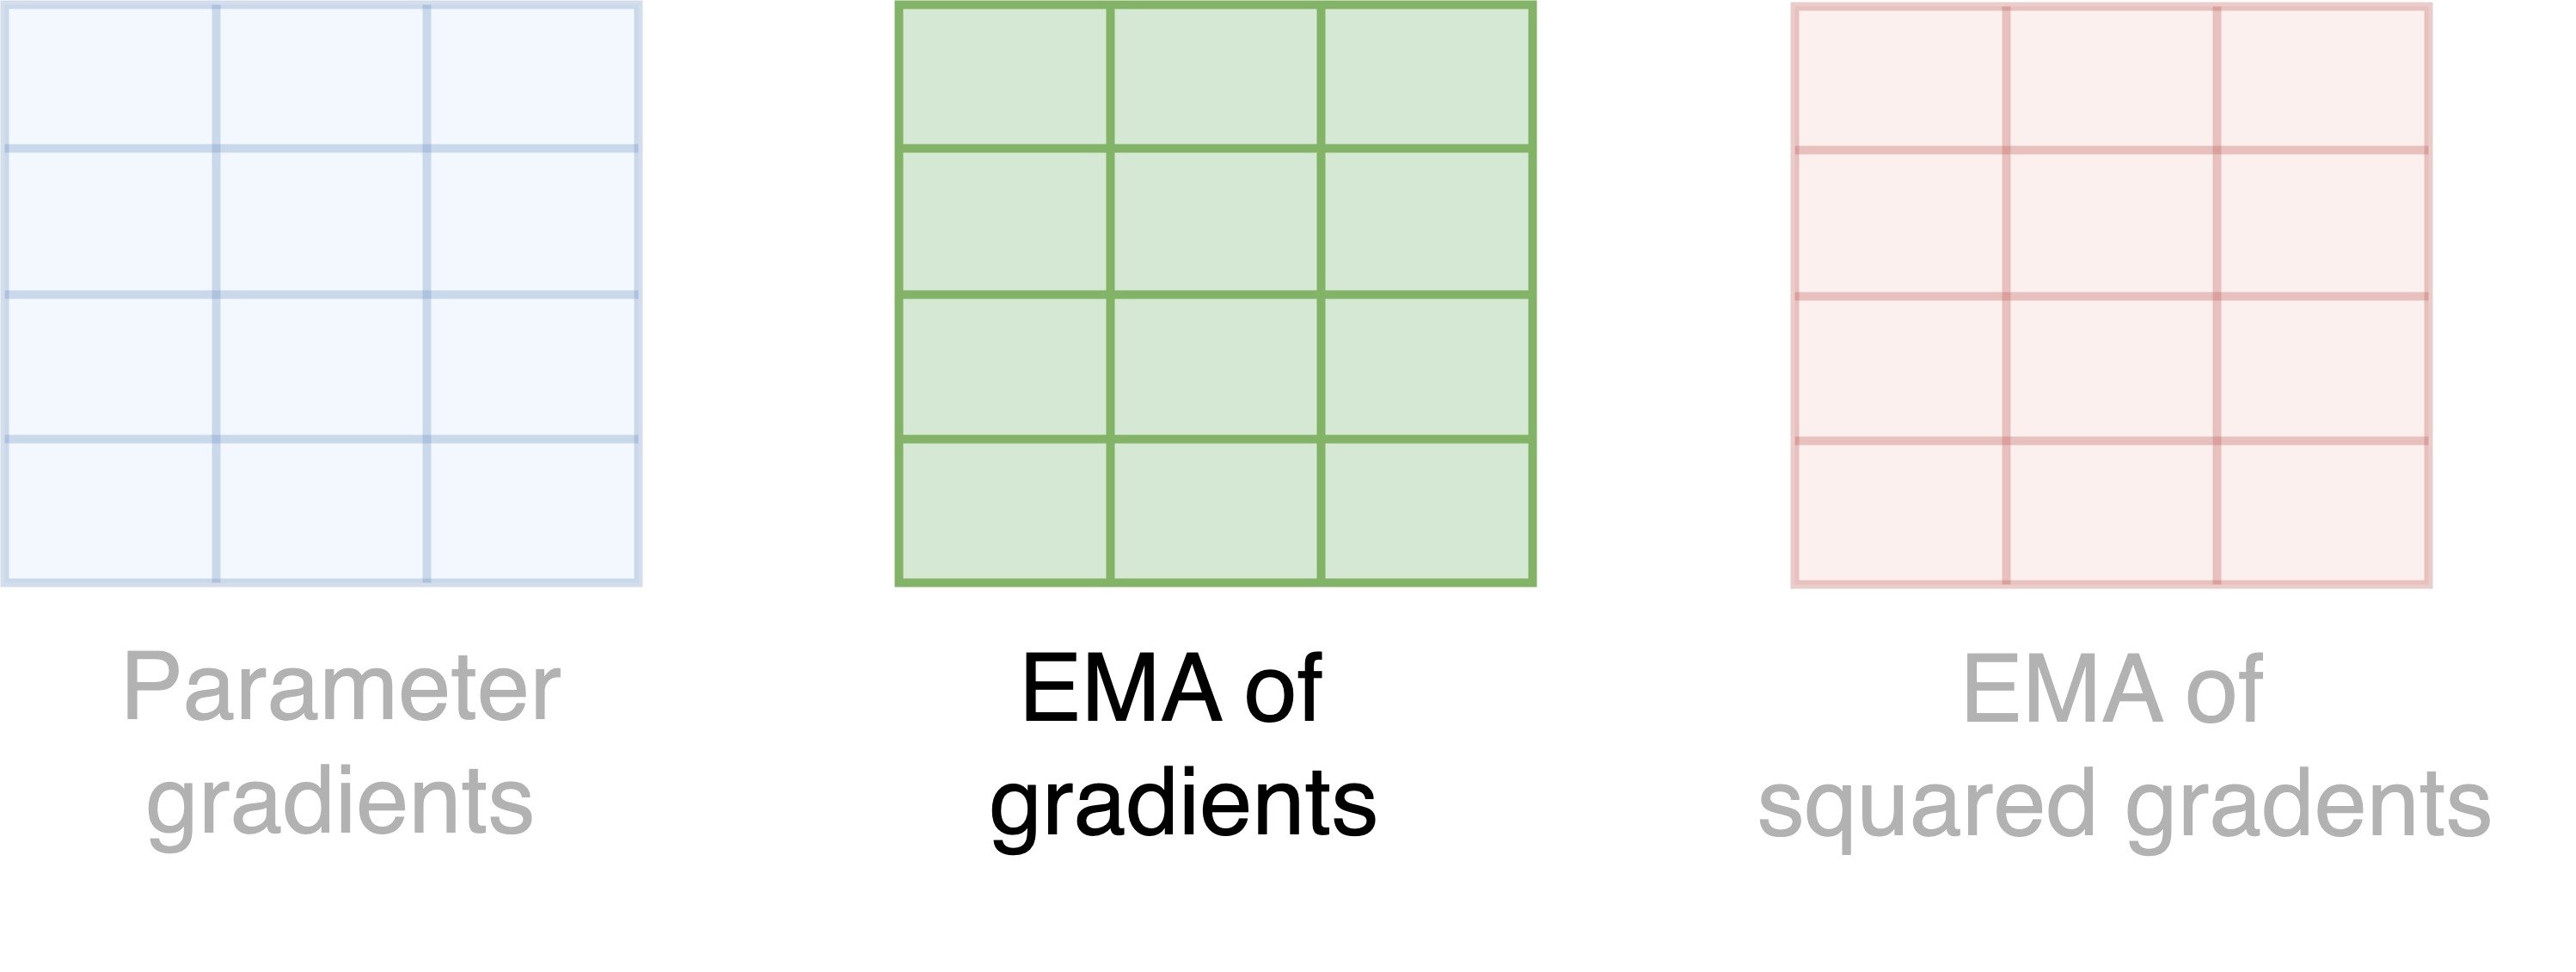
示意圖:參數梯度、梯度 EMA、平方梯度 EMA。

使用 PyTorch 高效訓練 AI 模型

8-bit Adam 如何省記憶體?

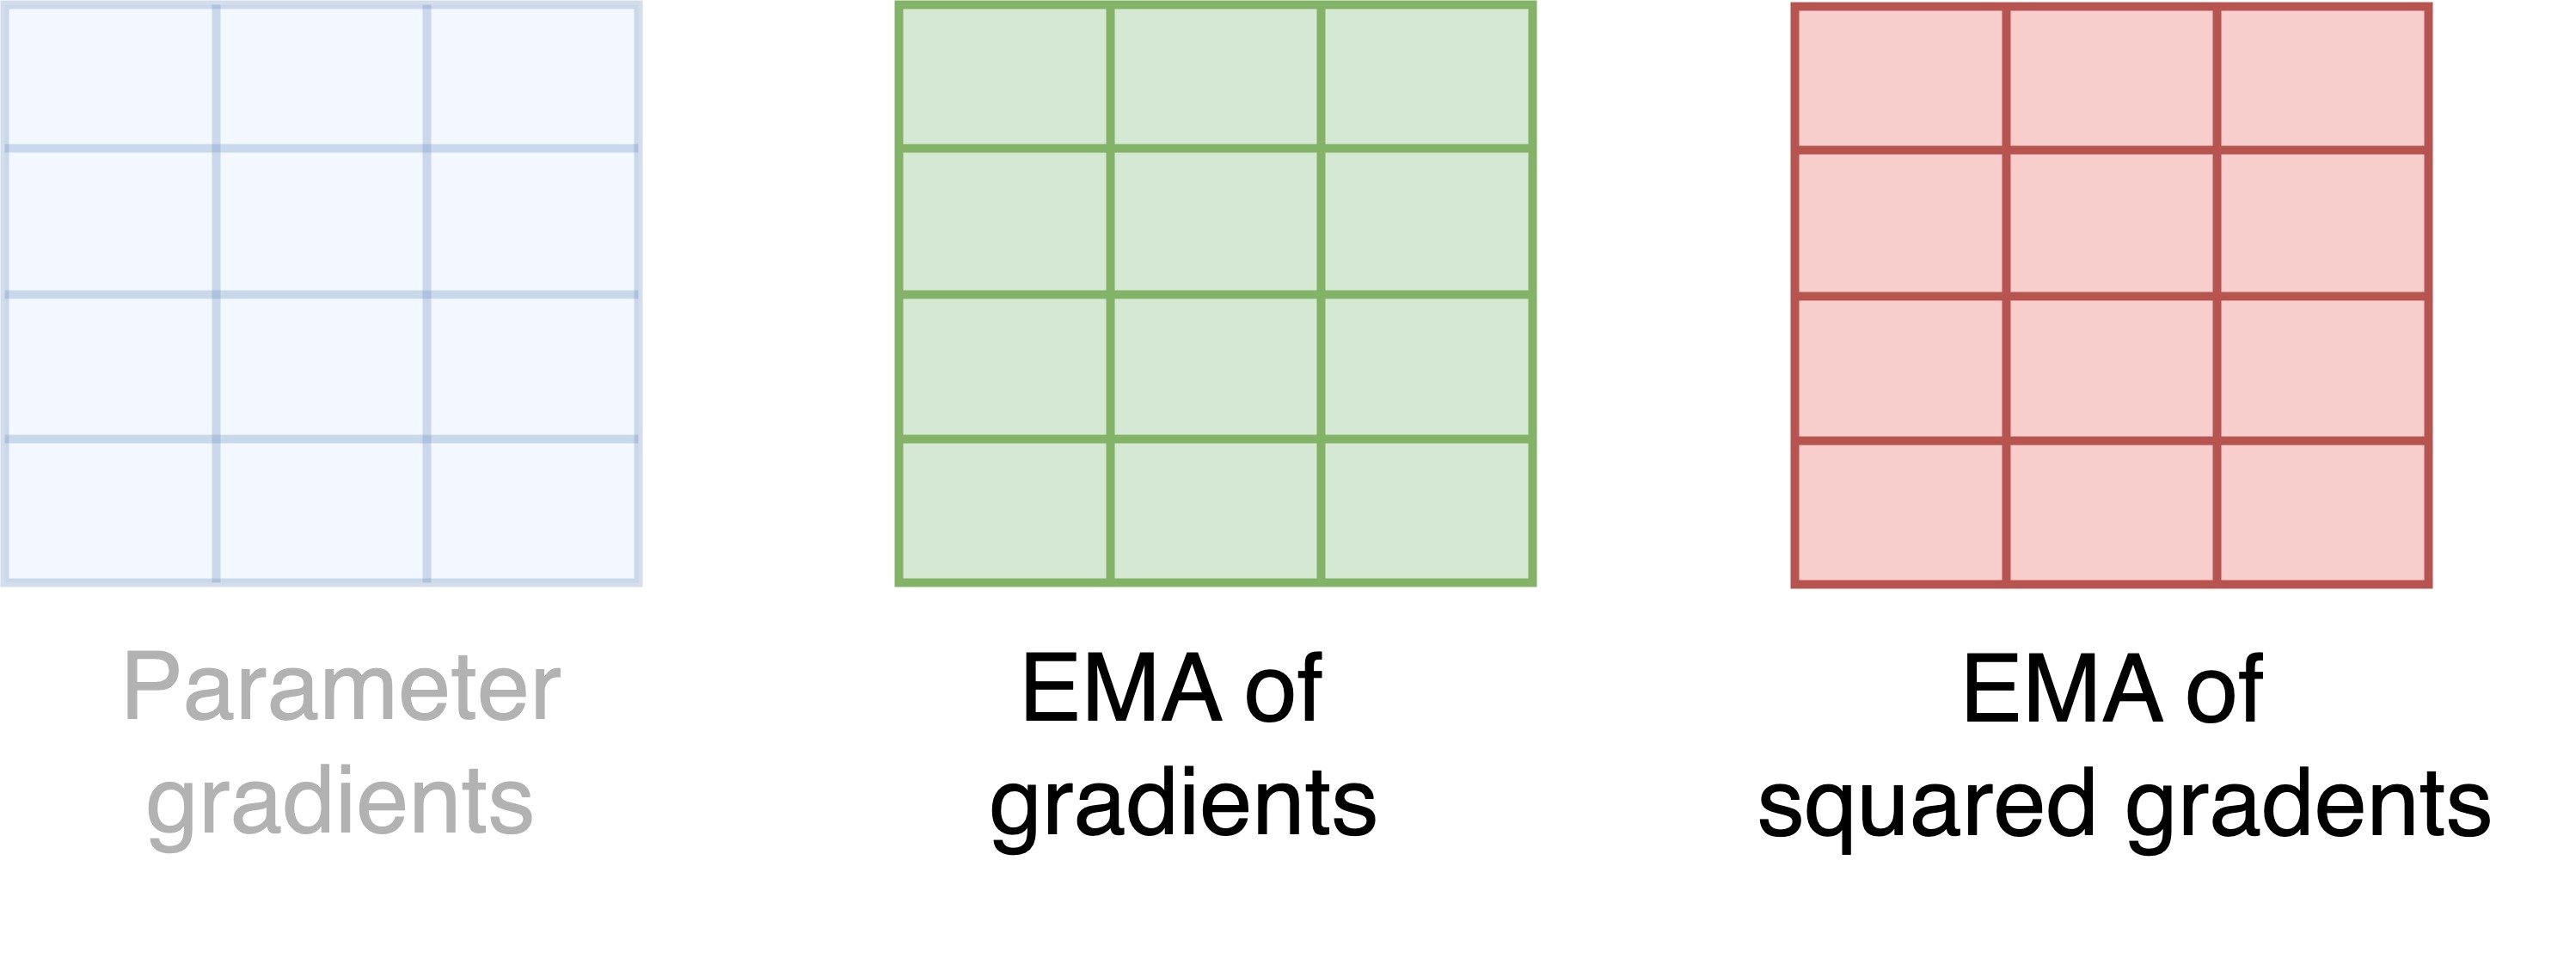
示意圖:參數梯度、梯度 EMA、平方梯度 EMA。

  • 每個小方格是一個參數,每種顏色是一種狀態
  • 每參數記憶體 = 2 位元組 = 每狀態 1 位元組 × 2 種狀態
  • 總記憶體 = 每參數記憶體(2 位元組)× 參數數量
使用 PyTorch 高效訓練 AI 模型

估算 8-bit Adam 的記憶體用量

model = AutoModelForSequenceClassification.from_pretrained(
    "distilbert-base-cased", return_dict=True)
num_parameters = sum(p.numel() for p in model.parameters())
print(f"Number of model parameters: {num_parameters:,}")
Number of model parameters: 65,783,042
estimated_memory = num_parameters * 2 / (1024 ** 2)
print(f"Estimated memory usage of 8-bit Adam: {estimated_memory:.0f} MB")
Estimated memory usage of 8-bit Adam: 125 MB
使用 PyTorch 高效訓練 AI 模型

設定 8-bit Adam 最佳化器

import bitsandbytes as bnb
from torch import nn
from transformers.trainer_pt_utils import get_parameter_names


args = TrainingArguments(output_dir="./results")
decay_parameters = get_parameter_names(model, [nn.LayerNorm])
decay_parameters = [name for name in decay_parameters if "bias" not in name]
  • 權重衰減可避免過度擬合
  • decay_parameters:指定要套用權重衰減的參數
  • get_parameter_names:回傳參數名稱;忽略 nn.LayerNorm
  • decay_parameters 中移除 bias 參數
  • 正規化層與偏置不套用權重衰減
使用 PyTorch 高效訓練 AI 模型

設定 8-bit Adam 最佳化器

optimizer_grouped_parameters = [{"params": [p for n, p in model.named_parameters() 
                                            if n in decay_parameters],
                                 "weight_decay": args.weight_decay},

{"params": [p for n, p in model.named_parameters() if n not in decay_parameters], "weight_decay": 0.0}]
adam_bnb_optim = bnb.optim.Adam8bit(optimizer_grouped_parameters,
betas=(args.adam_beta1, args.adam_beta2),
eps=args.adam_epsilon,
lr=args.learning_rate)
  • optimizer_grouped_parameters:一組套用權重衰減,另一組不套用
  • beta1beta2:一階與二階動量的衰減率;越高越穩定、訓練較慢
使用 PyTorch 高效訓練 AI 模型

用 Trainer 實作 8-bit Adam

trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=train_dataset,
                  eval_dataset=validation_dataset,
                  optimizers=(adam_bnb_optim, None),
                  compute_metrics=compute_metrics)

trainer.train()
{'epoch': 1.0, 'eval_loss': 0.63, 'eval_accuracy': 0.67, 'eval_f1': 0.62}
{'epoch': 2.0, 'eval_loss': 0.61, 'eval_accuracy': 0.71, 'eval_f1': 0.66}
使用 PyTorch 高效訓練 AI 模型

用 Accelerator 實作 8-bit Adam

model, adam_bnb_optim, train_dataloader, lr_scheduler = \
    accelerator.prepare(model, adam_bnb_optim, train_dataloader, lr_scheduler)


for batch in train_dataloader: inputs, targets = batch["input_ids"], batch["labels"] outputs = model(inputs, labels=targets) loss = outputs.loss accelerator.backward(loss) adam_bnb_optim.step() lr_scheduler.step() adam_bnb_optim.zero_grad() print(f"Loss = {loss}")
Loss = 0.75
使用 PyTorch 高效訓練 AI 模型

計算 8-bit Adam 的記憶體用量

total_size_megabytes, total_num_elements = \
    compute_optimizer_size(trainer.optimizer.state.values())
print(f"Number of 8-bit Adam parameters: {total_num_elements:,}")
print(f"8-bit Adam size: {total_size_megabytes:.0f} MB")
Number of 8-bit Adam parameters: 131,566,188
8-bit Adam size: 128 MB
  • 與 AdamW 比較:8-bit Adam 僅用 1/4 記憶體
Number of AdamW parameters: 131,566,188
AdamW size: 502 MB
使用 PyTorch 高效訓練 AI 模型

一起來練習吧!

使用 PyTorch 高效訓練 AI 模型

Preparing Video For Download...