梯度累積

使用 PyTorch 高效訓練 AI 模型

Dennis Lee

Data Engineer, Amazon

分散式訓練
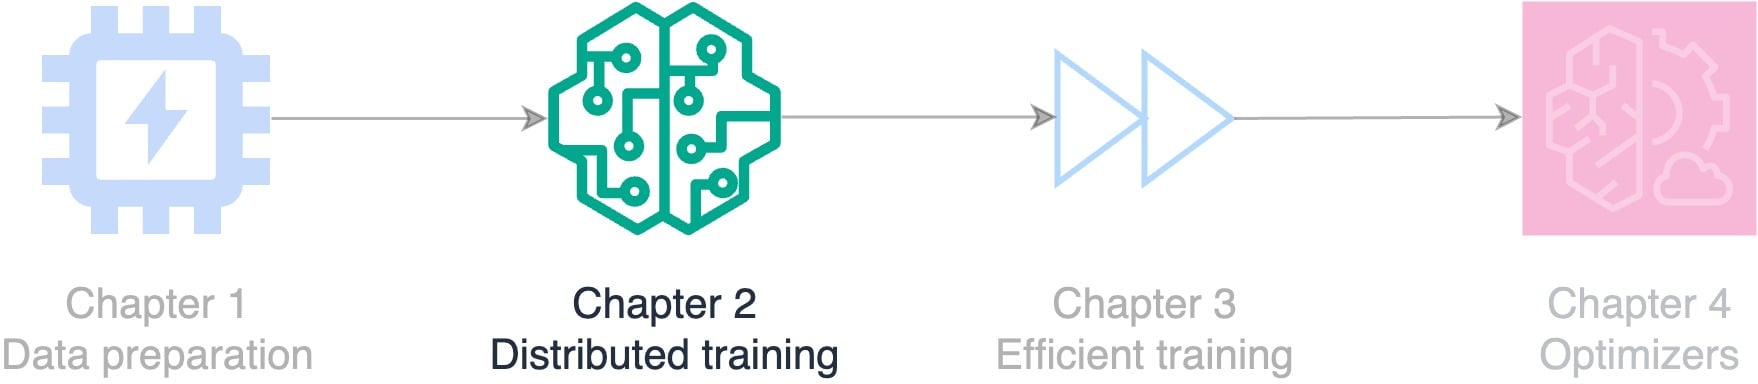


流程圖:課程主題包含資料準備、分散式訓練、高效訓練與最佳化器。

使用 PyTorch 高效訓練 AI 模型

高效訓練


流程圖:課程主題包含資料準備、分散式訓練、高效訓練與最佳化器。

使用 PyTorch 高效訓練 AI 模型

提升訓練效率


圖示:記憶體效率、通訊效率與運算效率。

使用 PyTorch 高效訓練 AI 模型

提升訓練效率


圖示:記憶體效率、通訊效率與運算效率。

使用 PyTorch 高效訓練 AI 模型

提升訓練效率


圖示:記憶體效率、通訊效率與運算效率。

使用 PyTorch 高效訓練 AI 模型

梯度累積提升記憶體效率


圖示:記憶體效率、通訊效率與運算效率。

使用 PyTorch 高效訓練 AI 模型

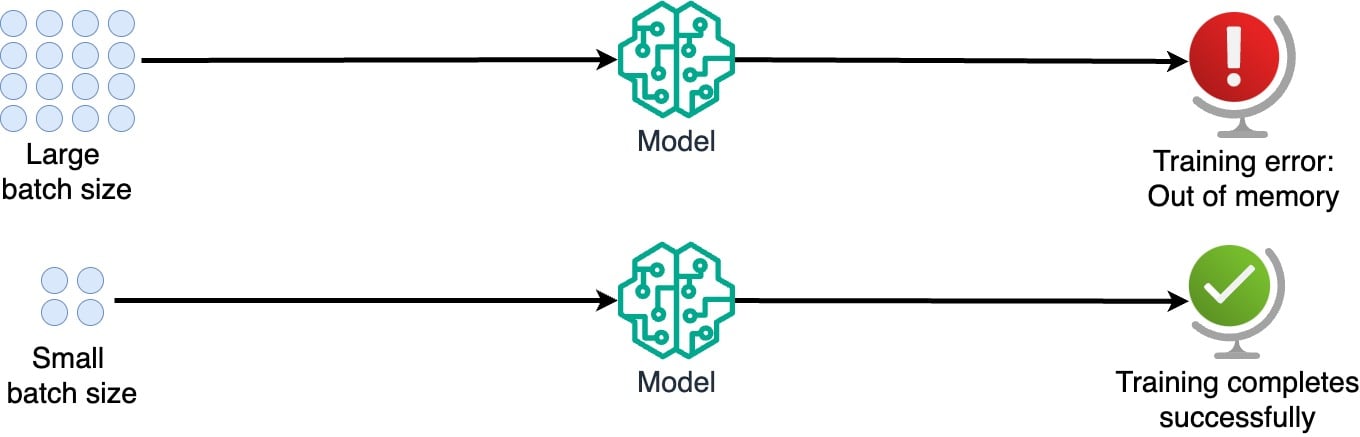
大批次的問題

  • 大批次:梯度估計更穩定,學習更快
  • GPU 記憶體限制批次大小


示意圖:大批次可能導致記憶體不足錯誤;較小批次可讓訓練順利完成。

使用 PyTorch 高效訓練 AI 模型

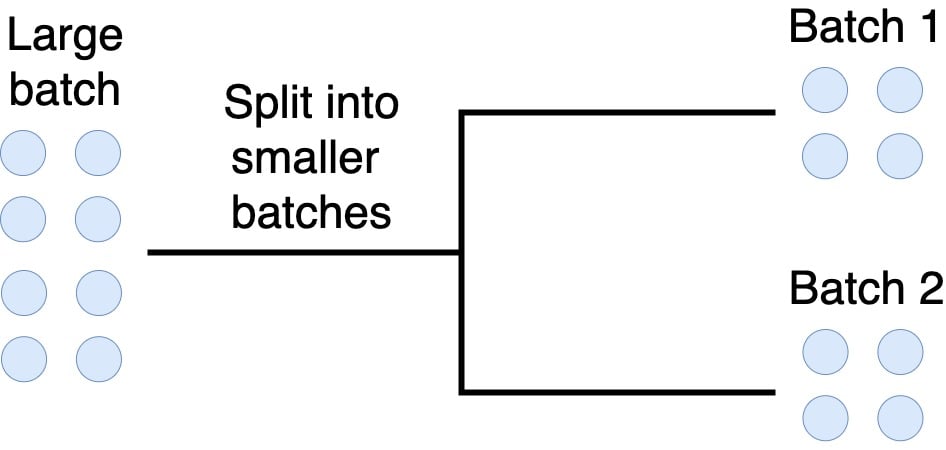
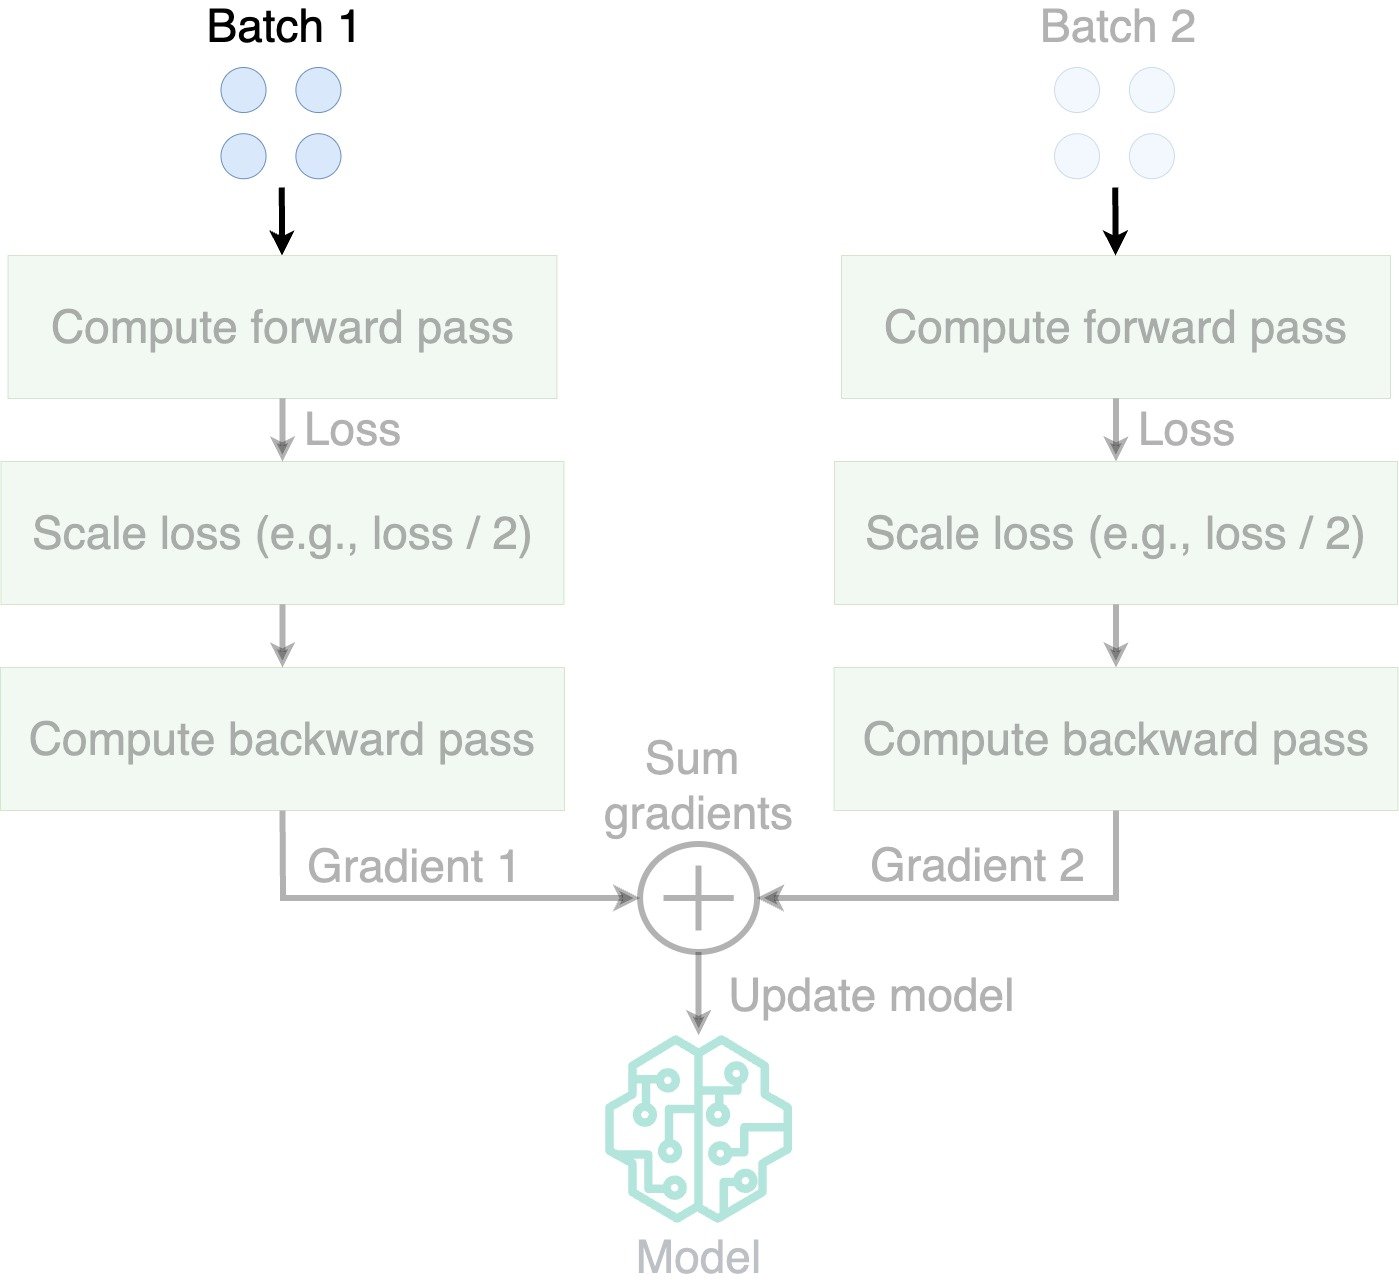
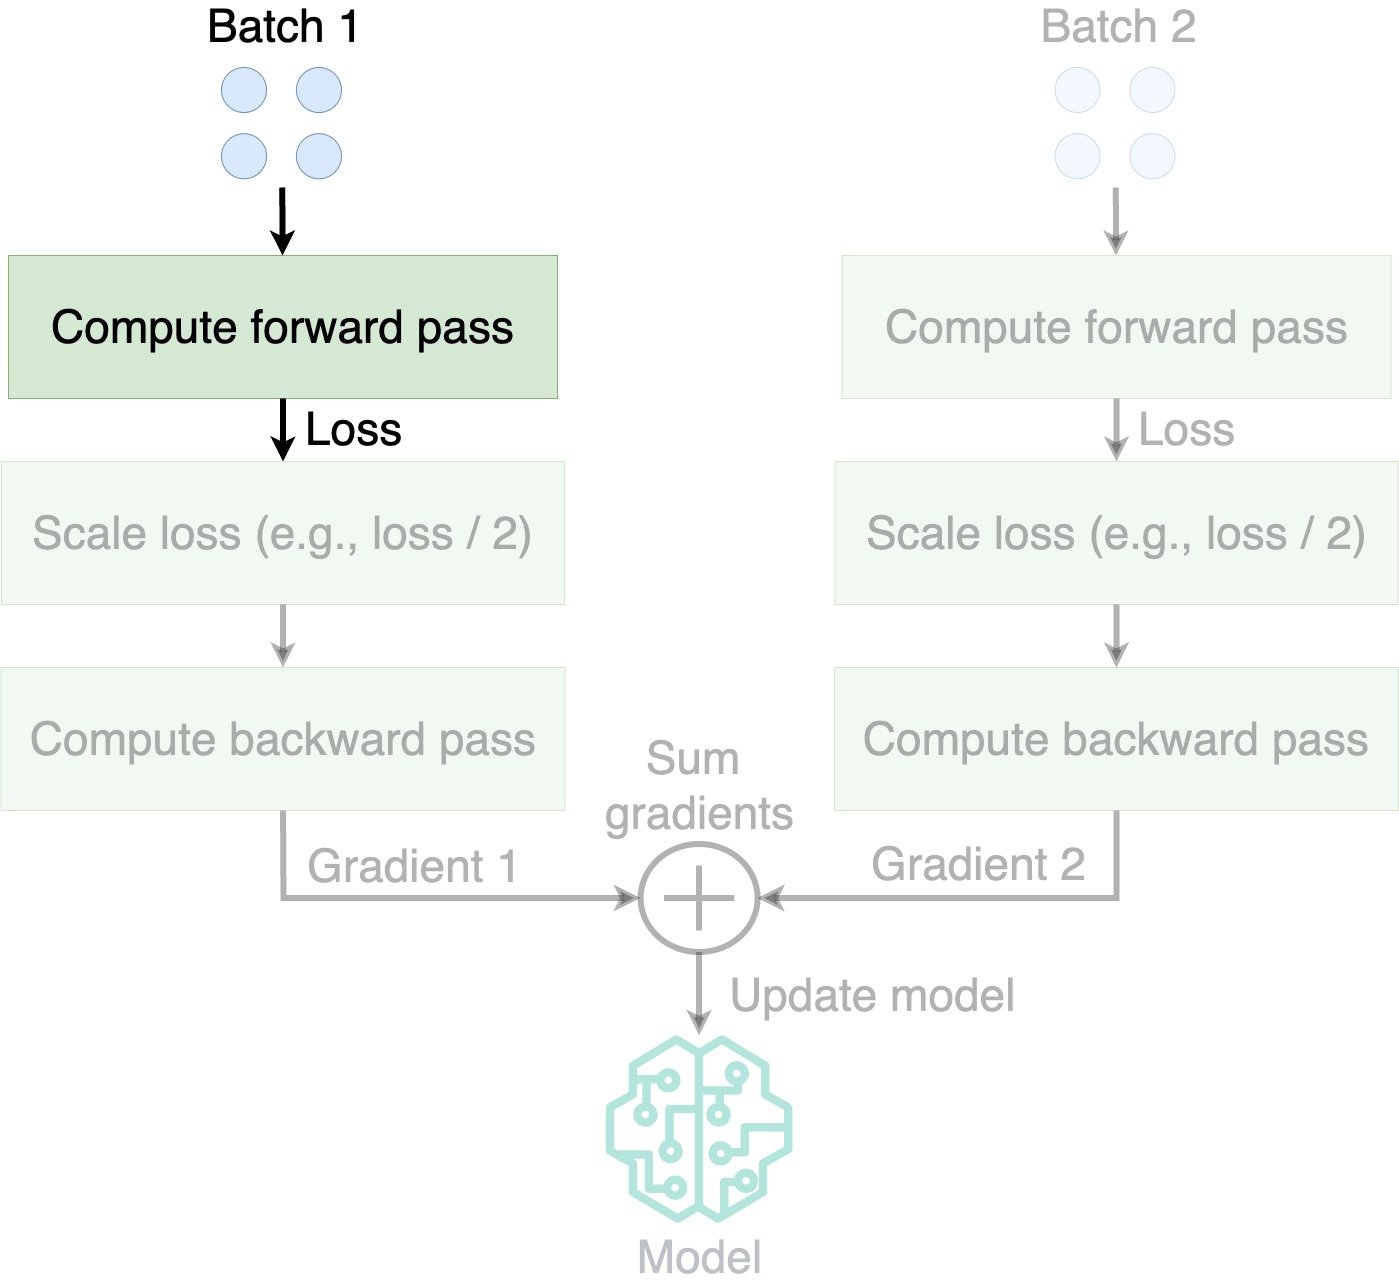
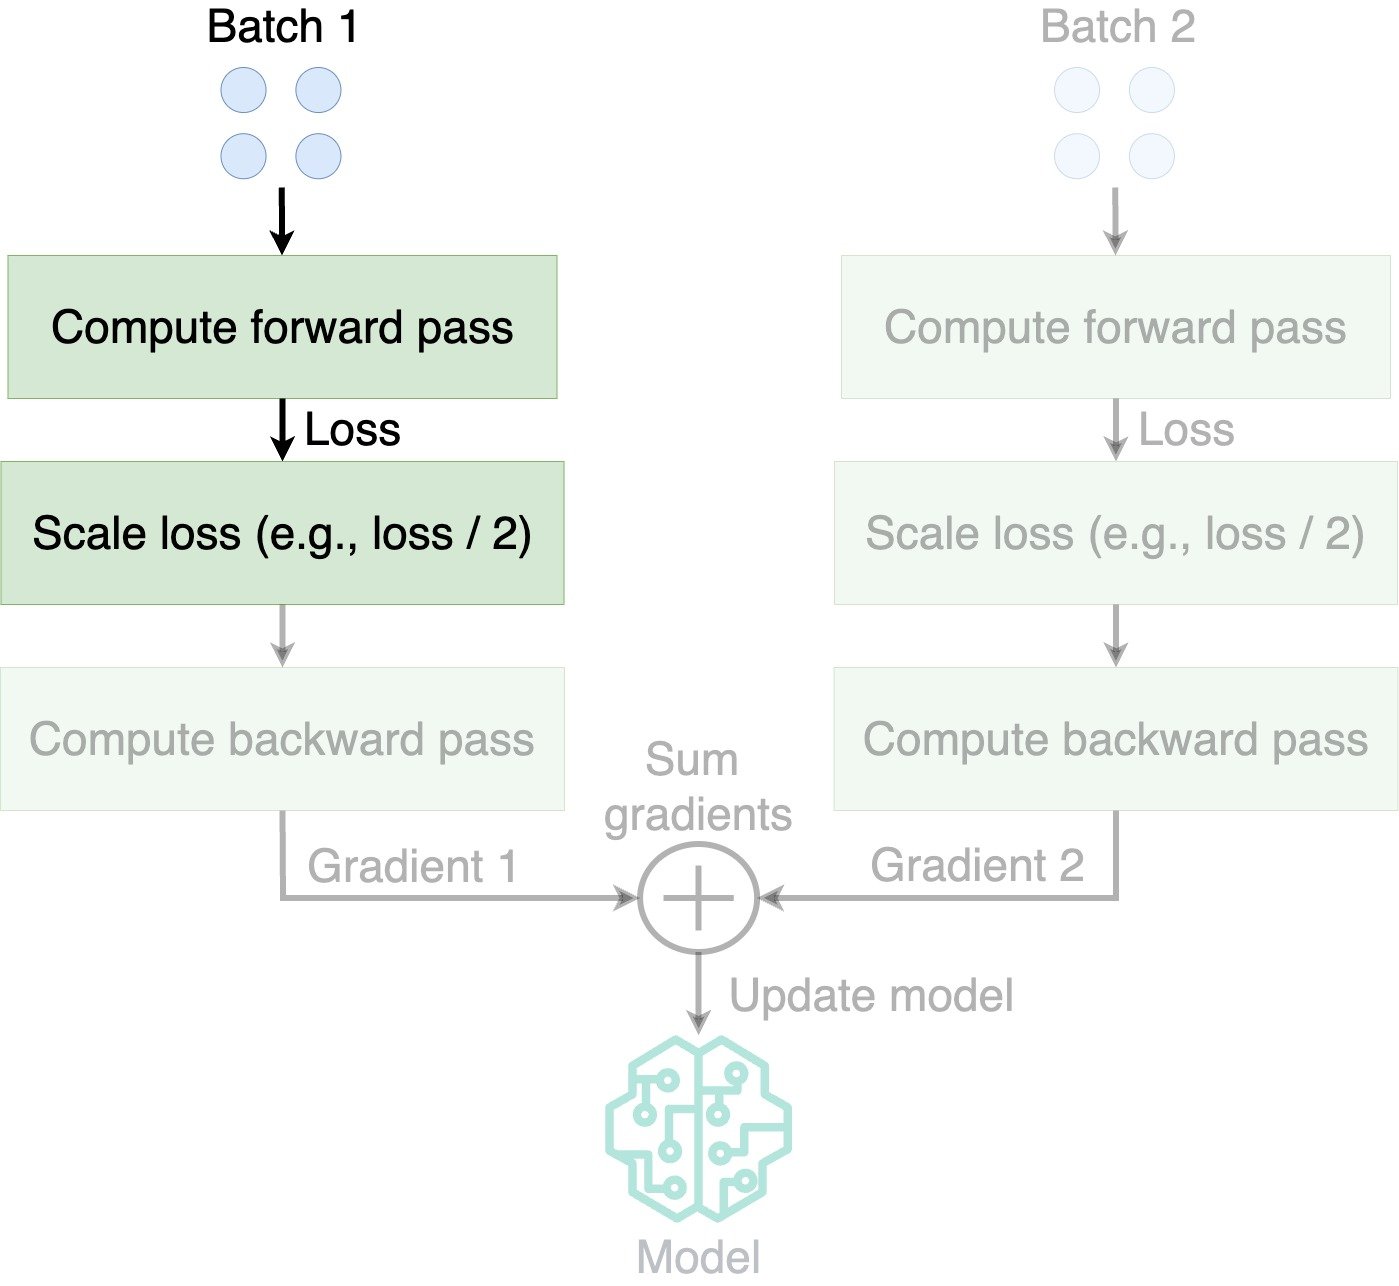
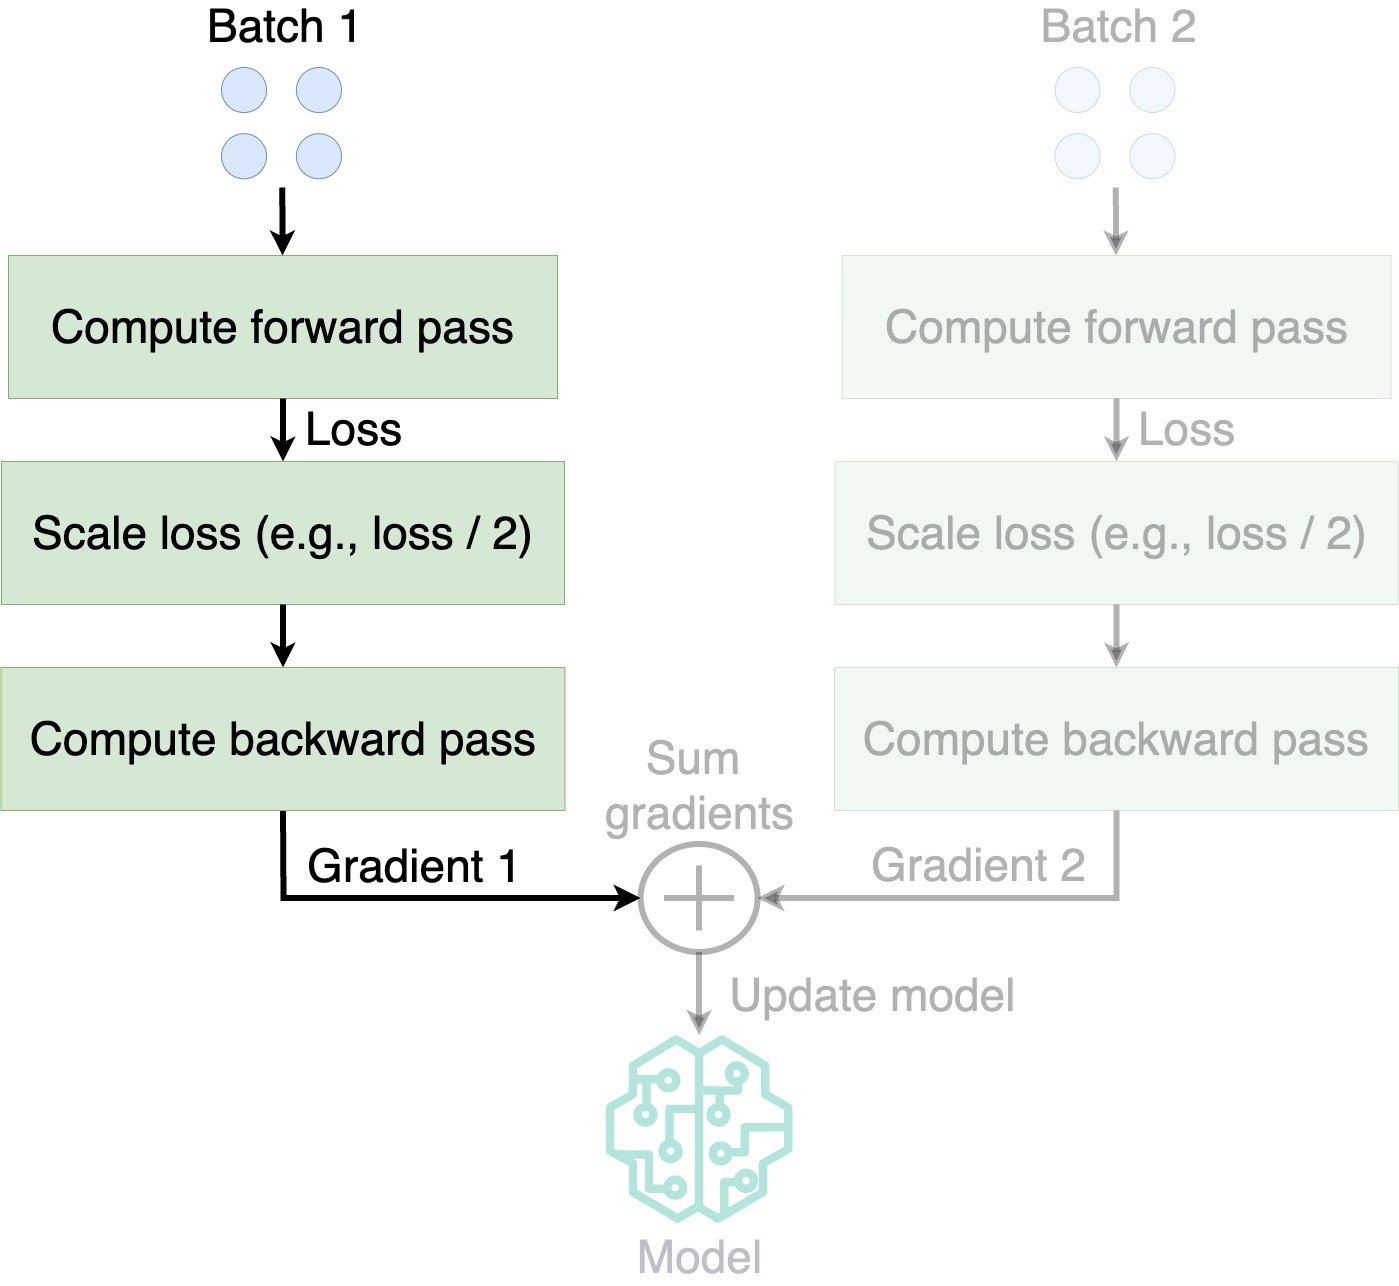
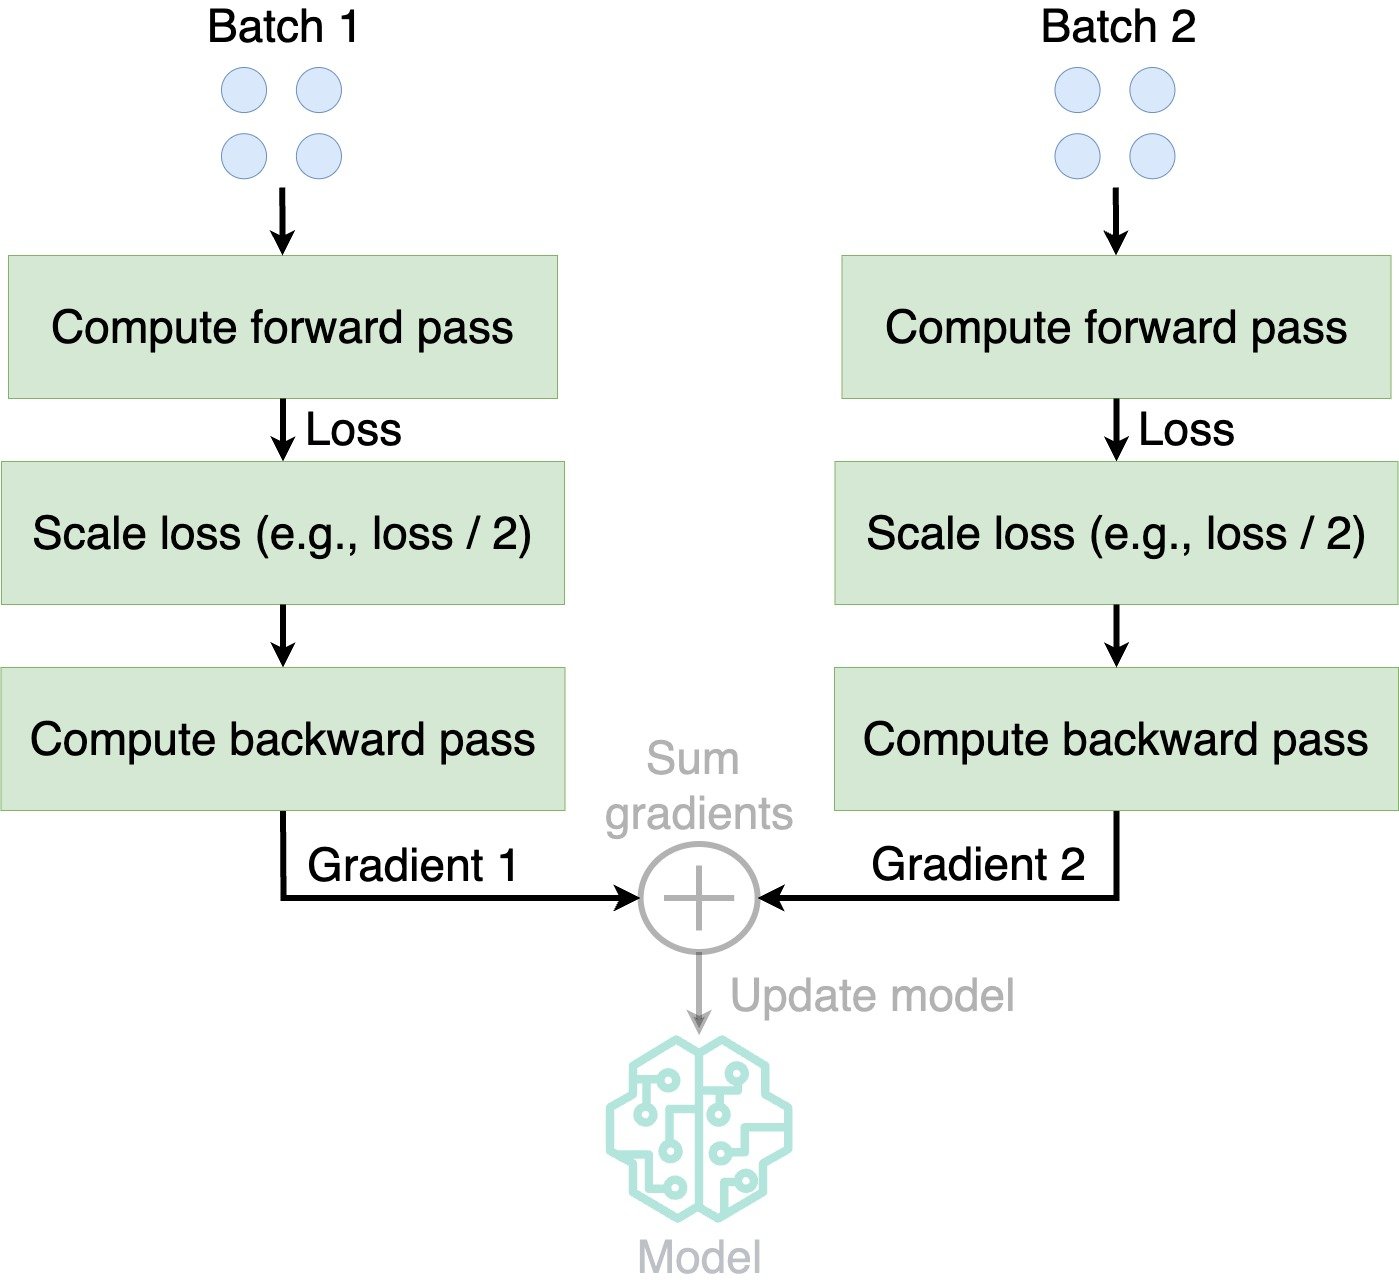
梯度累積如何運作?

示意圖:將大批次拆成較小的批次。

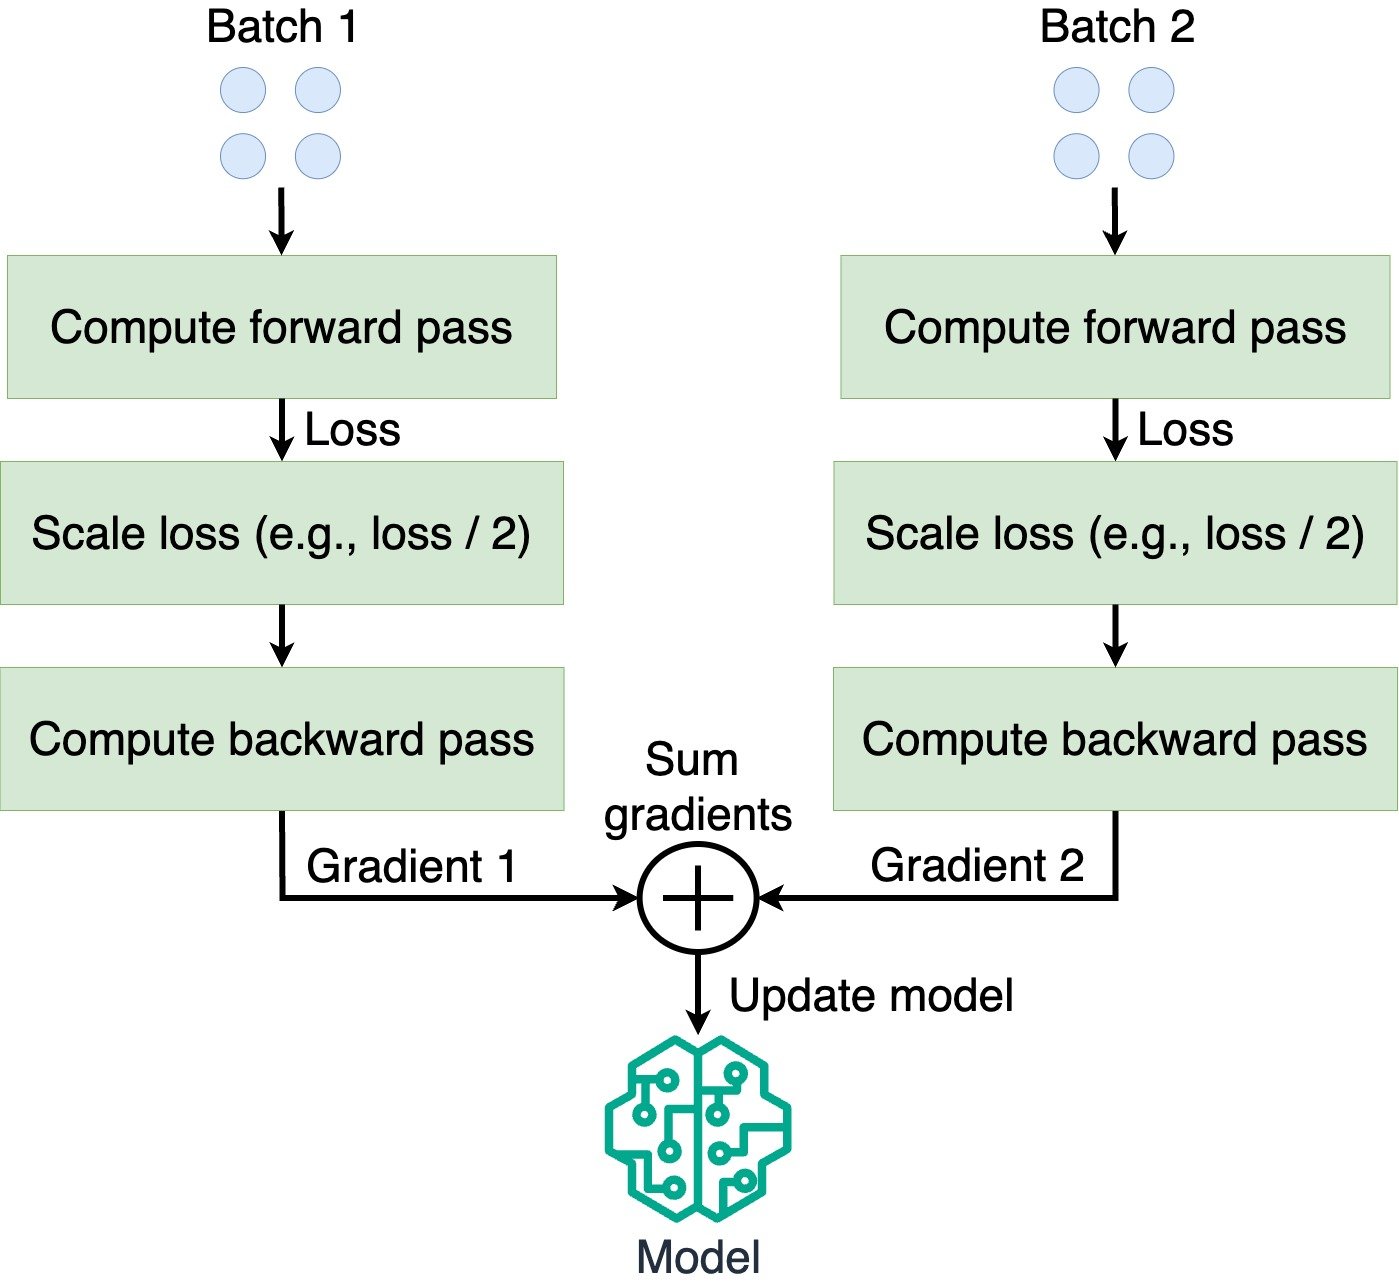
  • 梯度累積:跨小批次加總梯度
  • 等效於用大批次訓練模型
  • 加總後再更新模型參數

示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

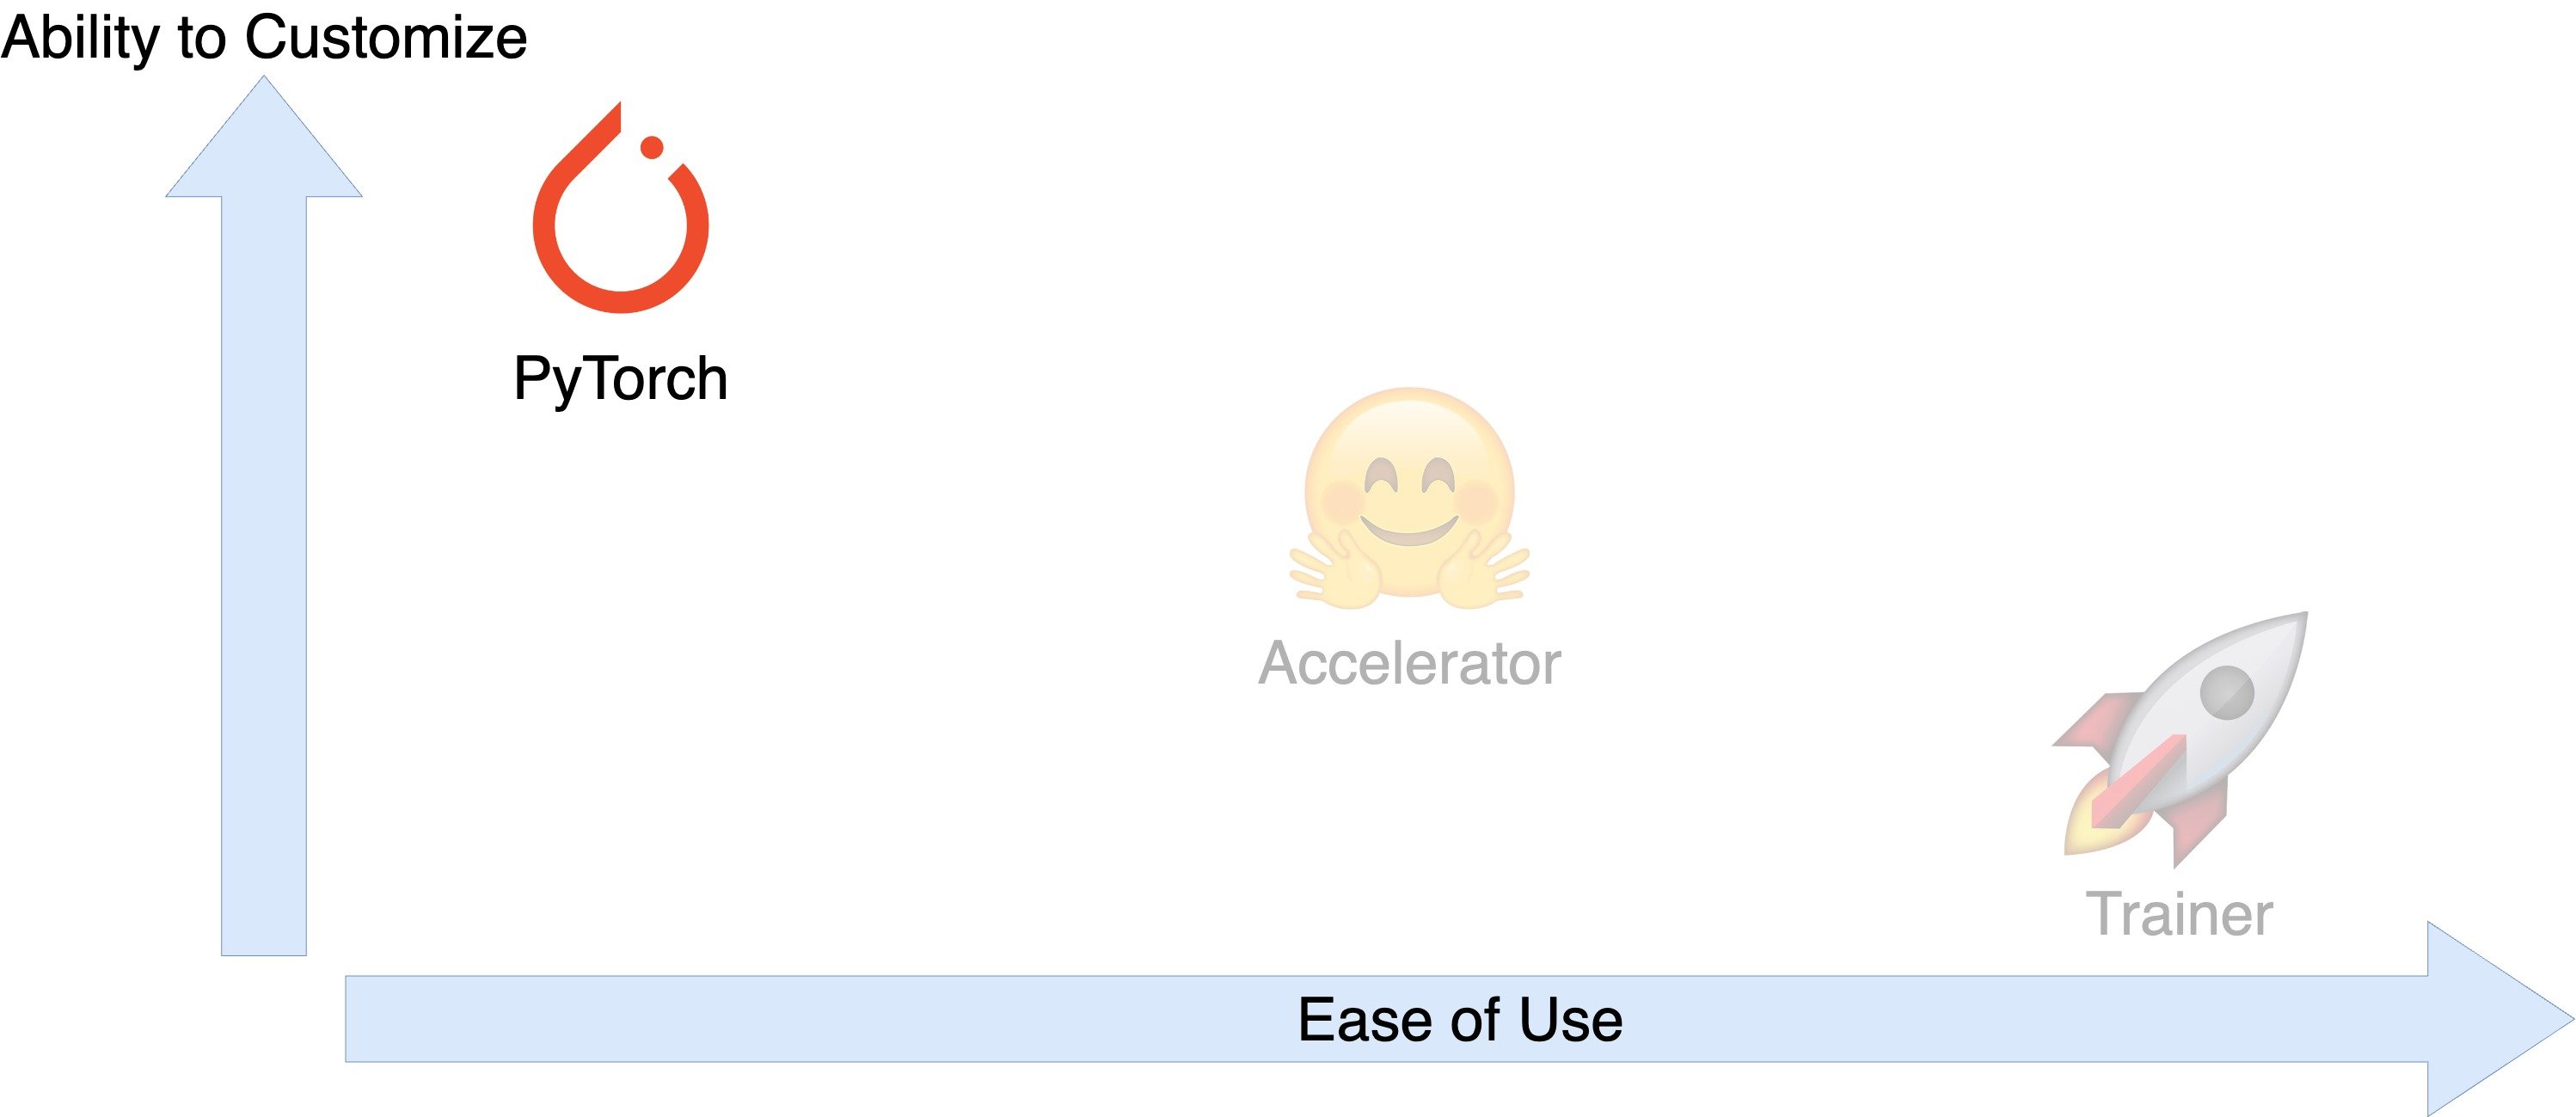
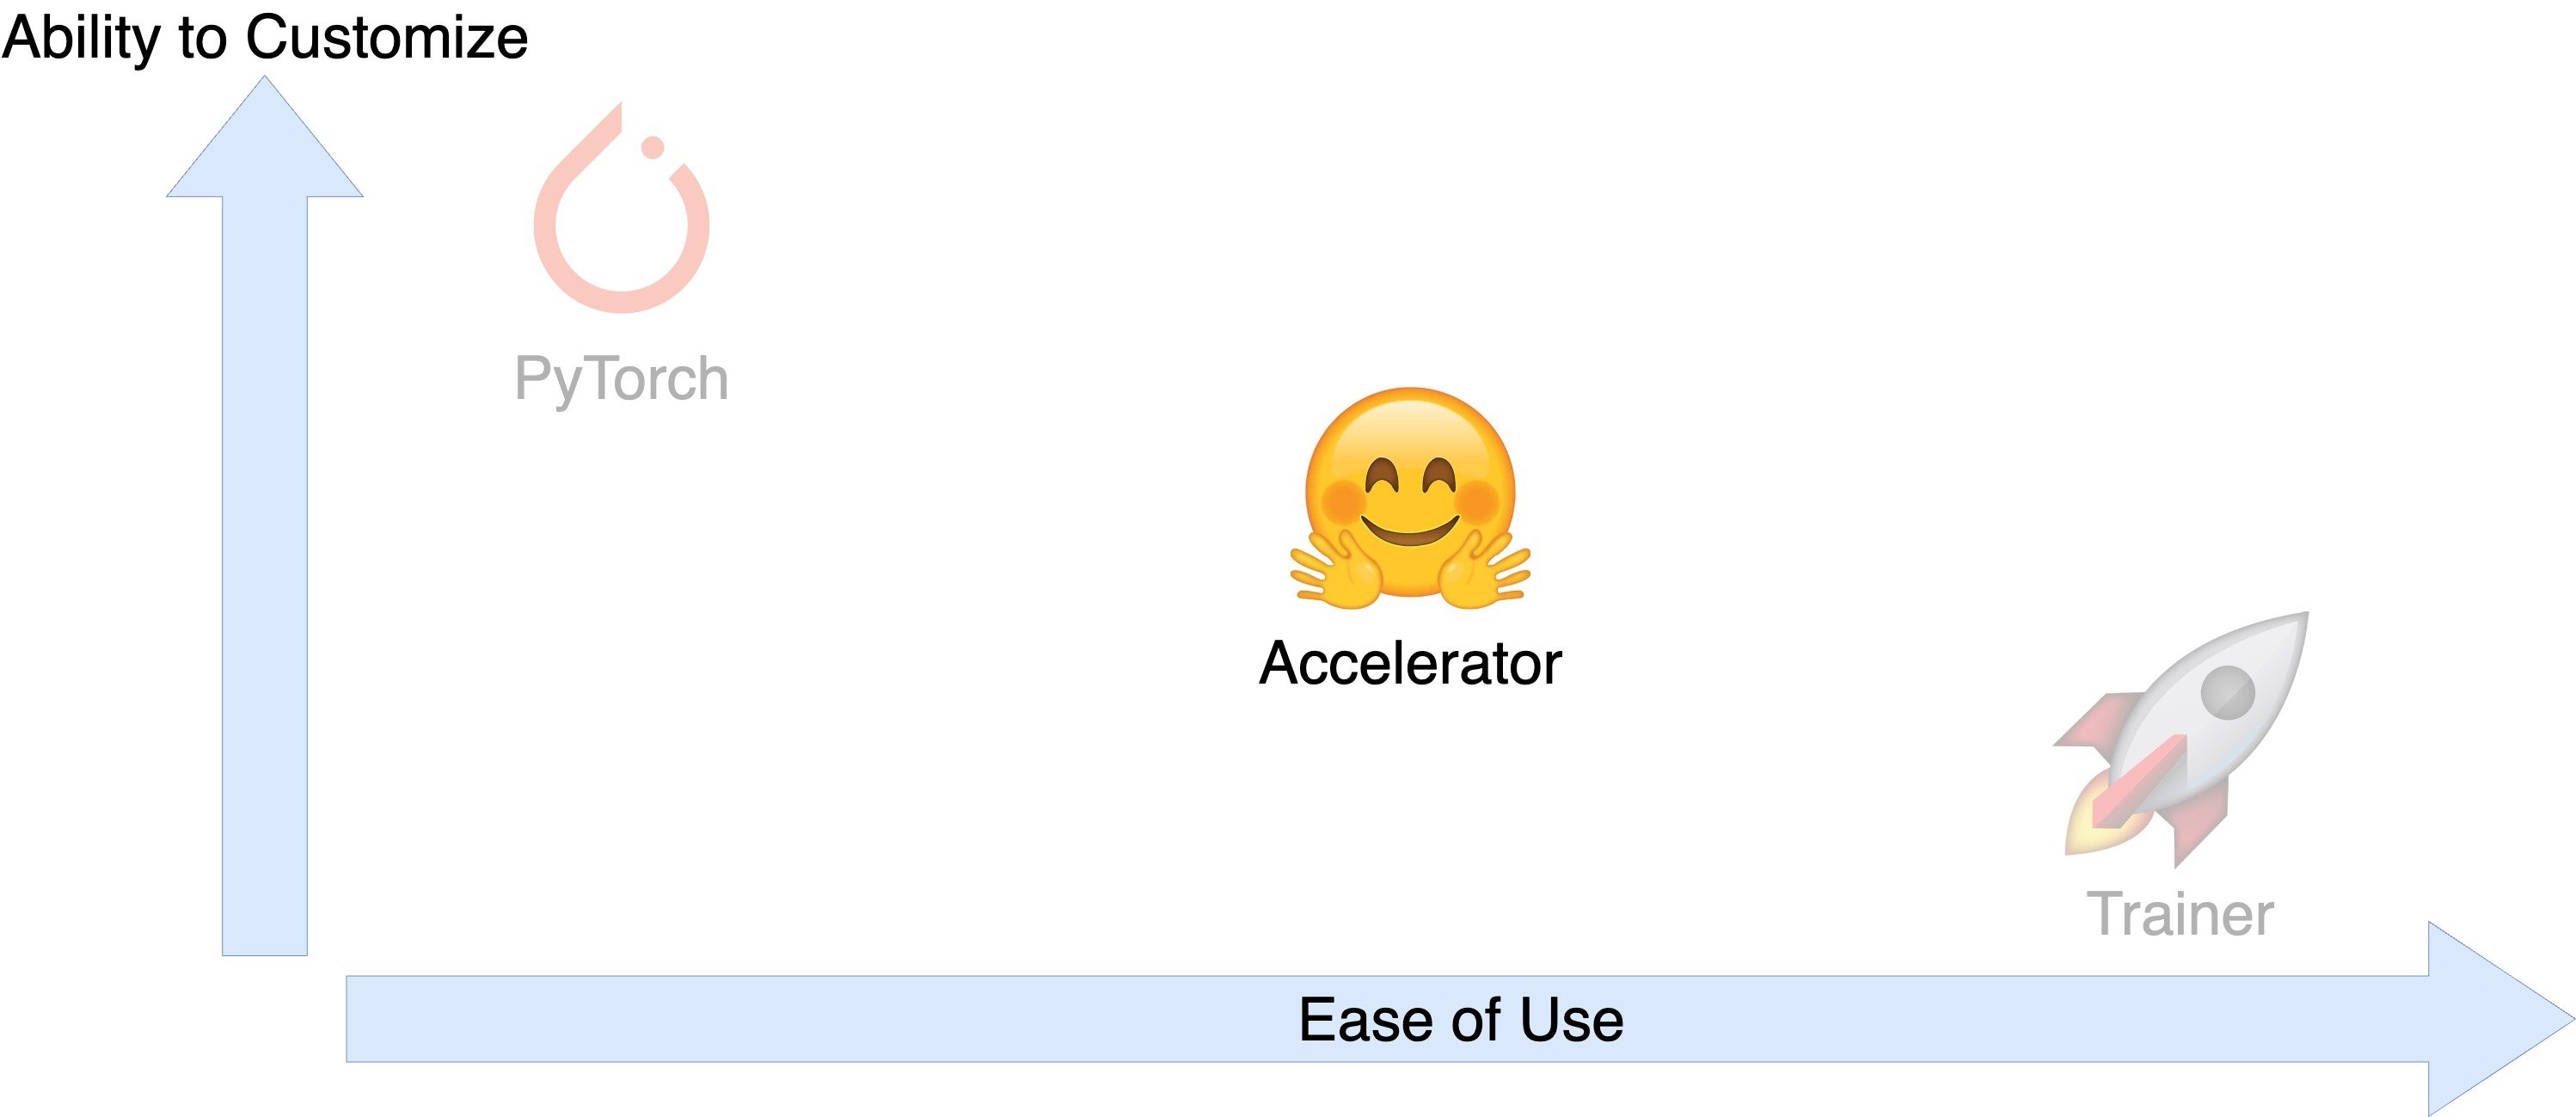
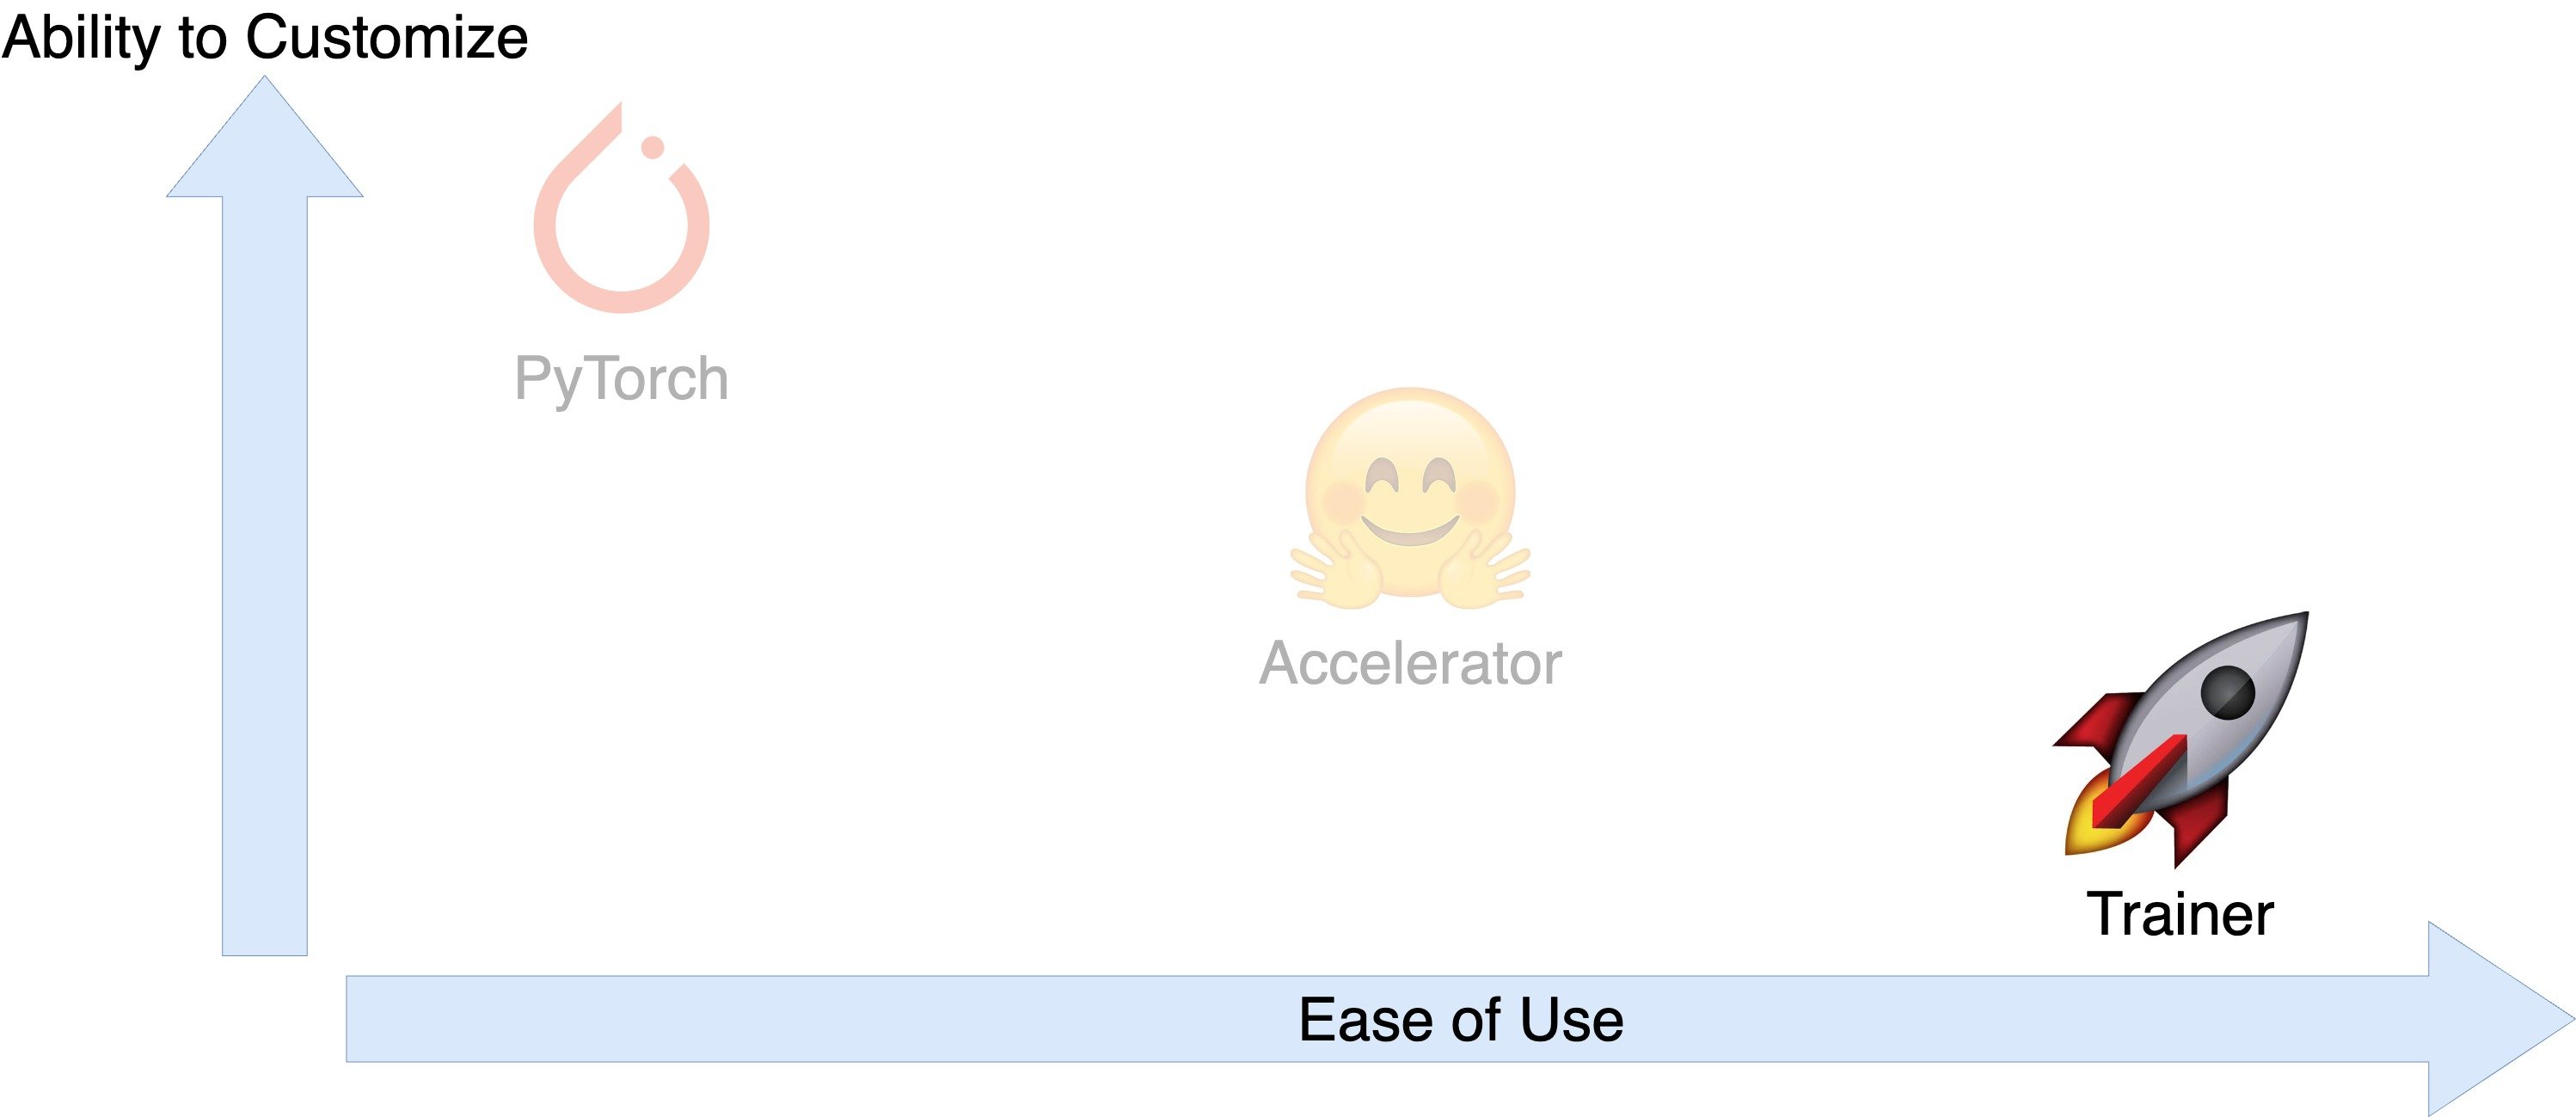
PyTorch、Accelerator 與 Trainer

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

PyTorch、Accelerator 與 Trainer

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

PyTorch、Accelerator 與 Trainer

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

在 PyTorch 中進行梯度累積

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

在 PyTorch 中進行梯度累積

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

在 PyTorch 中進行梯度累積

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

在 PyTorch 中進行梯度累積

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps
    loss.backward()


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

在 PyTorch 中進行梯度累積

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps
    loss.backward()
    if ((index + 1) 
        % gradient_accumulation_steps == 0):


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

在 PyTorch 中進行梯度累積

for index, batch in enumerate(dataloader):
    inputs, targets = (batch["input_ids"], 
                       batch["labels"])
    inputs, targets = (inputs.to(device), 
                       targets.to(device))
    outputs = model(inputs, labels=targets)
    loss = outputs.loss
    loss = loss / gradient_accumulation_steps
    loss.backward()
    if ((index + 1) 
        % gradient_accumulation_steps == 0):
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

從 PyTorch 到 Accelerator

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

從 PyTorch 到 Accelerator

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

用 Accelerator 進行梯度累積

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader): inputs, targets = (batch["input_ids"], batch["labels"])

示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

用 Accelerator 進行梯度累積

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):

        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

用 Accelerator 進行梯度累積

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

用 Accelerator 進行梯度累積

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

用 Accelerator 進行梯度累積

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)


示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

用 Accelerator 進行梯度累積

accelerator = \
    Accelerator(gradient_accumulation_steps=2)

for index, batch in enumerate(dataloader):
    with accelerator.accumulate(model):
        inputs, targets = (batch["input_ids"],
                           batch["labels"])
        outputs = model(inputs, 
                        labels=targets)
        loss = outputs.loss
        accelerator.backward(loss)
        optimizer.step()
        lr_scheduler.step()
        optimizer.zero_grad()

示意圖:梯度累積為多個批次梯度的總和。

使用 PyTorch 高效訓練 AI 模型

從 Accelerator 到 Trainer

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

從 Accelerator 到 Trainer

圖表:比較 PyTorch、Accelerator 與 Trainer 的易用性與自訂能力。

使用 PyTorch 高效訓練 AI 模型

用 Trainer 進行梯度累積

training_args = TrainingArguments(output_dir="./results",
                                  evaluation_strategy="epoch",
                                  gradient_accumulation_steps=2)

trainer = Trainer(model=model, args=training_args, train_dataset=dataset["train"], eval_dataset=dataset["validation"], compute_metrics=compute_metrics)
trainer.train()
{'epoch': 1.0, 'eval_loss': 0.73, 'eval_accuracy': 0.03, 'eval_f1': 0.05}
{'epoch': 2.0, 'eval_loss': 0.68, 'eval_accuracy': 0.19, 'eval_f1': 0.25}
使用 PyTorch 高效訓練 AI 模型

一起來練習吧!

使用 PyTorch 高效訓練 AI 模型

Preparing Video For Download...