使用 PyTorch 高效訓練 AI 模型
Dennis Lee
Data Engineer, Amazon


for batch in dataloader:optimizer.zero_grad()inputs, targets = batch inputs = inputs.to(device) targets = targets.to(device)outputs = model(inputs)loss = outputs.lossloss.backward()optimizer.step() scheduler.step()
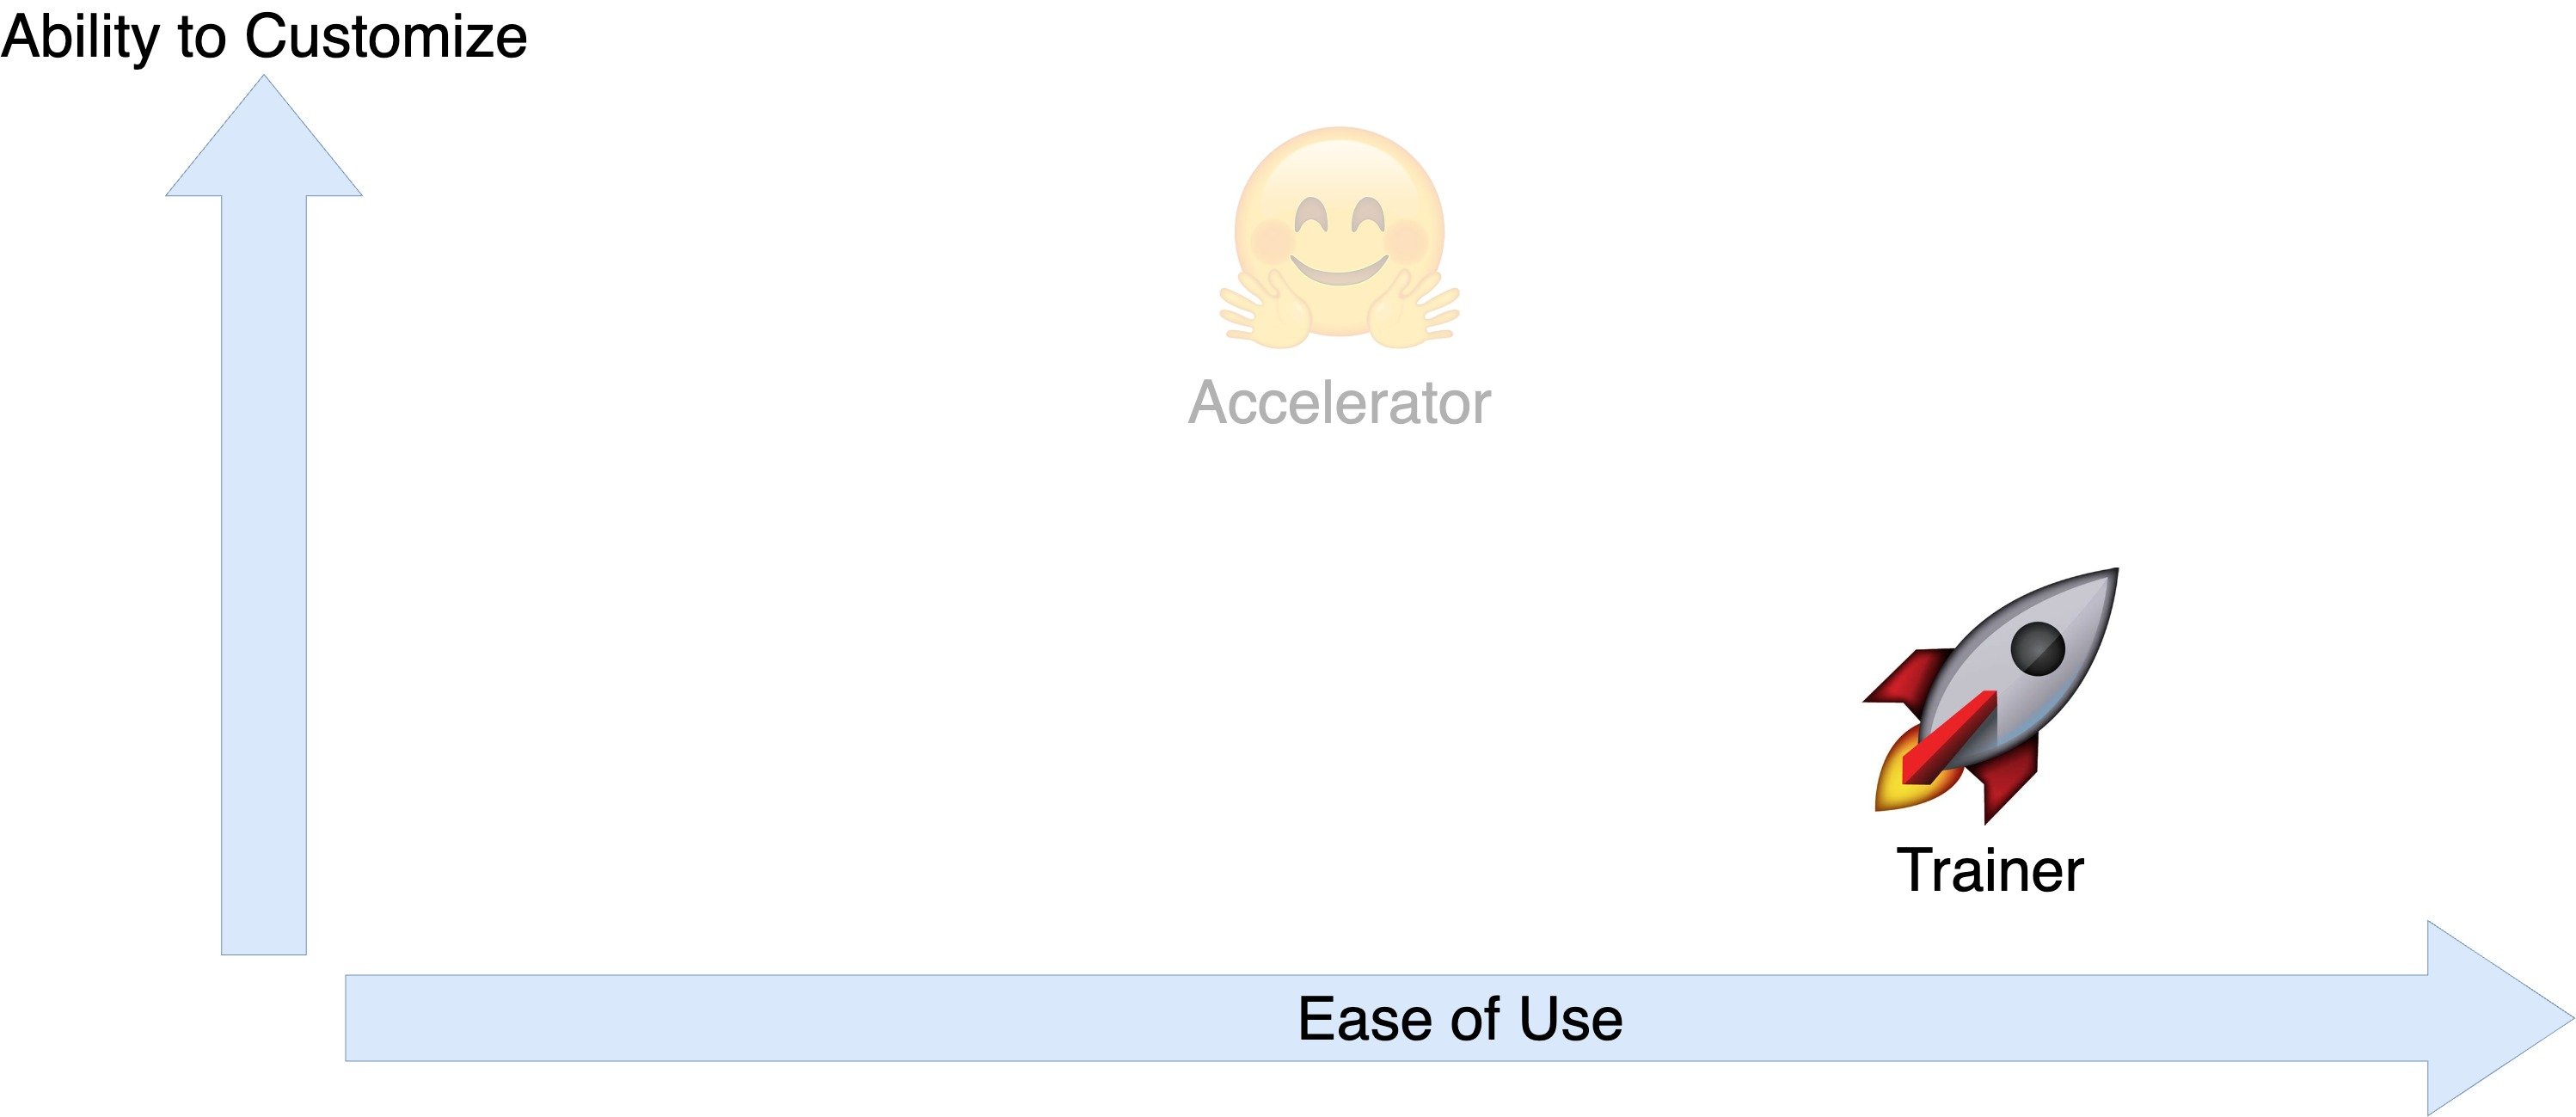
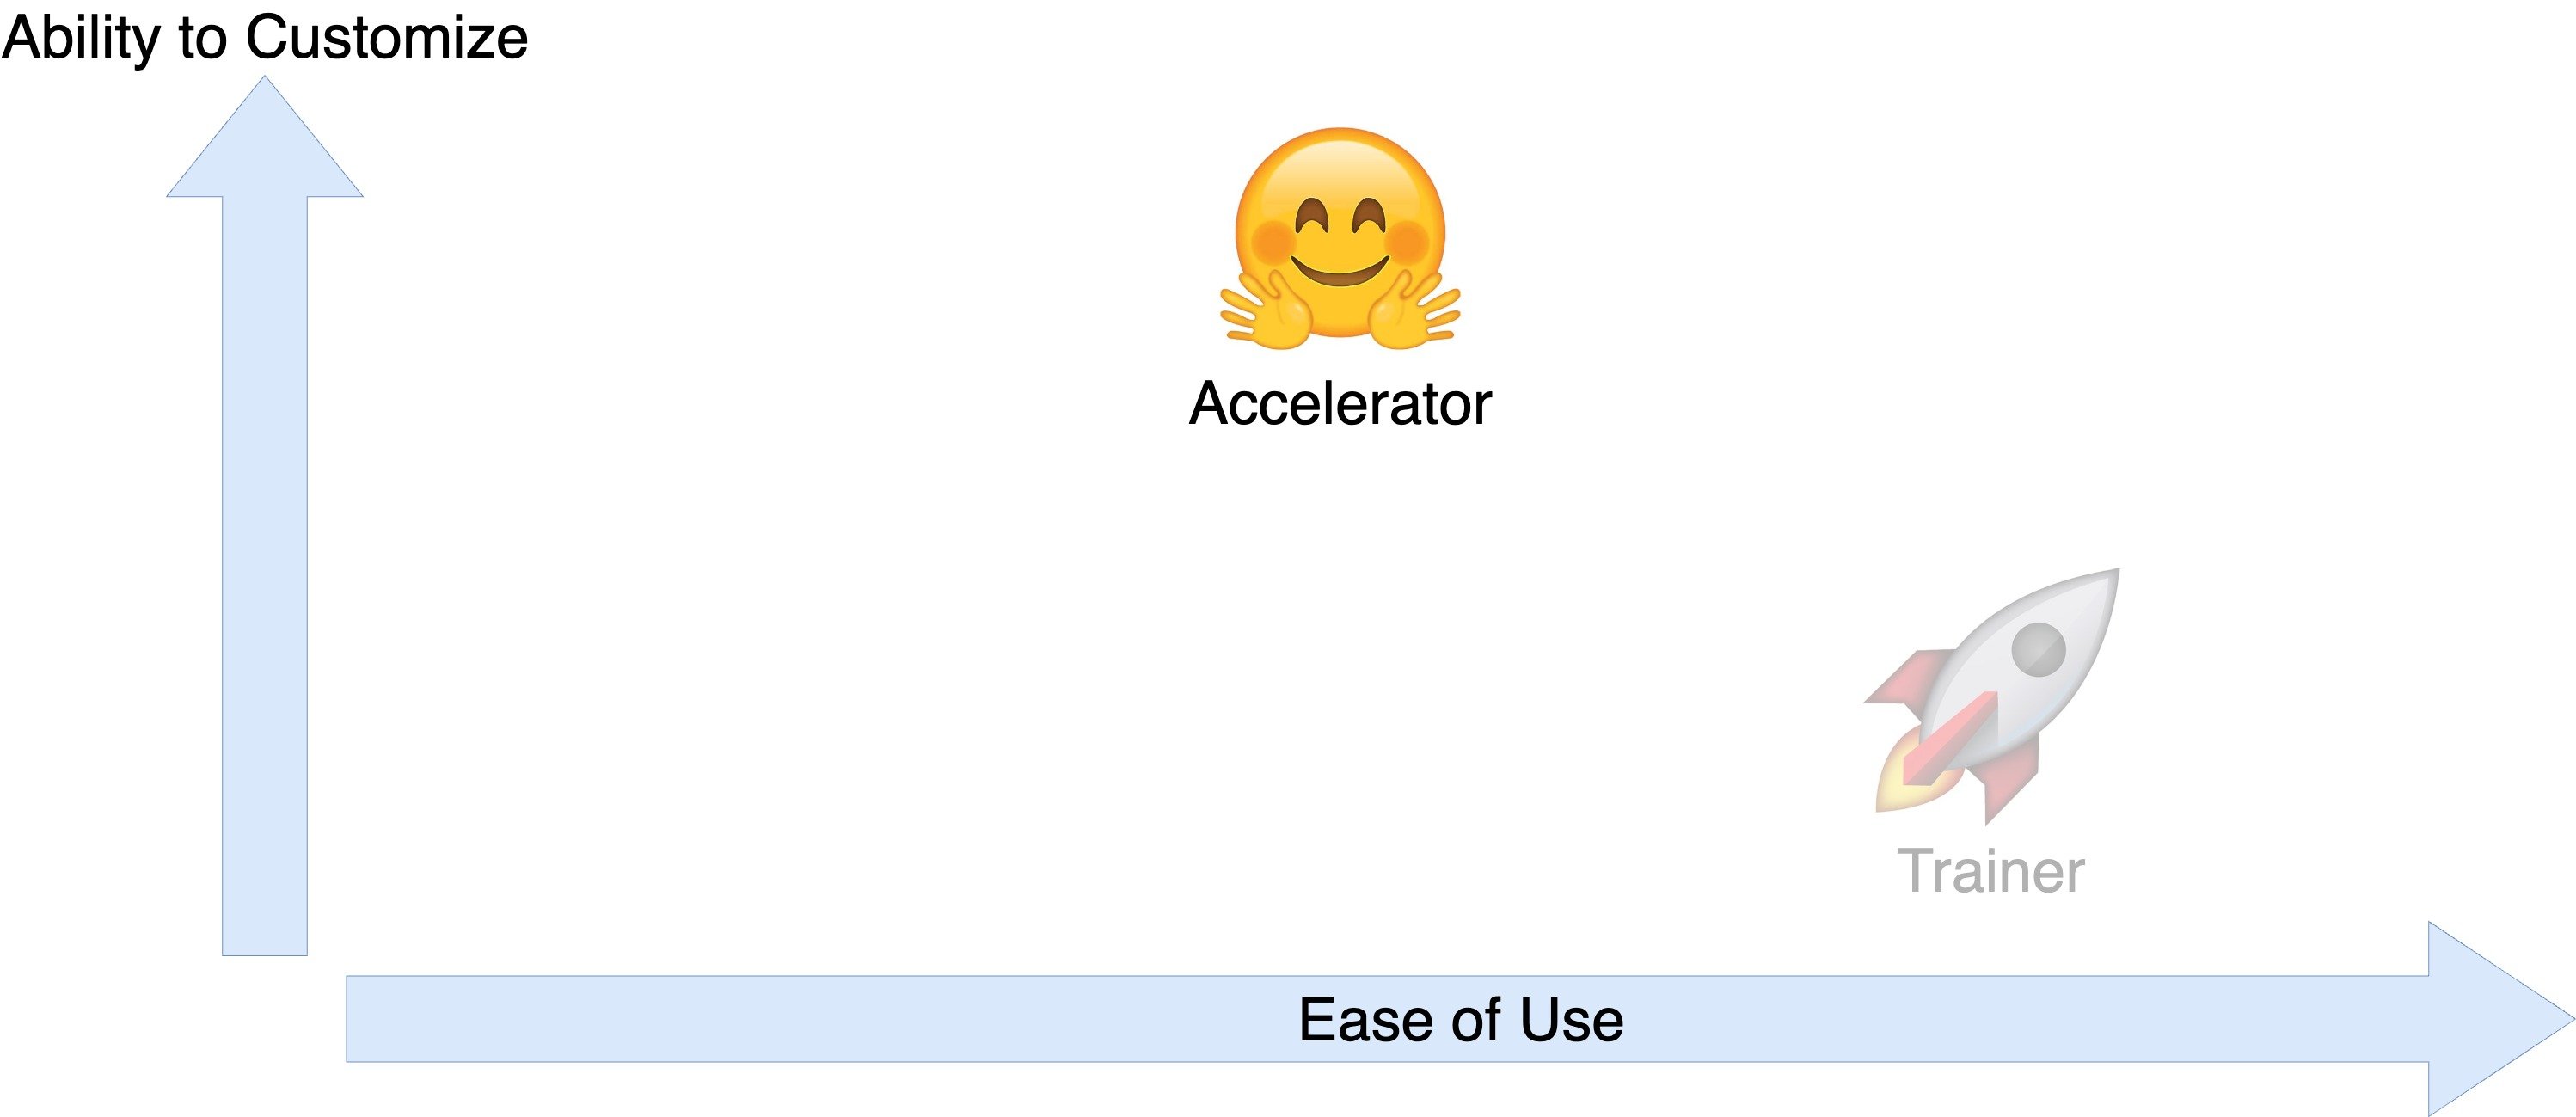
.to(device)Accelerator 提供分散式訓練介面from accelerate import Accelerator
accelerator = Accelerator(
device_placement=True
)
device_placement(bool,預設 True):預設自動處理裝置配置from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained(
"distilbert-base-cased", return_dict=True)
Adam 最佳化模型參數from torch.optim import Adam
optimizer = Adam(params=model.parameters(), lr=2e-5)
from transformers import get_linear_schedule_with_warmup lr_scheduler = get_linear_schedule_with_warmup( optimizer=optimizer,num_warmup_steps=num_warmup_steps,num_training_steps=num_training_steps)
optimizer(obj):PyTorch 最佳化器,如 Adamnum_warmup_steps(int):線性增加 lr 的步數,設為 int(num_training_steps * 0.1)num_training_steps(int):總訓練步數,設為 len(train_dataloader) * num_epochsprepare 方法會處理裝置配置model, optimizer, dataloader, lr_scheduler = \ accelerator.prepare(model,optimizer,dataloader,lr_scheduler)
for batch in dataloader:optimizer.zero_grad()inputs, targets = batch inputs = inputs.to(device) targets = targets.to(device)
for batch in dataloader:optimizer.zero_grad()inputs, targets = batch
for batch in dataloader:optimizer.zero_grad()inputs, targets = batchoutputs = model(inputs)loss = outputs.loss loss.backward()
for batch in dataloader:optimizer.zero_grad()inputs, targets = batchoutputs = model(inputs) loss = outputs.lossaccelerator.backward(loss)optimizer.step() scheduler.step()
accelerator 取代 loss.backward使用 Accelerator 之前
inputs.to(device)targets.to(device)loss.backward() 計算梯度使用 Accelerator 之後
accelerator.prepare(model)accelerator.prepare(dataloader)accelerator.backward(loss) 處理梯度同步使用 PyTorch 高效訓練 AI 模型