給 SAS 使用者的 R
Melinda Higgins, PhD
Research Professor/Senior Biostatistician Emory University
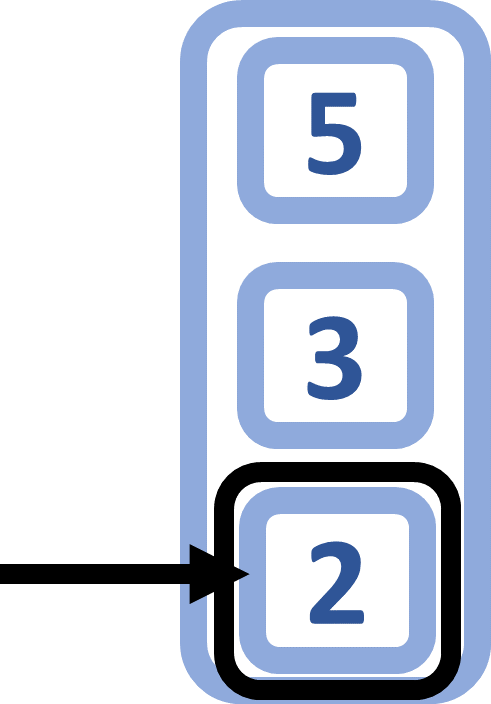
# 用 [] 從 x 選第 3 個元素
x <- c(5,3,2)
x[3]
結果
2

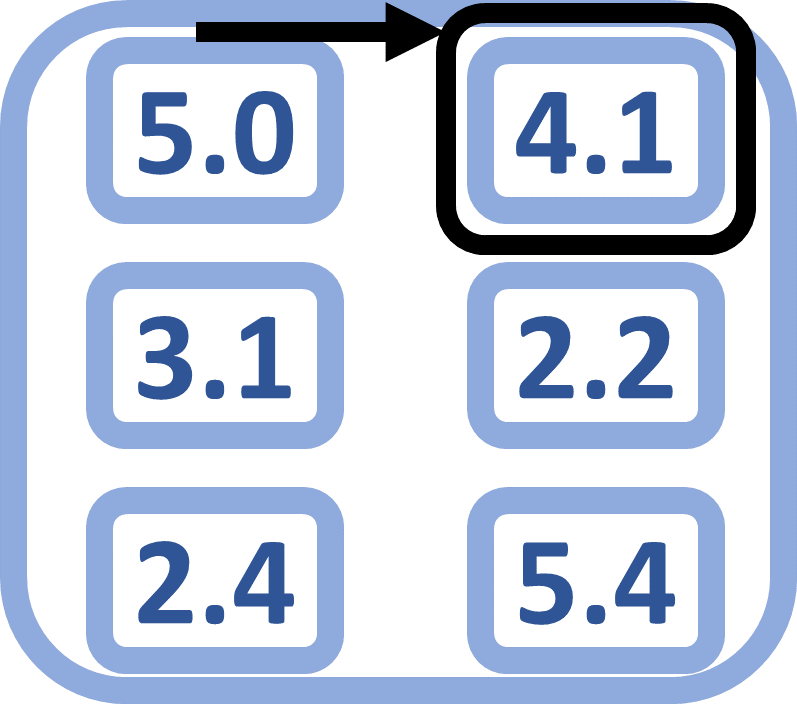
# 取第 1 列第 2 欄的值
m[1, 2]
結果
4.1

# 列留空,取第 2 欄
m[, 2]
結果
4.1 2.2 5.4

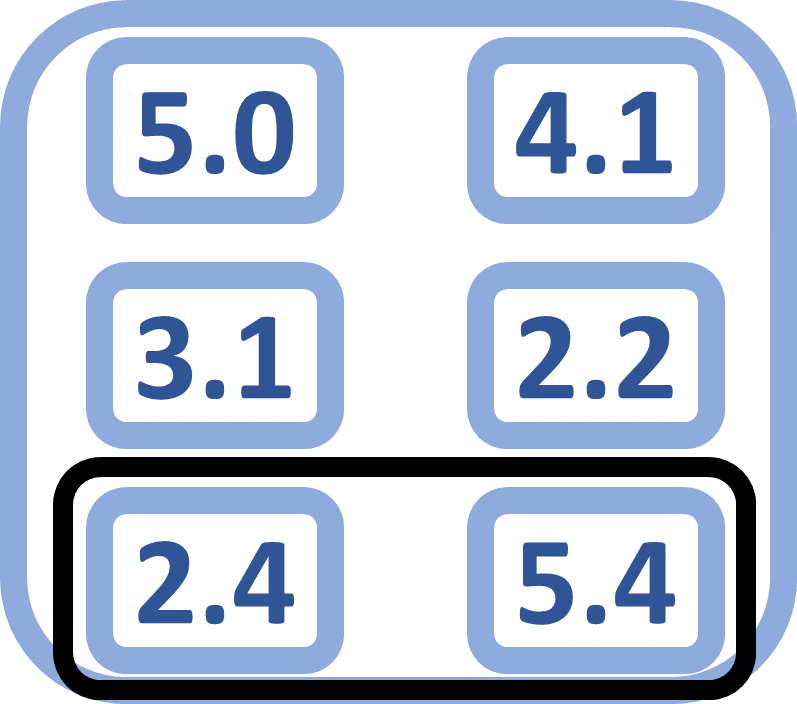
# 取第 3 列,欄留空
m[3, ]
結果
2.4 5.4

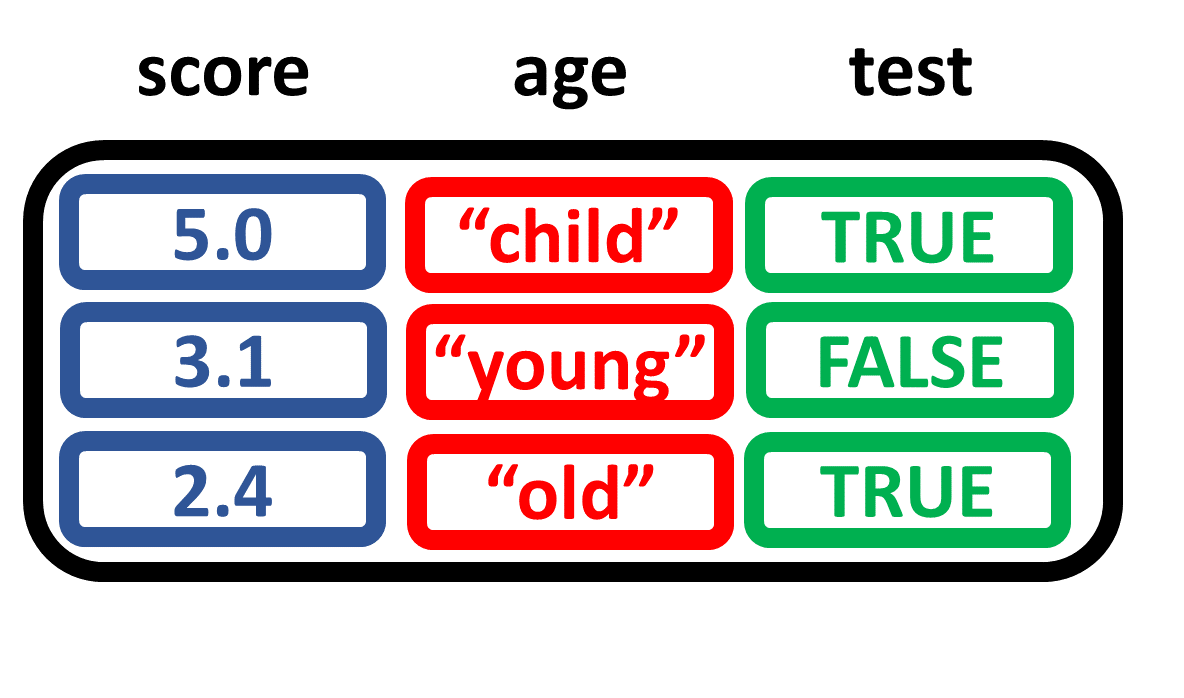
# 取第 2 列第 3 欄的元素
d[2, 3]
FALSE
# 從 d 取第 2 欄
d[, 2]
child young old
# 從 d 取第 3 列
d[3, ]
2.4 old TRUE

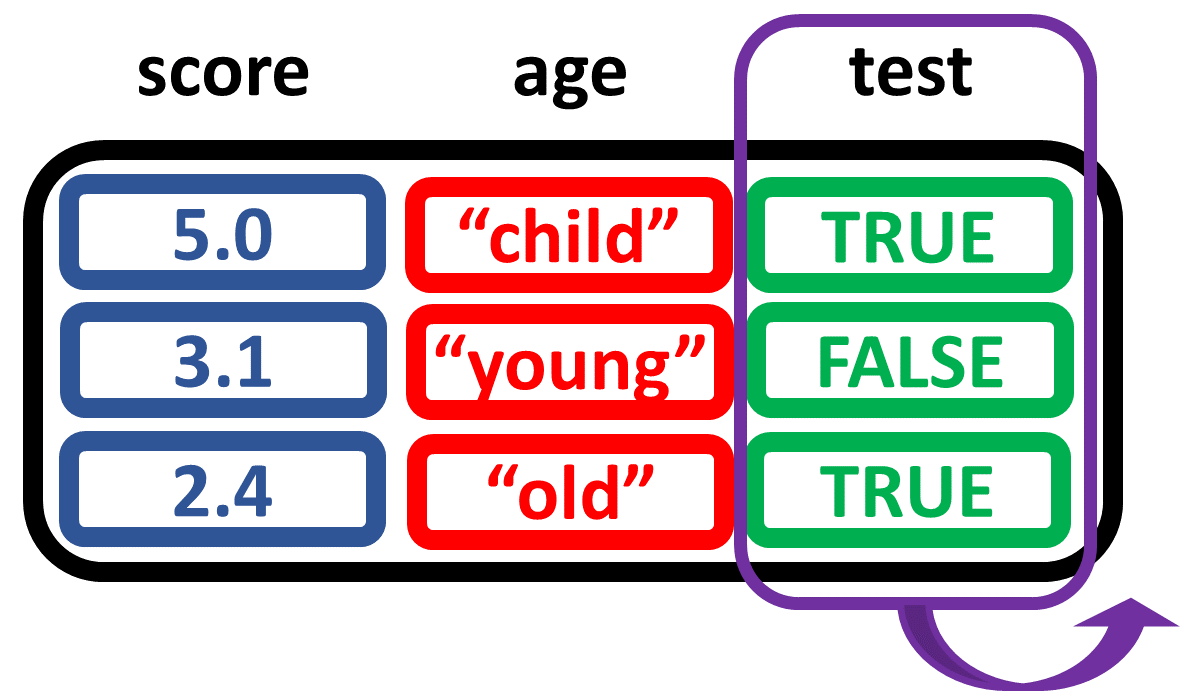
# 從 d 依名稱取變數 test
d[,"test"]
結果
[1] TRUE FALSE TRUE

# 用 pull() 取得 test 欄
d %>% pull(test)
結果
TRUE FALSE TRUE

# 用 select(),取得 age 與 test
d %>% select(age:test)
# 從 d 擷取 test 與 score
d %>% select(test, score)
age test
1 child TRUE
2 young FALSE
3 old TRUE
test score
1 TRUE 5.0
2 FALSE 3.1
3 TRUE 2.4
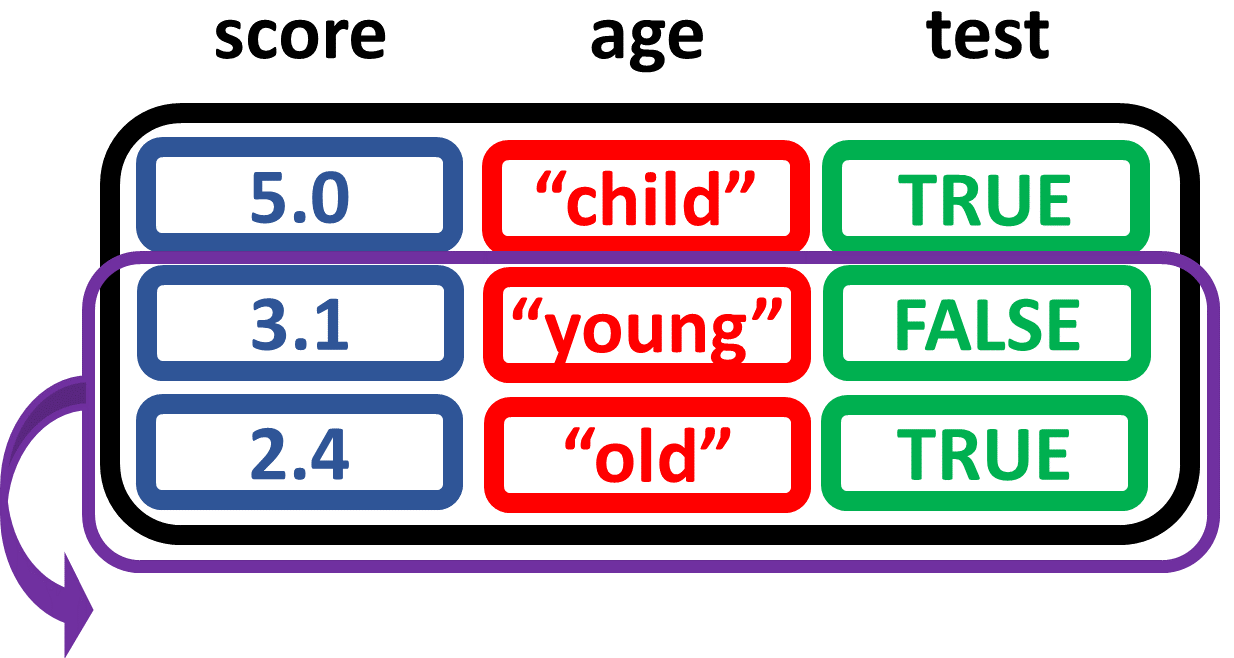
# 用 slice(),取得第 2 到第 3 列
d %>% slice(2:3)
結果
score age test
3.1 young FALSE
2.4 old TRUE

# 檢視 d
d
# 從 d 擷取第 2 列
d %>% slice(2)
# 從 d 擷取第 3 與第 1 列
d %>% slice(c(3,1))
score age test
1 5.0 child TRUE
2 3.1 young FALSE
3 2.4 old TRUE
score age test
1 3.1 young FALSE
score age test
1 2.4 old TRUE
2 5.0 child TRUE
給 SAS 使用者的 R