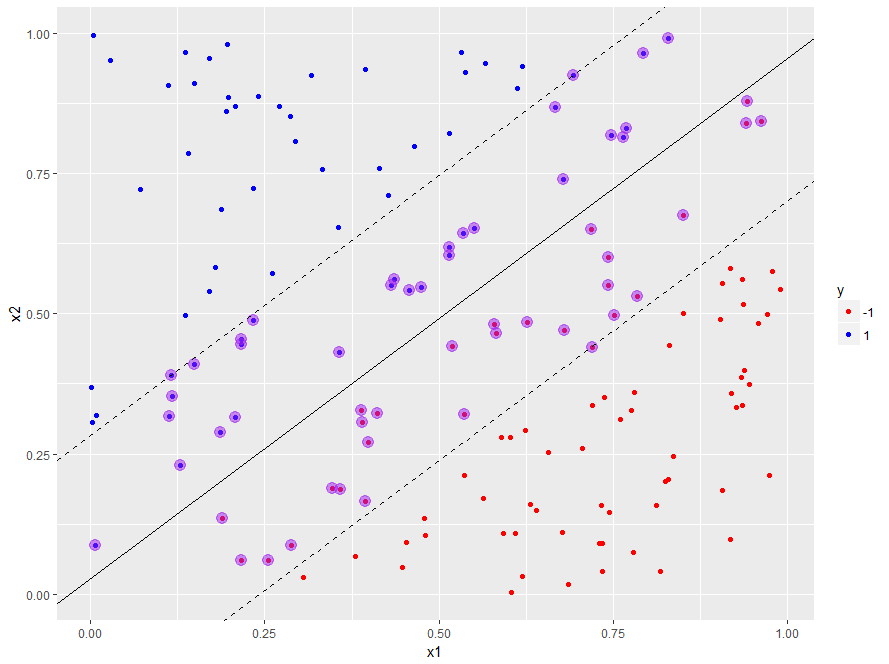
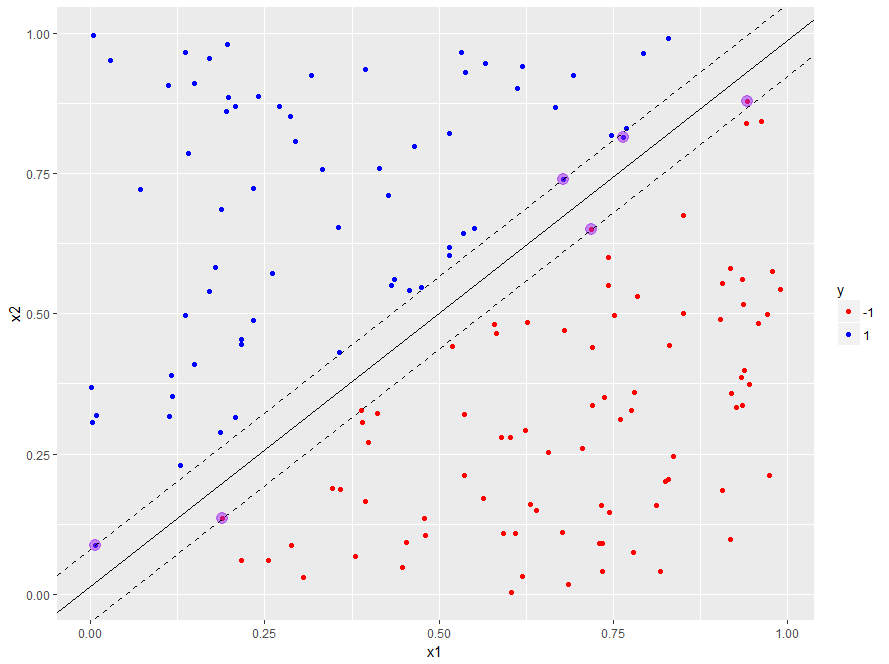
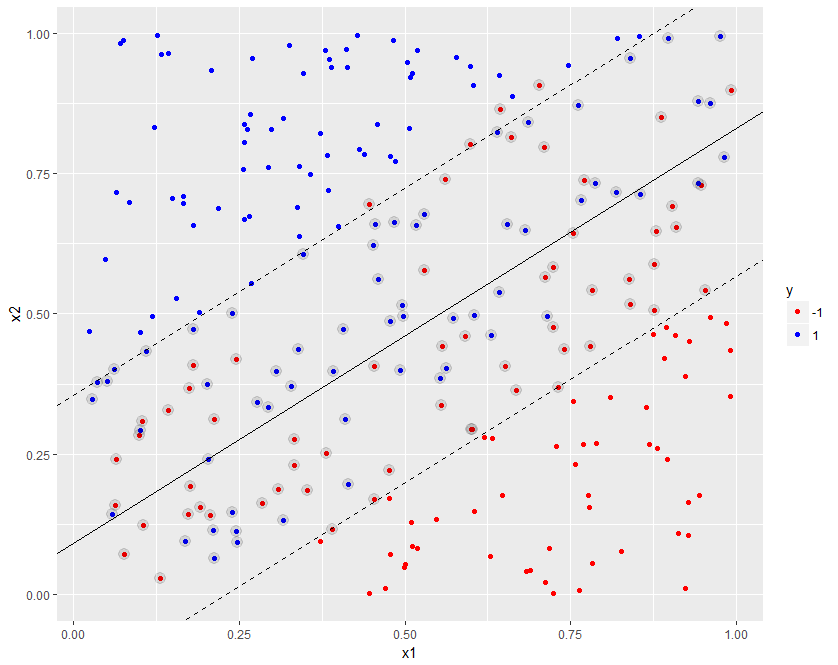
library(e1071)
svm_model <- svm(y ~ .,
                data = trainset,
                type = "C-classification",
                kernel = "linear",
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification",
    kernel = "linear",
    scale = FALSE)

Parameters:
SVM-Type:  C-classification
 SVM-Kernel:  linear
       cost:  1
      gamma:  0.5
Number of Support Vectors:  55
線性 SVM(cost = 100)
library(e1071)
svm_model <- svm(y ~ .,
                data = trainset,
                type = "C-classification",
                kernel = "linear",
                cost = 100,
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification",
    kernel = "linear",
    cost = 100,
    scale = FALSE)

Parameters:
SVM-Type:  C-classification
 SVM-Kernel:  linear
       cost:  100
      gamma:  0.5
Number of Support Vectors:  6
啟示
若已知決策邊界為線性,縮小間隔可能有用
但在實務上很少如此
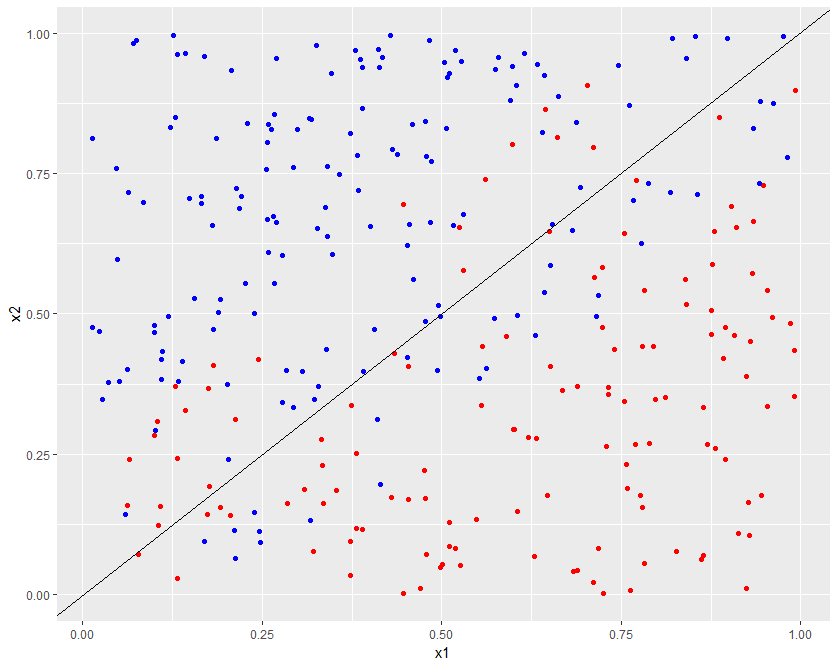
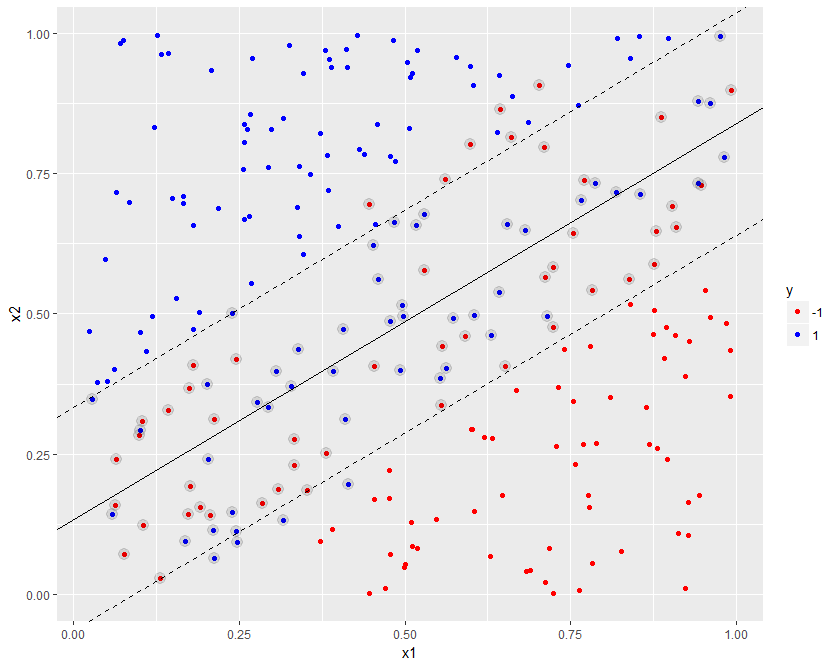
非線性資料集,線性 SVM(cost = 100)
用 80% 資料的訓練集建立 cost=100 的模型
# Build model
library(e1071)
svm_model<- svm(y ~ .,
                data = trainset,
                type = "C-classification",
                kernel = "linear",
                cost = 100,
                scale = FALSE)
計算準確率
# Train and test accuracy
pred_train <- predict(svm_model, trainset)
mean(pred_train == trainset$y)
# Trainset contains 80% of data
# Same train/test split as before.
# Build model
svm_model <- svm(y ~ .,
data = trainset,
type = "C-classification",
kernel = "linear",
cost = 1,
scale = FALSE)
計算測試準確率
# Test accuracy
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)