使用 scikit-learn 建立合成資料集

Data Privacy and Anonymization in Python

Rebeca Gonzalez

Data engineer

用 Scikit-learn 產生資料集

  • 我們可以從機率分佈取樣來建立資料集

  • 例如常態分佈

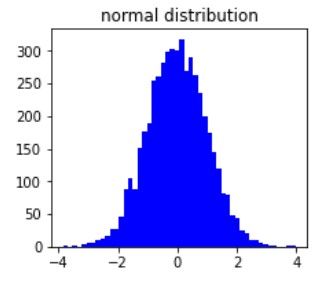
常態分佈直方圖示意

Data Privacy and Anonymization in Python

常態分佈

自然界常見

  • 身高
  • 血壓
  • IQ 分數

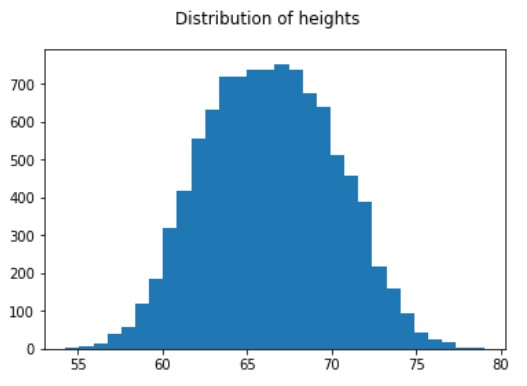
大型資料集中身高值的常態分佈直方圖

Data Privacy and Anonymization in Python

從常態分佈取樣

import numpy as np


# 建立新的 pandas DataFrame new_measures = pd.DataFrame()
# 選擇樣本的平均(中心)與標準差 mean = 65 standard_deviation = 2
# 產生樣本 new_measures['Height'] = np.random.normal(mean, standard_deviation, 10000)
Data Privacy and Anonymization in Python

從常態分佈取樣

# 繪製直方圖以查看身高分佈
new_measures['Height'].hist(bins=50)
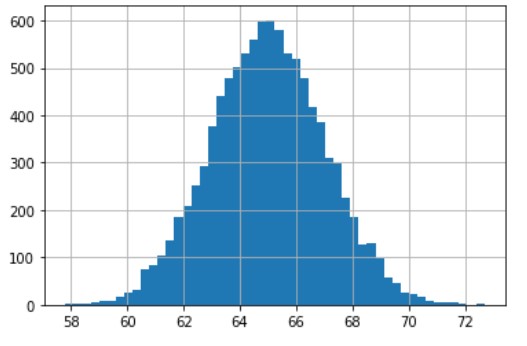
結果資料的直方圖

Data Privacy and Anonymization in Python

使用 scikit-learn 建立資料集

Scikit-learn 提供簡單好用的函式來產生可用於:

  • 分類
  • 分群
  • 迴歸
Data Privacy and Anonymization in Python

分類與分群的合成資料

make_classification()

  • 會配置常態分佈的點群
  • 可建立相關與無資訊的特徵

make_blobs()

  • 可更精細控制群心與標準差
Data Privacy and Anonymization in Python

分類的合成資料

# 從 sklearn.datasets 匯入 make_classification
from sklearn.datasets import make_classification


# 產生樣本與其標籤 x, y = make_classification(n_samples=1000,
n_classes=2,
n_informative=2,
n_features=4,
n_clusters_per_class=2,
class_sep=1)
Data Privacy and Anonymization in Python

分類的合成資料

# 查看生成的資料與標籤
print(x.shape)
print(y.shape)
print(x)
(1000, 4)
(1000,)
[[ 1.22914870e+00 -2.62386795e+00  2.25878743e+00  2.55377055e+00]
 [-1.10279812e+00 -1.15816087e+00  1.55571279e+00  7.80565898e-02]
 [ 2.65581977e-03 -2.33278818e+00  2.37837858e+00  1.57533194e+00]
 ...
 [ 4.51006972e-01  7.53435745e-01 -9.21597108e-01 -2.20659747e-01]
 [ 5.31925876e-01  7.42210504e-01 -9.37625248e-01 -1.61488855e-01]
 [ 1.62862108e+00 -2.72435345e+00  2.22562940e+00  2.87628246e+00]]
Data Privacy and Anonymization in Python

分類的合成資料

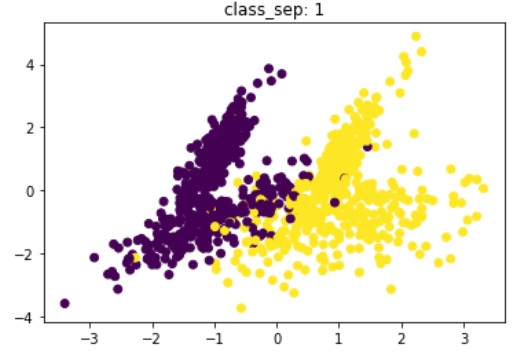
生成的雙類別資料集之資料點散佈圖

Data Privacy and Anonymization in Python

分類的合成資料

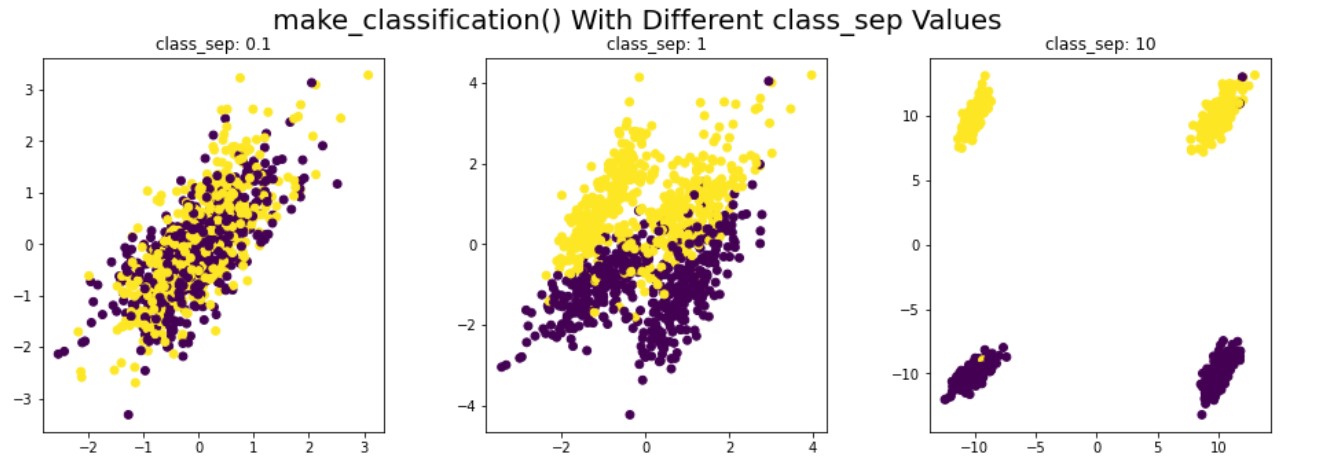
三張圖顯示不同 class_sep 對資料點的影響:左側點群重疊,中間適中,右側分離明顯

Data Privacy and Anonymization in Python

分群的合成資料

# 匯入產生分群資料集的 datasets 模組
from sklearn.datasets import make_blobs


# 指定標準差數值 standard_deviation = 1.5
# 產生資料與標籤 x, labels = make_blobs(n_features=3, centers=4, cluster_std=standard_deviation)
# 查看生成資料的形狀 print(x.shape)
(100, 3)
Data Privacy and Anonymization in Python

分群的合成資料

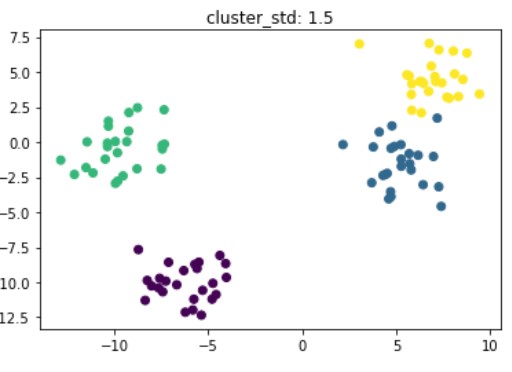
結果分群資料點散佈圖,每群一種顏色;4 個群心對應 4 群

Data Privacy and Anonymization in Python

分群的合成資料

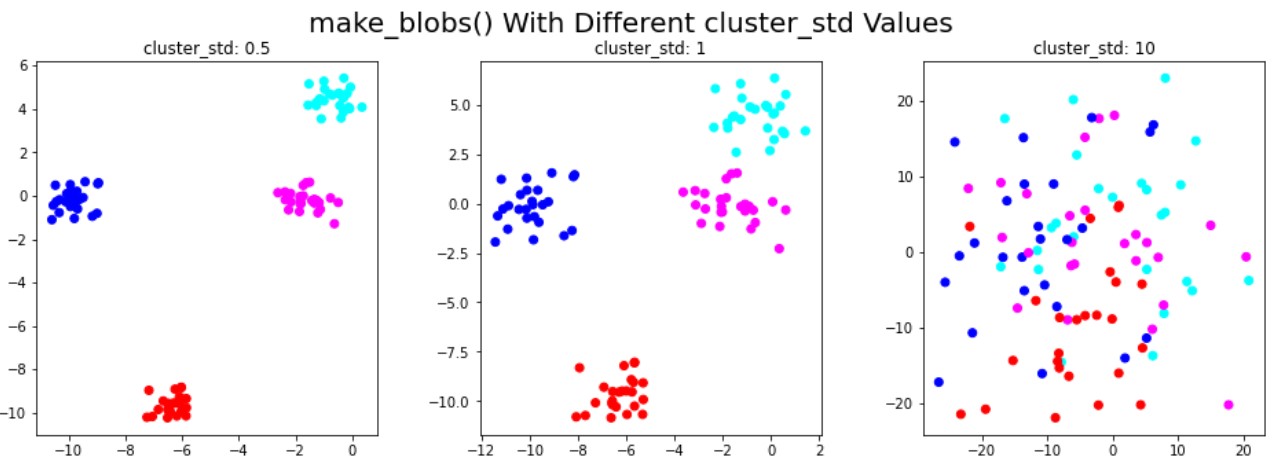
三張圖示範標準差如何影響生成的資料點:左側點群緊靠群心,右側分散程度高。

Data Privacy and Anonymization in Python

一起來練習吧!

Data Privacy and Anonymization in Python

Preparing Video For Download...